Physique, Chimie et Informatique > Terminales Spé. NSI > Révisions de notions de 1ère
Revisions sur la structure de liste en Python
Exercice 1
Écrire une fonction qui reçoit comme argument une liste de nombres à virgule et recherche lequel est le plus grand et lequel est le plus petit.
La spécification de la fonction est la suivante :
defminmax(liste:list[float])->tuple[float]:"""
Retourne un tuple constitué des valeurs minimale
et maximale de la liste
"""
Solution
defminmax(liste:list[float])->tuple[float]:"""
Retourne un tuple constitué des valeurs minimale
et maximale de la liste
"""val_min=liste[0]val_max=liste[0]foriinrange(1,len(liste)-1):ifliste[i]>val_max:val_max=liste[i]ifliste[i]<val_min:val_min=liste[i]returnval_min,val_max
Exercice 2
Écrire une fonction qui reçoit comme argument une liste et détermine le nombre d’éléments dans la liste.
Ne pas utiliser la fonction len du langage.
La spécification de la fonction est la suivante :
deflongueur(liste:list[float])->int:"""
Retourne le nombre d'éléments dans la
liste
"""
Solution
deflongueur(liste:list[float])->int:"""
Retourne le nombre d'éléments dans la
liste
"""longueur=0foriinrange(len(liste)):longueur+=1returnlongueur
Exercice 3
Écrire une fonction qui simule le tirage du Loto. Pour rappel, il s’agit de tirer aléatoirement 6 entiers compris entre 1 et 49.
Remarque. Un numéro ne peut apparaître qu’une seule fois. Il est donc nécessaire de stocker le résultat de chaque tirage dans une liste et de vérifier s’il est présent ou pas.
La spécification de la fonction est la suivante :
defloto()->list[int]:"""
Simule le tirage du Loto. retourne une liste de 6 entiers compris
entre 1 et 49.
"""
Solution
defloto()->list[int]:"""
Simule le tirage du Loto. retourne une liste de 6 entiers compris
entre 1 et 49.
"""tirages=[]nbre_valeurs=6whilelen(tirages)<=nbre_valeurs:tirage=randint(1,49)iftiragenotintirages:tirages.append(tirage)returntirages
Exercice 4
Écrire une fonction qui reçoit une liste de notes comprises entre 0 et 20 comme argument et retourne la moyenne de ces notes et le pourcentage de ces notes comprises dans les intervalles : [0, moy - 3], [moy - 3, moy + 3] et [moy + 3, 20] où moy est la valeur moyenne des notes.
La signature de la fonction est :
defstatistiques(notes:List[float])->Tuple[float]:"""
Détermine les statistiques des notes reçues
en argument : moyenne et notes comprises dans
les intervalles [0, moy - 3[, [moy - 3, moy + 3[,
[moy + 3, 20]
"""
Cette fonction doit utiliser les deux fonctions de signature :
defmoyenne(liste_notes:List[float])->float:"""
Détermine la moyenne des notes reçues en
argument dans la liste passée en argument.
"""
et
defnombre_dans_intervalle(liste:List[float],valeur_min:float,valeur_max:float)->float:"""
Détermine le nombre de valeurs de liste
comprises dans l'intervalle [val_min, val_max[.
"""
Exercice 5
Écrire une fonction qui, partir de deux points de l’espace à trois dimensions, calcule la distance euclidienne entre ces deux points.
Remarque. Les coordonnées d’un point sont stockées dans un tuple.
La spécification de la fonction est :
defdistance(pt1:tuple[float],pt2:tuple[float])->float:"""
Détermine la distance entre les points pt1 et
pt2.
ERREUR si les dimensions des tuples ne
correspondent pas.
"""
Exercice 6
Reprendre l’exercice précédent et considérer que les points appartiennent à un espace de dimension N (N étant potentiellement grand).
La spécification de la fonction est :
defdistanceN(pt1:Tuple[float],pt2:Tuple[float])->float:"""
Détermine la distance entre les points pt1 et
pt2.
ERREUR si les dimensions des tuples ne
correspondent pas.
"""
Solution
frommathimportsqrtdefdistanceN(pt1:tuple[float],pt2:tuple[float])->float:"""
Détermine la distance entre les points pt1 et
pt2.
ERREUR si les dimensions des tuples ne
correspondent pas.
"""iflen(pt1)!=len(pt2):raiseException("Les dimensions ne correspondent pas !")carre_distance:float=0foriinrange(len(pt1)):carre_distance+=(pt2[i]-pt1[i])**2returnsqrt(carre_distance)
Exercice 7
Écrire une fonction qui retourne une la table de multiplication de tous les nombres entiers compris entre 0 et n sous forme d’une liste de listes.
La spécification de la fonction est :
deftable_multiplication(n:int)->list[list[int]]:"""
Détermine la table de multiplication de tous les
entiers compris entre 1 et n.
>>> table_multiplication(4)
[[1, 2, 3, 4], [2, 4, 6, 8], [3, 6, 9, 12], [4, 8, 12, 16]]
"""
Solution
deftable_multiplication(n:int)->list[list[int]]:"""
Détermine la table de multiplication de tous les
entiers compris entre 1 et n.
>>> table_multiplication(4)
[[1, 2, 3, 4], [2, 4, 6, 8], [3, 6, 9, 12], [4, 8, 12, 16]]
"""table=[]foriinrange(1,n+1):ligne=[]forjinrange(1,n+1):ligne.append(i*j)table.append(ligne)returntable
Physique, Chimie et Informatique > Terminales Spé. NSI > Révisions de notions de 1ère
Revisions sur les strucures de boucle en Python
Travail à effectuer
Exercice 1
Écrire et exécuter une fonction qui retourne une chaîne de caractères formée par une suite des 10 premiers termes de la table de multiplication d’un entier a passé en argument.
La spécification de la fonction est :
defmultiplication(a:int)->str:"""
Retourne une chaîne de caractères formées des 10 premiers
nombres de la table de multiplication de a.
>>> multiplication(7)
'7 14 21 28 35 42 49 56 63 70 '
"""
Solution
defmultiplication(a:int)->str:"""
Retourne une chaîne de caractères formées des 10 premiers
nombres de la table de multiplication de a.
>>> multiplication(7)
'7 14 21 28 35 42 49 56 63 70 '
"""chaine_retour=""nbre_tours_boucle=10# for i in range(1, nbre_tours_boucle + 1):# chaine_retour += str(a * i)# chaine_retour += " "i=1whilei<=nbre_tours_boucle:chaine_retour+=str(a*i)chaine_retour+=" "i+=1returnchaine_retour
Exercice 2
Écrire et exécuter une fonction qui retourne une chaîne de caractères formée par une suite des 10 premiers termes de la table de multiplication d’un entier a passé en argument en signalant au passage (à l’aide d’un astérisque) ceux qui sont des multiples de 3.
La spécification de la fonction est :
defmultiplication_multiple_trois(a:int)->str:"""
Retourne une chaîne de caractères formées des 10 premiers
nombres de la table de multiplication de a en signalant au
passage ceux qui sont des multiples de 3.
>>> multiplication_multiple_trois(2)
'2 4 6* 8 10 12* 14 16 18* 20 '
>>> multiplication_multiple_trois(7)
'7 14 21* 28 35 42* 49 56 63* 70 '
"""
Solution
defmultiplication_multiple_trois(a:int)->str:"""
Retourne une chaîne de caractères formées des 10 premiers
nombres de la table de multiplication de a en signalant au
passage ceux qui sont des multiples de 3.
>>> multiplication_multiple_trois(2)
'2 4 6* 8 10 12* 14 16 18* 20 '
>>> multiplication_multiple_trois(7)
'7 14 21* 28 35 42* 49 56 63* 70 '
"""chaine_retour=""nbre_tours_boucle=10foriinrange(1,nbre_tours_boucle+1):resultat_multiplication=a*ichaine_retour+=str(resultat_multiplication)ifresultat_multiplication%3==0:chaine_retour+="*"chaine_retour+=" "returnchaine_retour
Exercice 3
Écrire et exécuter une fonction qui calcule les 50 premiers termes de la table de multiplication d’un nombre a passé en argument mais qui retourne une chaîne de caractères formée seulement par ceux qui sont des multiples de 7.
La spécification de la fonction est :
defmultiplication_multiple_sept(a:int)->str:"""
Calcule les 50 premiers termes de la table de a mais retourne
une chaîne de caractères contenant uniquement les multiples de 7.
>>> multiplication_multiple_sept(2)
'14 28 42 56 70 84 98 '
>>> multiplication_multiple_sept(9)
'63 126 189 252 315 378 441 '
"""
Solution
defmultiplication_multiple_sept(a:int)->str:"""
Calcule les 50 premiers termes de la table de a mais retourne
une chaîne de caractères contenant uniquement les multiples de 7.
>>> multiplication_multiple_sept(2)
'14 28 42 56 70 84 98 '
>>> multiplication_multiple_sept(9)
'63 126 189 252 315 378 441 '
"""chaine_retour=""nbre_tours_boucle=50foriinrange(1,nbre_tours_boucle+1):resultat_multiplication=a*iifresultat_multiplication%7==0:chaine_retour+=str(resultat_multiplication)chaine_retour+=" "returnchaine_retour
Exercice 4
Écrire et exécuter une fonction qui calcule et retourne une chaîne de caractères formée de la liste des diviseurs du nombre passé en argument.
La spécification de la fonction est :
defdiviseurs(a:int)->str:"""
Retourne une chaîne de caractères formée de la liste des diviseurs
de a.
>>> diviseurs(18)
'18 9 6 3 2 1 '
"""
Solution
defdiviseurs(a:int)->str:"""
Retourne une chaîne de caractères formée de la liste des diviseurs
de a.
>>> diviseurs(18)
'18 9 6 3 2 1 '
"""chaine_retour=""diviseur_possible=a# while diviseur_possible >= 1:# if a % diviseur_possible == 0:# chaine_retour += str(diviseur_possible)# chaine_retour += " "# diviseur_possible -= 1foriinrange(a,0,-1):# i est diviseur possibleifa%i==0:chaine_retour+=str(i)chaine_retour+=" "returnchaine_retour
Exercice 5
Écrire une fonction qui retourne une chaîne de caractère formée des 10 premiers termes de la table de multiplication de 1 à 10. Le caractère de passage à la ligne \n doit être utilisé afin de séparer les différentes tables (de 2, de 3, etc.).
Remarque : Utiliser deux boucles imbriquées.
La spécification de la fonction est :
deftable_multiplication()->str:"""
Retourne la table de multiplication des nombres de 1 à 10.
"""
Solution
deftable_multiplication()->str:"""
Retourne la table de multiplication des nombres de 1 à 10.
"""chaine_retour=""nbre_termes=10foriinrange(1,nbre_termes+1):forjinrange(1,nbre_termes+1):chaine_retour+=str(i*j)chaine_retour+=" "chaine_retour+="\n"returnchaine_retour
Remarque : Afin de visualiser le résultat sous forme d’un tableau, utiliser l’instruction suivante, dans la console, pour tester la fonction :
>>>print(table_multiplication())
Exercice 6
Écrire et exécuter une fonction qui demande 10 nombres à l’utilisateur et qui détermine lequel est le plus grand et lequel est le plus petit. Les deux résultats sont retournés au sein d’une unique chaîne de caractères.
Remarque : la fonction qui permet de récupérer du texte entré au clavier est input :
valeur=float(input("Entrez votre valeur : "))
La specification de la fonction est :
defplus_grand_plus_petit()->str:"""
Demande à l'utilisateur d'entrer 10 valeurs et retourne une
chaîne de caractères formée des deux valeurs max et min.
"""
Solution
defplus_grand_plus_petit()->str:"""
Demande à l'utilisateur d'entrer 10 valeurs et retourne une
chaîne de caractères formée des deux valeurs max et min.
"""nbre_tours=10valeur_max=float("-inf")# Plus petite valeur possiblevaleur_min=float("inf")# Plus grande valeur possibleforiinrange(1,nbre_tours+1):valeur=float(input(f"Entrez la valeur {i} : "))ifvaleur>valeur_max:valeur_max=valeurifvaleur<valeur_min:valeur_min=valeurreturnf"Min : {valeur_min}, Max : {valeur_max}"
Exercice 7
Reprendre l’exercice précédent mais en faisant en sorte que le nombre de valeurs demandées à l’utilisateur soit passé en argument à la fonction.
Solution
defplus_grand_plus_petit(nbre_tours:int)->str:"""
Demande à l'utilisateur d'entrer 10 valeurs et retourne une
chaîne de caractères formée des deux valeurs max et min.
"""valeur_max=float("-inf")# Plus petite valeur possiblevaleur_min=float("inf")# Plus grande valeur possibleforiinrange(1,nbre_tours+1):valeur=float(input(f"Entrez la valeur {i} : "))ifvaleur>valeur_max:valeur_max=valeurifvaleur<valeur_min:valeur_min=valeurreturnf"Min : {valeur_min}, Max : {valeur_max}"
Exercice 8
Écrire et exécuter une fonction qui demande à l’utilisateur d’entrer 10
notes et qui retourne la moyenne de ces notes.
La spécification de la fonction est :
defmoyenne()->float:"""
Demande 10 notes à l'utilisateur et retourne la moyenne.
"""
Solution
defmoyenne()->float:"""
Demande 10 notes à l'utilisateur et retourne la moyenne.
"""nbre_notes=10total_notes=0foriinrange(nbre_notes):note=float(input(f"Entrez la note {i+1} : "))total_notes+=notereturntotal_notes/nbre_notes
Exercice 9
Modifier le programme précédent de façon à ce que le nombre de notes à prendre en compte soit passé en argument de la fonction.
Solution
defmoyenne(nbre_notes:int)->float:"""
Demande 10 notes à l'utilisateur et retourne la moyenne.
"""total_notes=0foriinrange(nbre_notes):note=float(input(f"Entrez la note {i+1} : "))total_notes+=notereturntotal_notes/nbre_notes
Exercice 10
Modifier le programme précédent de façon à ce que l’utilisateur n’ait pas à indiquer le nombre de notes qu’il souhaite saisir. Une note négative terminer la saisie.
Remarque : la fonction doit afficher le nombre de notes saisies.
Solution
defmoyenne_auto()->tuple[int,float]:"""
Demande des notes à l'utilisateur tant que ce dernier
ne rentre pas une note négative.
Retourne le nombre de notes et la moyenne.
"""nbre_notes=0total_notes=0stop=Falsewhilenotstop:note=float(input(f"Entrez la note {nbre_notes+1} : "))ifnote<0:stop=Trueelse:total_notes+=notenbre_notes+=1return(nbre_notes,total_notes/nbre_notes)
Exercice 11
Écrire et exécuter une fonction qui simule un tirage du Loto.
La spécification de la fonction est
Remarque. Normalement, lorsqu’un numéro est tiré, il ne peut pas apparaître à nouveau. On acceptera cependant qu’un même numéro puisse apparaitre plusieurs fois puisqu’on ne connaît pas encore de structure de contrôle qui permet de facilement « stocker » plusieurs valeurs.
Écrire et exécuter une fonction qui tire au hasard un nombre entier compris entre 1 et 50 et demande à l’utilisateur de le deviner.
Cette fonction doit indiquer à l’utilisateur si sa tentative est trop grande ou trop petite et quitter dès l’instant où il a deviné le nombre en indiquant le nombre de tentatives.
Remarque. La fonction ne doit rien retourner, elle doit utiliser la fonction print pour afficher à l’écran les informations. Sa spécification est
defdevine()->None:"""
Déterminer aléatoirement un nombre compris en 1 et 50 et demande à l'utilisateur de le deviner.
La fonction affiche des messages qui aident l'utilisateur dans recherche et quitte dès que cette dernière est fructueuse.
"""
Solution
defdevine()->None:"""
Déterminer aléatoirement un nombre compris en 1 et 50 et demande à l'utilisateur de le deviner.
La fonction affiche des messages qui aident l'utilisateur dans recherche et quitte dès que cette dernière est fructueuse.
"""nbre_a_deviner=randint(1,50)nbre_tentatives=0trouve=Falsewhilenottrouve:proposition=int(input("Entrez votre proposition : "))nbre_tentatives+=1ifproposition==nbre_a_deviner:trouve=Trueelifproposition>nbre_a_deviner:print("La proposition est trop grande !")else:print("La proposition est trop petite !")print(f"Nombre de tentatives : {nbre_tentatives}")
Exercice 13
Écrire et exécuter une fonction qui affiche l’alphabet à l’endroit si elle reçoit l’argument "croissant" ou à l’envers si elle reçoit l’argument "decroissant".
Remarque. On peut obtenir le code décimal d’un caractère à l’aide de la fonction ord. À l’opposé, le caractère correspondant à un entier naturel dans la table ASCII est obtenu (si possible) à l’aide de la fonction chr.
La spécification de la fonction est
defalphabet(sens:str)->str:"""
Retourne les lettres de l'alphabet en fonction de la chaîne de caractères
passée en argument.
Les valeurs possibles pour cet argument sont 'croissant' ou 'decroissant'.
Code ascii [97; 122]
"""
Solution
defalphabet(sens:str)->str:"""
Retourne les lettres de l'alphabet en fonction de la chaîne de caractères
passée en argument.
Les valeurs possibles pour cet argument sont 'croissant' ou 'decroissant'.
Code ascii [97; 122]
"""ifsens=="croissant":debut_code,fin_code,increment,pas=97,122,1,1else:debut_code,fin_code,increment,pas=122,97,-1,-1rep=""foriinrange(debut_code,fin_code+increment,pas):rep+=chr(i)returnrep
Exercice 14
Écrire et exécuter une fonction qui détermine les n premiers termes de la « suite de Fibonacci » définie par :
u1u2un=1=1=u(n−1)+u(n−2) pour n>2
Cette fonction doit recevoir en argument la valeur de n et retourner la suite de nombres sous forme de chaîne de caractères. Spécification de la fonction :
deffibo(n:int)->str:"""
Retourne les n premiers termes de la suite de Fibonacci.
"""
Solution
deffibo(n:int)->str:"""
Retourne les n premiers termes de la suite de Fibonacci.
"""rep="0 1 "u=0v=1foriinrange(2,n):z=u+vrep+=str(z)+" "u=vv=zreturnrep
Physique, Chimie et Informatique > Terminales Spé. NSI > Révisions de notions de 1ère
Héron d'Alexandrie
Héron d’Alexandrie est un ingénieur, un mécanicien et un
mathématicien grec du premier siècle après J.-C.
On ne sait pas grand chose de la vie d’Héron, si ce n’est qu’il était
originaire d’Alexandrie ; les historiens se sont même longtemps
divisés sur l’époque où il a vécu. Leurs estimations allaient
du 1er siècle avant J.-C. au 3ème siècle de
notre ère. Aujourd’hui, la querelle est éteinte : il est clairement
établi que Héron est postérieur à Vitruve mort en −20, et
contemporain de Pline l’Ancien (23 – 79), en étant actif autour de l’an
62. Il a donc bien vécu au 1er siècle après J.-C. et sans
doute au début du 2ème siècle, donc sous l’Empire romain,
mais dans l’Alexandrie grecque.
On attribue à Héron d’Alexandrie plusieurs formules mathématiques
et une méthode efficace d’extraction de racine carrée,
c’est-à-dire de résolution de l’équation x2=a, avec a
positif :
Info
Choisir une première valeur raisonnable que l’on note G.
Améliorer cette valeur en calculant la moyenne des valeurs G et x/G.
Vérifier si cette nouvelle valeur convient.
Reprendre l’étape 2 tant que la valeur calculée n’est pas satisfaisante.
L’objectif de cette activité est de mettre en œuvre cette méthode en Python.
Travail à réaliser
Le fichier réponse devra se terminer par les instructions afin de pouvoir y placer les jeux de tests pour les différentes fonctions (on découvrira la signification de cette instruction dans quelques jours).
if__name__=="__main__":
Qu’appelle-t-on la documentation d’une fonction ? La spécification d’une fonction ?
Avertissement
Toute fonction doit être accompagnée de sa spécification !
Définir la fonction moyenne dont la spécification est
defmoyenne(a:float,b:float)->float:"""Calcule et retourne la moyenne des deux nombres a et b
passés en argument.
"""
Ajouter le jeu de test suivant à la fin du fichier :
assertmoyenne(12,16)==14assertmoyenne(0,8)==4
Réponse
defmoyenne(a:float,b:float)->float:"""
Calcule et retourne la moyenne des deux nombres a et b
passés en argument.
"""return(a+b)/2
Définir la fonction valeur_absolue dont la spécification est :
defvaleur_absolue(x:float)->float:"""
Calcule et retourne la valeur absolue du nombre x passé en argument.
"""
Remarque.
Il est interdit d’utiliser la fonction abs intégrée à Python.
Ajouter le jeu de test suivant à la fin du fichier :
defpuissance(x:float,n:int)->float:"""
calcule et retourne le résultat de x à la puissance entière n :
x^n = x . x . x . ... . x (n fois)
"""res=1foriinrange(1,n+1):res*=xreturnres
Définir la fonction amelioration_essai dont la spécification est :
defamelioration_essai(essai:float,x:float)->float:"""Calcule et retourne la moyenne des nombres essai (strictement positif)
et x/essai.
"""
Remarque.
Cette fonction doit utiliser la fonction moyenne définie plus haut.
Ajouter le jeu de test suivant à la fin du fichier :
defamelioration_essai(essai:float,x:float)->float:"""
Calcule et retourne la moyenne des nombres essai (strictement positif) et x/essai.
"""returnmoyenne(essai,x/essai)
Définir le prédicat est_suffisamment_bon dont la spécification est :
defest_suffisamment_bon(essai:float,x:float)->bool:"""
Retourne True si la valeur absolue de la différence du carré du nombre essai
et du nombre x est inférieure à une tolérance donnée (prendre 0.001).
Retourne False sinon.
"""
Remarque.
Cette fonction doit utiliser les fonctions valeur_absolue et puissance définies ci-dessus.
Ajouter le jeu de test suivant à la fin du fichier :
defest_suffisamment_bon(essai:float,x:float)->bool:"""
Retourne True si la valeur absolue de la différence du carré du nombre essai
et du nombre x est inférieure à une tolérance donnée (prendre 0.001).
Retourne False sinon.
"""tolerance=0.001returnvaleur_absolue(puissance(essai,2)-x)<tolerance
Définir la fonction test qui implémente l’algorithme de Héron d’Alexandrie. La spécification de la fonction est :
deftest(essai:float,x:float)->float:"""
Retourne la racine carrée du nombre x. Le calcul est effectué grâce à un
raisonnement itératif depuis une première valeur strictement positive notée essai.
"""
Remarque.
Cette fonction doit utiliser les fonctions est_suffisamment_bon et amelioration_essai.
Ajouter le jeu de test suivant à la fin du fichier :
deftest(essai:float,x:float)->float:"""
Retourne la racine carrée du nombre x. Le calcul est effectué grâce à un
raisonnement itératif depuis une première valeur strictement positive notée
essai.
"""whilenotest_suffisamment_bon(essai,x):essai=amelioration_essai(essai,x)returnessai
Définir la fonction racine_carree dont la spécification est :
defracine_carree(x:float)->float:"""
Retourne le résultat de l'appel de la fonction test avec la valeur 1
pour l'argument essai.
"""
Ajouter le jeu de test suivant à la fin du fichier :
To understand recursion, you must first understand recursion.
La récurrence est un raisonnement mathématique courant et parmi les plus puissants pour démontrer des théorèmes ou construire des objets. Par exemple, on l’utilise dans un cours de mathématique de lycée pour montrer que :
Pour tout entier n⩾0, on a : 1+2+3+…+n=2n(n+1) ;
Un entier naturel n’est autre que 0 ou le successeur d’un entier naturel (0 est 0, 1 est le successeur de 0, 2 est le successeur de 1, …).
En programmation, on peut raisonner de façon identique, nous allons construire des fonctions et des structures de données (listes chaînées, arbres, etc.) à l’aide d’une hypothèse de récurrence et d’un point de départ. Le déroulement de la récurrence sera quant à lui pris en charge par la machine.
Avertissement
La récursion est une approche plus descriptive que constructive. On « dit » quoi faire à l’ordinateur mais pas comment.
À retenir
La récursion est un mécanisme puissant permettant d’exprimer la répétition des opérations dans un programme sans utiliser de structure itérative (boucles while ou for). C’est un mode de pensée qui permet de concevoir des fonctions ou des structures de données (listes chaînées, arbres, etc.) dont l’écriture condense en peu de lignes l’exécution de calculs éventuellement très longs.
Ce chapitre traite de la récursion sur les nombres entiers.
La fonction factorielle indique le nombre de permutations dans un ensemble comportant n éléments. Par exemple, il existe 3!=6 façons d’arranger les 3 caractères ‘a’, ‘b’, ‘c’ :
‘abc’, ‘acb’, ‘bac’, ‘bca’, ‘cab’ et ‘cba’.
On peut exprimer de plusieurs façons la définition de cette fonction :
Une définition implicite : n!=1×2×3×…×n
Une définition explicite :
n!={1n×(n−1)! si n=0 si n≥1
La première définition est particulièrement ambigüe :
Que signifie l’ellipse … ?
Est-il possible de calculer la factorielle d’un nombre inférieur à 3 ?
La factorielle de 0 existe-t-elle ?
Les réponses à toutes ces questions sont évidentes pour une personne ayant suivi un cours de mathématique mais inaccessibles à un ordinateur.
La définition explicite, qui se réfère à elle-même, est dite récursive : la valeur de la fonction en n s’exprime au moyen de la valeur de la fonction en n−1.
Une fonction définie de façon récursive est calculable.
Élévation à la puissance
On peut exprimer de plusieurs façons la définition de cette fonction :
Une définition implicite : xn=x×x×…×xnfois
Une définition explicite1 :
xn={1x×x(n−1) si n=0 si n>0
La définition implicite présente les mêmes ambiguïtés que dans le cas du calcul de la factorielle d’un entier naturel, tandis que la définition explicite, qui se réfère elle-aussi à elle-même et est donc récursive, permet de calculer la valeur de xn.
Mise en œuvre d’un raisonnement récursif : le jeu de Bowling
La disposition des quilles de Bowling permet d’illustrer la mise en œuvre d’un raisonnement récursif :
Combien de quilles composent l’arrangement présenté ?
Réponse
10
On veut ajouter une cinquième ligne à l’arrangement présenté. Combien de quilles supplémentaires devront être disposées si l’on souhaite respecter la logique présente ?
Réponse
5
De combien de quilles sera alors constitué l’arrangement ?
Réponse
10+5=15
Nombre de lignes
Nombre de quilles
Calcul du nombre de quilles
1
1
arrangement(1)
2
3
2 + arrangement(1)
3
6
3 + arrangement(2)
4
10
4 + arrangement(3)
5
15
5 + arrangement(4)
Nombre de quilles en fonction du nombre de lignes. La fonction arrangement reçoit en argument le nombre de lignes et retourne le nombre de quilles dans un arrangement de ce nombre de lignes.
Combien de quilles contient un arrangement de 11 lignes ?
On déduit rapidement du tableau ci-dessus que le nombre de quilles est égal à : 11 + arrangement(10), c’est à dire à 11 plus le nombre de quilles présentes dans un arrangement à 10 lignes.
Obtient-on directement la réponse ?
Non, il faut tout d’abord calculer le nombre de quilles dans un arrangement à 10 lignes. Le calcul est facile, c’est : 10 + arrangement(9), etc.
Quand faut-il s’arrêter ?
On sait que arrangement(1) = 1. On s’arrête donc lorsque l’on est parvenu à un arrangement à 1 ligne.
Info
Le raisonnement précédent est un raisonnement récursif. On a découpé le problème en deux parties :
Si l’arrangement comporte une seule ligne, la réponse est : arrangement(1) = 1.
Si l’arrangement comporte N lignes, la réponse est : N + arrangement(N - 1).
Calcul effectif du nombre de quilles dans un arrangement à 5 lignes
Un algorithme est simplement récursif s’il s’appelle lui-même pour effectuer son traitement.
Il est impératif de veiller à ce qu’un algorithme récursif se termine sous peine d’engendrer un processus infini !
Implémentation de l’algorithme en Python
defarrangement(n:int)->int:"""
Détermination du nombre de quilles dans un
arrangement à n lignes.
HYPOTHÈSE : n entier naturel.
"""ifn==1:# cas de basereturn1else:returnn+arrangement(n-1)# appel récursifassertarrangement(5)==15
Retour sur le calcul de la factorielle d’un entier naturel
On reprend ici le calcul de la factorielle de l’entier naturel n. La définition récursive de la fonction factorielle est donc :
n!={1n×(n−1)! si n=0 si n≥1
Application : calcul de la factorielle de 5
En prenant exemple sur le calcul effectif du nombre de quilles en fonction du nombre de ligne dans l’arrangement, calculer la valeur de 5! en détaillant toutes les étapes.
Réponse
L’arbre des appels est une représentation arborescente faisant apparaître les appels récursifs jusqu’au cas de base.
Implémentation de l’algorithme récursif en Python
deffactorielle(n:int)->int:"""
Définition récursive de la fonction factorielle.
HYPOTHÈSE : n entier naturel.
"""ifn==0:# cas de basereturn1else:returnn*factorielle(n-1)# appel récursifassertfactorielle(5)==120
La définition récursive d’une fonction doit être formée :
d’un ou plusieurs cas de base, qui ne doivent contenir aucun appel récursif ;
d’un ou plusieurs appel(s) récursif(s) au cours desquels la fonction s’appelle elle-même.
Remarques
Il est impératif que le cas de base soit réalisé à une étape du processus, sous peine d’obtenir une récursion infinie.
Les appels récursifs n’apparaissent pas de façon évidente dans le cas de la récursivité croisée (cf. exercices).
Ensembles bien fondés
La récursion sur les entiers naturels consiste à transformer un problème sur un entier naturel n en un ou plusieurs problèmes sur des nombres plus petits. Comme il n’existe pas de suite infinie strictement décroissante dans l’ensemble des entiers naturels, la récursion finit par atteindre un cas de base comme 0 (ou 1, ou …) pour lequel une solution directe au problème est fournie.
L’ensemble des entiers naturels est dit « bien fondé ».
Récursivité vs itération
La récursivité et l’itération sont deux paradigmes[^2] différents ayant le même objectif : faire effectuer des traitements répétitifs à un ordinateur.
Récursivité, Itération
Un algorithme itératif décritcomment doivent être transformées les données pour parvenir à résoudre le problème.
À chaque « tour de boucle » des affectations sont réalisées.
Un algorithme récursif définit, au sens mathématique du terme, le traitement à mettre en œuvre pour parvenir à résoudre le problème.
Cet algorithme ne s’appuie généralement pas sur la notion d’affectation (Nous reviendrons sur cette partie lorsque nous parlerons des différents paradigmes de programmation).
Tout problème dont la résolution s’appuie sur un algorithme récursif peut aussi être résolu à l’aide d’un algorithme itératif (plus ou moins simplement).
Tout problème dont la résolution s’appuie sur un algorithme itératif peut aussi être résolu à l’aide d’un algorithme récursif.
Les algorithmes récursifs sont généralement plus simples à comprendre que les algorithmes itératifs correspondant.
Avertissement
La version récursive d’un algorithme ne dit pas comment atteindre l’état final d’un traitement, elle donne une définition de ce résultat.
Exemple
L’algorithme récursif du calcul de la factorielle d’un nombre définit cette factorielle.
L’algorithme itératif indique qu’il faut multiplier 1 par 2, stocker le résultat de ce calcul dans une variable, multiplier le contenu de cette variable par 3, …, jusqu’à n.
Info
Certains langages informatiques appelés langages fonctionnels, ne possèdent ni instruction d’affectation ni structure itérative !
Les langages qui privilégient les structures itératives (et l’affectation) sont dits impératifs.
Python est un langage mutli-paradigme : il permet de programmer de façon impérative, objet ou fonctionnelle (même si les appels récursifs, par exemple, ne sont pas aussi bien optimisés en Python que dans les langages fonctionnels).
Pourquoi ne pas toujours utiliser la récursivité ?
Un algorithme récursif est généralement plus facile à comprendre que l’équivalent itératif. On peut donc se demander pourquoi on ne privilégie pas toujours les traitements récursifs.
Généralement, les appels récursifs successifs nécessitent plus d’espace mémoire et de traitements — sachant que les processeurs ont, eux, un fonctionnement fondamentalement itératif — que les processus itératifs.
Les langages fonctionnels modernes possèdent des compilateurs ou des interpréteurs suffisamment « intelligents » pour palier à ces inconvénients.
Si l’on devait résumer l’idée générale de la récursivité
À retenir
Si un problème est facile à résoudre, le résoudre immédiatement.
C’est le cas de base.
Si un problème n’est pas facile à résoudre, le découper en problèmes plus petits. Résoudre les plus petits problèmes.
Ce sont les appels récursifs.
Exercices du chapitre
Penser à écrire, pour chacune des fonctions ci-dessous, sa spécification ainsi qu’un jeu de tests.
Un corrigé partiel se trouve en ligne à cette adresse :
https://repl.it/join/qaeylksn-dlatreyte
. Ce corrigé comporte des exemples d’utilisation de l’instruction assert.
Exercice 1 : Factorielle
Écrire la définition itérative de la fonction factorielle.
Solution
deffactorielle_iter(n:int)->int:"""
Calcule la factorielle de n.
Algortihme itératif.
HYPOTHÈSE : n est un entier naturel
"""fact=1foriinrange(1,n+1):fact=fact*ireturnfactdeffactorielle_rec(n:int)->int:"""
Calcule la factorielle de n.
Algortihme récursif.
HYPOTHÈSE : n est un entier naturel
"""ifn==0:return1else:returnn*factorielle_rec(n-1)
Exercice 2 : Compte à rebours
Écrire une fonction récursive qui, à partir d’un argument entier, affiche un compte à rebours.
En modifiant seulement la position de la fonction print, faire en sorte que le comptage se fasse dans l’ordre croissant.
Solution
defcompte_a_rebours(n:int)->None:"""
Affiche un compte à rebours à l'écran.
"""ifn==0:print(n)returnNoneelse:print(n,end=" ")compte_a_rebours(n-1)returnNonedefcompte(n:int)->None:"""
Affiche un comptage à l'écran.
"""ifn==0:print(n,end=" ")returnNoneelse:compte(n-1)print(n,end=" ")returnNone
Exercice 3 : Somme des N premiers entiers
Écrire les versions itérative et récursive d’une fonction qui calcule la somme des N premiers entiers. La tester pour N=15.
Solution
defsomme_entiers_rec(n:int)->int:"""
Calcule la somme des n premiers entiers.
Algorithme récursif.
HYPOTHÈSE : n entier naturel
"""ifn==0:return0else:returnn+somme_entiers_rec(n-1)defsomme_entiers_iter(n:int)->int:"""
Calcule la somme des n premiers entiers.
Algorithme itératif.
HYPOTHÈSE : n entier naturel
"""somme=0foriinrange(n+1):somme=somme+ireturnsomme
Exercice 4 : Multiplication récursive
Écrire une fonction récursive qui calcule le produit de deux nombres entiers positifs en utilisant des additions.
Le principe est le suivant :
a×b={0(a−1)×b+b si a=0 si a>0
Exécuter la fonction pour a=4 et b=5 (pour cela, présenter les appels récursifs successifs sous forme d’un arbre), puis pour a=5 et b=4.
Pour quel appel l’arbre est-il le plus grand ?
Noter sur quel argument porte la récursion.
Que peut-on en conclure ?
Solution
defmultiplication(a:int,b:int)->int:"""
Réalise la multiplication de deux entiers naturels a et b.
"""ifa==0:return0else:returnmultiplication(a-1,b)+b
Exercice 5 : Calculs de puissances
Écrire une fonction récursive qui calcule xn sachant que :
xn={1xn−1×x si n=0 si n>0
Écrire une fonction récursive qui calcule xn sachant que :
xn=⎩⎨⎧1(xn/2)2(x(n−1)/2)2×x si n=0 si n>0 pair si n>0 impair
Comparer les exécutions (avec arbre des appels) des deux fonctions ci-dessus pour n=11 et x=2. Quel est l’arbre le plus court ? Que peut-on en conclure ?
Solutions
defpuissance_01(x:float,n:int)->float:"""
Premier calcul de la puissance n du nombre x.
HYPOTHÈSE : n entier naturel.
"""ifn==0:return1else:returnpuissance_01(x,n-1)*xdefpuissance_02(x:float,n:int)->float:"""
Second calcul de la puissance n du nombre x.
HYPOTHÈSE : n entier naturel.
"""ifn==0:return1elifn%2==0:inter=puissance_02(x,n/2)# mise en mémoire du résultat de l'appel récursifreturninter*interelse:inter=puissance_02(x,(n-1)/2)# mise en mémoire du résultat de l'appel récursifreturninter*inter*x
Exercice 6 : Suite de Fibonacci
Écrire une fonction récursive qui calcule le nieˋme terme de la « suite de Fibonacci » définie par :
u0u1un=0=1=un−1+un−2pour n⩾2
Exécuter la fonction pour n=5
L’arbre des appels est représenté sur la figure ci-dessous. Expliquer pourquoi cette fonction est très peu efficace.
Solution
deffibonacci(n:int)->int:"""
Calcule le terme n de la suite de Fibonacci.
HYPOTHÈSE : n entier naturel
"""ifn==0:return0elifn==1:return1else:returnfibonacci(n-1)+fibonacci(n-2)
Exercice 7 : Formule de Viète
On peut obtenir une valeur approchée du nombre π grâce à la formule de Viète :
π≈2k2−2+2+…2+2
où k est le nombre de racines carrées. Plus la valeur de k est grande, meilleure est l’approximation.
On constate que la partie s=2+2+…2+2 est récursive.
Écrire une fonction récursive nommée calcul_inter, qui, à partir d’un entier positif k, calcule la valeur de la partie s.
Écrire une fonction nommée calcul_pi, qui, à partir d’un entier positif k, calcule la valeur approchée de π.
Cette fonction doit appeler la fonction calcul_inter.
Depuis la fonction main, appeler la fonction calcul_pi avec plusieurs valeurs de k (essayer 5, 10, 15). Comparer au résultat retourné par l’attribut pi du module math.
Exercice 8 : Plus grand diviseur commun
Écrire une fonction récursive qui retourne le plus grand diviseur commun de deux entiers passés comme arguments. On se servira de l’algorithme d’Euclide :
pgcd(m,n)=⎩⎨⎧mpgcd(n,m)pgcd(n,mmodn) si n=0 si m<n sinon
Solution
defpgcd(m:int,n:int)->int:"""
Calcule le pgcd de m et n. La récursivité est terminale.
HYPOTHÈSE : n et m entiers naturels
"""ifn==0:returnmelifm<n:returnpgcd(n,m)else:returnpgcd(n,m%n)
Exercice 9 : Ackermann-Péter
La fonction d’Ackermann-Péter est définie récursivement comme suit :
A(m,n)=⎩⎨⎧n+1A(m−1,1)A(m−1,A(m,n−1)) si m=0 si m>0 et n=0 si m>0 et n>0
Écrire une fonction qui, à partir de deux arguments m et n, calcule A(m,n). La tester avec les valeurs m=3, n=4.
Remarques
La fonction d’Ackermann croît extrêmement rapidement : A(4,2) a déjà 19729 chiffres !
La fonction d’Ackermann demandant beaucoup de calculs même pour de petites entrées, elle est parfois utilisée comme programme de test d’une implémentation d’un langage de programmation : en particulier, elle utilise de façon très exigeante la récursivité (cf. Fonction d’Ackermann, Wikipédia).
Solution
defackermann(m:int,n:int)->int:"""
Définition de la fonction d'Ackermann.
HYPOTHÈSE : m, n entiers naturels
"""ifm==0:returnn+1elifm>0andn==0:returnackermann(m-1,1)else:returnackermann(m-1,ackermann(m,n-1))
Exercice 10 : Récursivité croisée
On considère deux suites u(n) et v(n) définies, pour n≥0 par :
Ces deux suites ont pour particularité que : v(n)−u(n)=1 pour tout n.
Écrire un programme qui, à l’aide de fonctions récursives, donne les valeurs de ces deux suites pour un n donnée (tester avec n=3) et qui vérifie que la différence entre ces deux valeurs est égale à 1.
Établir les arbres des appels.
Solution
defu(n:int)->int:"""
Calcul de la valeur de u(n).
"""ifn==0:return1else:return3*u(n-1)+2*v(n-1)defv(n:int)->int:"""
Calcul de la valeur de v(n)
"""ifn==0:return2else:return2*u(n-1)+3*v(n-1)defmain():n=int(input("Entrer la valeur de n : "))u_=u(n)v_=v(n)print("u({}) = {}".format(n,u_))print("v({}) = {}".format(n,v_))print("v({}) - u({}) = {}".format(v_,u_,v_-u_))main()
Exercice 10 : Fonctions mutuellement récursives
Le but de cet exercice consiste à écrire les fonctions récursives est_pair et est_impairsans utiliser le modulo.
La fonction est_pair (resp. est_impair) retourne True si son argument entier est pair (resp. impair).
n∈N est impair si n−1 est pair.
n∈N est pair si n−1 est impair.
0 est pair.
0 n’est pas impair.
Solution
defest_pair(nbre:int)->bool:"""
Détermine si un nombre nbre est pair.
HYPOTHÈSE : nbre entier naturel
"""ifnbre==0:returnTrueelse:returnest_impair(nbre-1)defest_impair(nbre:int)->bool:"""
Détermine si un nombre nbre est impair.
HYPOTHÈSE : nbre entier naturel
"""ifnbre==0:returnFalseelse:returnest_pair(nbre-1)defmain():"""Fonction principale"""n=int(input("Entrer le nombre à tester : "))print("Est-il pair ? {}".format(est_pair(n)))main()
Exercice 11 : Conjecture de Syracuse
On appelle suite de Syracuse une suite d’entiers naturels définie de la manière suivante : On part d’un nombre entier plus grand que zéro. S’il est pair, on le divise par 2 ; s’il est impair, on le multiplie par 3 et on ajoute 1. En répétant l’opération, on obtient une suite d’entiers positifs dont chacun ne dépend que de son prédécesseur.
Par exemple, à partir de 14, on construit la suite des nombres :
C’est ce qu’on appelle la suite de Syracuse du nombre 14. Une fois le nombre 1 atteint, la suite des valeurs (1,4,2,1,4,2,…) se répète indéfiniment en un cycle de longueur 3 (appelé cycle trivial).
La conjecture de Syracuse (encore appelée conjecture de Collatz, ou conjecture d’Ulam) est l’hypothèse mathématique selon laquelle la suite de Syracuse de n’importe quel entier strictement positif atteint 1.
Écrire la fonction syracuse à un paramètre entier qui retourne la longueur de la suite de Syracuse de cet entier pour obtenir 1.
Solution
defsyracuse_01(n:int)->int:"""Retourne la longueur de la suite de Syracuse, c'est à
dire le nombre de termes avant que la valeur soit égale à 1.
Récursivité enveloppée.
"""ifn==1:return1elifn%2==0:return1+syracuse_01(n/2)else:return1+syracuse_01(n*3+1)
Ce n’est pas la seule définition possible et c’est loin d’être la plus efficace une fois implémentée. ↩︎
Physique, Chimie et Informatique > Terminales Spé. NSI > Récursivité
La récursivité appliquée aux chaînes de caractères et aux listes
Introduction
Une chaîne de caractère est une structure de données qui permet de rassembler en un unique objet une succession ordonnée de caractères. Ainsi, une définition récursive d’une chaîne de caractères pourrait être :
Définition récursive d’une chaîne de caractères
Une chaîne de caractères est :
soit la chaîne de caractères vide ;
soit constituée de son premier caractère et du reste des caractères qui forment aussi une chaîne de caractères (éventuellement vide).
Une liste est une structure de données qui permet de rassembler en un unique objet une succession ordonnée d’objets (ou de valeurs). Ainsi, une définition récursive d’une liste pourrait être :
Définition récursive d’une liste
Une liste est :
soit la liste vide ;
soit constituée de son premier élément et du reste des éléments qui forment aussi une liste (éventuellement vide).
Exercices
Penser à écrire, pour chacune des fonctions ci-dessous, sa spécification ainsi qu’un jeu de tests.
Recherche dans une chaîne de caractères
Écrire une fonction récursive nommée est_dans, qui, à partir d’un caractère e et d’une chaîne de caractères c, détermine si ce caractère appartient à la chaîne.
Tester cette fonction.
Remarque : la fonction est_dans est un prédicat.
Solution
defest_dans(e:str,c:str)->bool:"""
Détermine si le caractère e est dans la chaîne c.
Version utilisant une sous-chaîne.
Récursivité terminale.
"""ifc=="":returnFalseelifc[0]==e:returnTruereturnest_dans(e,c[1:])defest_dans_02(e:str,c:str,i:int)->bool:"""
Détermine si le caractère e est dans la chaîne c.
Version utilisant un indice et toujours la même chaîne.
Il s'agit toujours d'une récursivité terminale.
"""ifi==len(c):returnFalseelife==c[i]:returnTrueelse:returnest_dans_02(e,c,i+1)defmain():"""Fonction principale."""chaine=input("Entrer la chaîne : ")car=input("Entrer le caractère à recherche : ")print("{} est-il dans {} : {}".format(car,chaine,est_dans(car,chaine)))print("{} est-il dans {} : {}".format(car,chaine,est_dans_02(car,chaine,0)))main()
Recherche de la position d’un caractère dans une chaîne de caractères
Écrire une fonction récursive nommée rang, qui, à partir d’un caractère e et d’une chaîne de caractères c, détermine la (première) position de ce caractère dans la chaîne. Si le caractère n’est pas présent, retourner un nombre négatif.
Tester cette fonction dans un programme.
Solution
defrang(e:str,c:str,i:int)->int:"""
Retourne l'indice de la première position du caractère e dans la
chaîne c ou -1 si le caractère n'est pas présent dans la chaîne.
Remarque : l'indice n'est pas réellement le rang. Faire débuter i
à 0 pour obtenir l'indice, à 1 pour obtenir le rang.
Remarque : récursivité terminale
"""ifc=="":return-1elifc[0]==e:returnielse:returnrang(e,c[1:],i+1)defrang_2(c:str,e:str)->int:"""
Retourne le rang de la première position du caractère e dans la
chaîne c ou un nombre négatif si le caractère n'est pas présent
dans la chaîne.
Récursivité enveloppée.
"""ifc=="":return-float("inf")elifc[0]==e:return1else:return1+rang(c[1:],e)defmain():"""Fonction principale."""chaine=input("Chaîne ? ")car=input("Caractère ? ")indice=rang(car,chaine,0)ifindice>=0:print("Position du carcatères :",indice)else:print("Caractère pas présent dans la chaîne.")main()
Copie d’une chaîne de caractères
Écrire une fonction récursive nommée copie, qui, à partir d’une chaîne de caractères c, retourne une nouvelle chaîne copie de c.
Tester cette fonction.
Solution
defcopie(c:str)->str:"""
Retourne une copie de la chaîne c.
Algorithme récursif.
"""ifc=="":return""else:returnc[0]+copie(c[1:])assertcopie("abcd")=="abcd"assertcopie("a")=="a"assertcopie("")==""
Inversion d’une chaîne de caractères
Écrire une fonction récursive nommée inversion, qui, à partir d’une chaîne de caractères c, retourne la chaîne « mirroir », c’est à dire la chaîne égale à celle passée en argument quand on la lit de droite à gauche.
Tester cette fonction dans un programme.
Solution
definversion(c:str)->str:"""
Inverse une chaîne de caractères.
Version avec sous-chaîne et récursivité enveloppée.
"""ifc=="":return""else:returninversion(c[1:])+c[0]definversion_02(c:str,c_inv:str)->str:"""
Inverse une chaîne de caractères.
Version avec sous-chaîne et récursivité terminale.
"""ifc=="":returnc_invelse:returninversion_02(c[1:],c[0]+c_inv)definversion_03(c:str,i:int)->str:"""
Inverse une chaîne de caractères.
Version sans sous-chaîne et récursivité enveloppée.
"""ifi==len(c):return""else:returninversion_03(c,i+1)+c[i]definversion_04(c:str,c_inv:str,i:int)->str:"""
Inverse une chaîne de caractères.
Version sans sous-chaîne et récursivité terminale.
"""ifi==len(c):returnc_invelse:returninversion_04(c,c[i]+c_inv,i+1)defmain():"""Fonction principale."""chaine=input("Chaîne ? ")chaine_inversee_01=inversion(chaine)print(chaine_inversee_01)chaine_inversee_02=inversion_02(chaine,"")print(chaine_inversee_02)chaine_inversee_03=inversion_03(chaine,0)print(chaine_inversee_03)chaine_inversee_04=inversion_04(chaine,"",0)print(chaine_inversee_04)main()
Détecteur de palindrome
Un palindrome est un mot (ou une phrase) qui se lit aussi bien de la gauche vers la droite que de la droite vers la gauche : par exemple « radar », « kayak », ou bien la phrase « esope reste et se repose » (si l’on ne tient pas compte des espaces).
Écrire une fonction récursive nommée est_palindrome qui reçoit comme argument une chaîne de caractères contenant le mot (ou la phrase). Cette fonction doit tester si les deux caractères opposés sont identiques, puis appeler récursivement la fonction sur la partie de la chaîne qui ne contient pas ces deux caractères (les espaces sont ignorés).
Solution
defest_palindrome(c:str)->bool:"""
Détecte si la chaîne de caractères est un palindrome.
Utilisation d'une sous-chaïne. La récursivité est terminale.
Hypothèse : la chaîne c n'est pas vide.
"""ifc=="":returnTrueelifc[0]!=c[-1]:returnFalseelse:returnest_palindrome(c[1:-1])defest_palindrome_02(c:str,i:int,j:int)->bool:"""
Détecte si la chaîne de caractères est un palindrome.
i est le premier indice de la chaîne, j le dernier.
Utilisation d'une sous-chaîne. La récursivité est terminale.
Hypothèse : la chaîne c n'est pas vide.
"""ifi==j:returnTrueelifc[i]!=c[j]:returnFalseelse:returnest_palindrome_02(c,i+1,j-1)defmain():"""Fonction principale."""chaine=input("Chaîne à tester : ")print("Est un palindrome 01 ? {}".format(est_palindrome(chaine)))print("Est un palindrome 02 ?",est_palindrome_02(chaine,0,len(chaine)-1))main()
Travail sur les listes
Écrire une fonction nommée longueur_liste, récursive, qui, à partir d’une liste passée en argument, détermine sa longueur.
Écrire une fonction nommée somme_elements, récursive, qui, à partir d’une liste de nombres passée en argument, calcule la somme de tous les nombres.
2bis. Écrire une fonction nommée produit_elements, récursive, qui, à partir d’une liste de nombres passée en argument, calcule le produit de tous les nombres.
Écrire une fonction nommée plus_grand_element, récursive, qui, à partir d’une liste d’entiers passée en argument, détermine quel est l’entier le plus grand.
Écrire une fonction nommée plus_petit_element, récursive, qui, à partir d’une liste d’entiers passée en argument, détermine quel est l’entier le plus petit.
Écrire une fonction nommée somme_listes_imbriquees, récursive, qui additionne tous les entiers des listes.
Exemple de listes imbriquées :
l1=[1,[2,[3,4],5],6,[7,8]]l2=[1,[2,[3,[4,[5]]]]]
Remarque.
Cette question peut illustrer, par exemple, la recherche de l’occupation disque de tous les fichiers dans la structure arborescente d’un système de fichiers à partir d’un point de cette structure.
Écrire une fonction nommée duplique, récursive, qui, à partir d’un élément e et d’un entier n, retourne une liste qui contient l’élément e un nombre de fois égal à n.
assertduplique(5,3)==[5,5,5]
Écrire une fonction nommée extrait, récursive, qui, à partir d’une liste l et d’un entier n, retourne une liste constituée par les n premiers éléments de l.
assertextrait([5,4,3,2,1],3)==[5,4,3]
Écrire une fonction nommée renverse, récursive, qui, à partir d’une liste, retourne une liste dans laquelle les éléments sont renversés (les derniers apparaissent en premier).
Écrire une fonction nommée creation_liste_filtree, qui, à partir de deux entiers i et j passés en argument retourne une liste d’entiers compris entre i et j multiples de 3 ou de 5.
assertcreation_liste_filtree(1,10)==[3,5,6,9,10]
Modifier la fonction précédente afin que le filtre « entiers multiples de 3 ou de 5 » soit passé en argument.
Solutions
defplus_grand_element(liste:list)->float:"""
Retourne le plus grand éléments de la liste.
"""ifliste==[]:raiseException("La liste est vide.")eliflen(liste)==1:returnliste[0]else:val_max=plus_grand_element(liste[1:])returnliste[0]ifliste[0]>val_maxelseval_maxdefplus_petit_element(liste:list)->float:"""
Retourne le plus petit élément de la liste.
"""ifliste==[]:raiseException("La liste est vide")eliflen(liste)==1:returnliste[0]else:val_min=plus_petit_element(liste[1:])returnliste[0]ifliste[0]<val_minelseval_mindeflongueur_liste(l:List)->int:"""
Retourne le nombre d'éléments dans une liste.
Récursivité enveloppée.
"""ifl==[]:return0else:return1+longueur_liste(l[1:])deflongueur_liste_02(liste:list,l:int=0)->int:"""
Retourne le nombre d'éléments dans une liste.
Récursivité terminale.
"""ifliste==[]:returnlelse:returnlongueur_liste_02(liste[1:],l+1)defsomme_elements(l:List[float])->float:"""
Retourne la somme des éléments de la liste.
Récursivité enveloppée.
"""ifl==[]:return0else:returnl[0]+somme_elements(l[1:])defsomme_elements_2(l:List[float],s:int=0)->float:"""
Retourne la somme des éléments de la liste.
Récursivité terminale.
"""ifl==[]:returnselse:returnsomme_elements_2(l[1:],s+l[0])defsomme_listes_imbriquees(liste:list,s:float=0)->float:"""
Retourne la somme des éléments de listes imbriquées.
"""iflen(liste)==0:returnselse:ifnotisinstance(liste[0],list):returnsomme_listes_imbriquees(liste[1:],s+liste[0])else:somme_avec_sous_listes=somme_listes_imbriquees(liste[0],s)returnsomme_listes_imbriquees(liste[1:],somme_avec_sous_listes)defsomme_listes_imbriquees(l:List)->float:"""
Retourne la somme de tous les éléments d'une liste,
même si elle contient des sous-listes imbriquées.
"""ifl==[]:return0elifisinstance(l[0],list):returnsomme_listes_imbriquees(l[0])+somme_listes_imbriquees(l[1:])else:returnl[0]+somme_listes_imbriquees(l[1:])defproduit_elements(l:List[float])->float:"""
Retourne le produit de tous les éléments de la liste.
Récursivité enveloppée.
"""ifl==[]:raiseException("La liste est vide.")eliflen(l)==1:returnl[0]else:returnl[0]*produit_elements(l[1:])defproduit_elements_2(l:List[float],p:float=1)->float:"""
Retourne le produit de tous les éléments de la liste.
Récursivité terminale.
"""ifl==[]:raiseException("La liste est vide.")eliflen(l)==1:returnl[0]*pelse:returnproduit_elements_2(l[1:],l[0]*p)defrecherche_element(liste:list,val_rech:int,i:int)->int:"""Ne se contente pas de déterminer si la valeur cherchée est
présente, retourne son indice (on ne cherche que la première
valeur) si possible (sinon -1)."""ifi==len(liste):return-1elifliste[i]==val_rech:returnielse:returnrecherche_element(liste,val_rech,i+1)defmain():l=[-128,-23,123,213,9,2891]nbre_max=plus_grand_element(l)nbre_min=plus_petit_element(l)longueur=longueur_liste(l)somme=somme_elements(l)produit=produit_elements(l)l2=[[1,[1,[1,[1]],1]],1]somme2=somme_listes_imbriquees(l2,0)print("Recherche élément")print(recherche_element(l,12,0))print("Recherche nombre max")print(nbre_max)print(nbre_min)print(longueur)print(somme)print(produit)print(somme2)main()
Physique, Chimie et Informatique > Terminales Spé. NSI > Récursivité
Recherche d'un élément dans un tableau : algorithmes itératifs et récursifs
Recherche d’un élément dans un tableau
La recherche d’éléments dans un tableau a déjà été évoquée en classe de première. Les deux algorithmes mis en œuvre à cette occasion, la recherche linéaire et la recherche dichotomique, utilisaient des boucles.
L’objectif de cette séance est de rapidement revoir ces algorithmes et de mettre en œuvres des algorithmes récursifs de même complexité. Quatre algorithmes de recherche vont donc être implémentés :
La recherche linéaire itérative ;
La recherche linéaire récursive ;
La recherche dichotomique itérative ;
La recherche dichotomique récursive.
Travail à faire
Implémenter en Python les cinq algorithmes suivants et répondre aux questions.
Avertissement
Penser à donner la spécification de chacune des fonctions et écrire une série des tests pour chacune d’elles.
Recherche séquentielle (ou linéaire)
À retenir
La recherche séquentielle (ou linéaire) consiste à
comparer la valeur recherchée à toutes les valeurs présentes dans le tableau.
Recherche séquentielle itérative
Algorithme 1
Fonction : recherche(tab, valeur) Action : recherche la valeur « valeur » dans le tableau « tab » Début i ⟵ 0 i_val ⟵ -1 nb ⟵ Longueur(tab) TantQue i < nb Faire Si tab[i] = valeur Alors i_val ⟵ i FinSi i ⟵ i + 1 FinTantQue Renvoyer i_val Fin
Décrire le fonctionnement de l’algorithme pour les valeurs tab = [1, 8, 3, 5, 9] et val = 3.
Réponse
Démontrer que l’algorithme se termine.
Réponse
Pour démontrer que l’algorithme se termine il faut définir un variant de boucle car c’est au niveau
de la boucle TantQue qu’un problème peut intervenir.
La fonction dont l’expression est f(i)=nb−i est-elle un variant de boucle ?
i et nb sont des entiers naturels. De plus la boucle « tourne » tant que i<nb.
f(i) est donc un entier naturel.
f(ik+1)−f(ik)=nb−ik+1−(nb−ik)=ik−ik+1. Comme
ik+1=ik+1, f(ik+1)−f(ik)=ik−(ik+1)=−1. La fonction
est décroissante.
f est une fonction qui retourne forcément un entier naturel et qui est décroissante ;
elle est donc bornée par la valeur 0, c’est un variant de boucle.
L’algorithme se termine.
Démontrer que l’algorithme est correct.
Réponse
Pour déterminer qu’un algorithme qui comporte une boucle est correct, il faut trouver
un invariant de boucle.
On peut par exemple dire que « La valeur recherchée n’est pas présente dans les éléments du tableau d’indices 0 à i-1, où i est l’indice courant. »
Initialisation : Avant la première itération, i=0, donc l’invariant est vrai trivialement car aucun élément n’a encore été examiné.
Conservation : À chaque itération, on vérifie si l’élément à l’indice i est la valeur recherchée. Si ce n’est pas le cas, on passe à l’élément suivant (i+1). Ainsi, on sait que la valeur recherchée n’est pas dans les éléments précédents.
Terminaison : La boucle se termine soit quand on trouve la valeur (auquel cas l’invariant n’est plus nécessaire), soit quand on a parcouru tout le tableau sans la trouver (auquel cas l’invariant assure que la valeur n’est pas dans le tableau).
Démontrer que l’algorithme est en O(N).
Réponse
L’algorithme contient une boucle dont le nombre de tours est, dans le pire des cas,
égal au nombre d’éléments dans la liste. La complexité est donc linéaire, O(n).
Comment pourrait-on améliorer l’efficacité de cet algorithme ?
Réponse
Il faudrait quitter la boucle dès l’instant où la valeur a été trouvée, si elle
est bien présente dans la liste.
Algorithme 2
Fonction : recherche(tab, valeur) Action : recherche de la valeur « valeur » dans le tableau « tab » Début trouvé ⟵ Faux i ⟵ 0 TantQue i < nb et (Non trouvé) Faire Si tab[i] = valeur Alors trouvé ⟵ Vrai Sinon i ⟵ i + 1 FinSi FinTantQue Si trouvé = Vrai Alors Renvoyer i Sinon Renvoyer -1 Fin
Expliquer pourquoi l’algorithme 2 est plus efficace que l’algorithme 1.
Réponse
On quitte la boucle dès l’instant où la valeur a été trouvée, si elle
est bien présente dans la liste.
Recherche séquentielle récursive
Algorithme 3
Fonction : recherche(tab, valeur, i) Action : recherche la valeur « valeur » dans le tableau « tab » à l’aide de l’indice i. Début nb ⟵ Longueur(tab) Si i == nb Alors Renvoyer -1 Sinon Si tab[i] = valeur Alors Renvoyer i Sinon Renvoyer recherche(tab, valeur, i + 1) FinSi FinSi Fin
Décrire le fonctionnement de l’algorithme pour les valeurs tab = [1, 8, 3, 5, 9], i = 0 et val = 3.
Établir, en particulier, l’arbre des appels.
Recherche dichotomique
Dès que le nombre de données devient important, la recherche séquentielle n’est plus envisageable. Sa complexité en O(N) pénalise les autres traitements qui l’utilisent. Il faut diminuer le temps de traitement par l’emploi d’algorithmes plus performants, comme celui de la recherche dichotomique.
À retenir
La recherche dichotomique est basée sur le principe de « diviser pour régner ». On divise l’ensemble de recherche en deux sous-ensembles égaux. On détermine ensuite dans quel sous-ensemble doit se trouver la valeur recherchée, puis on poursuit la recherche dans ce sous-ensemble.
Avertissement
Le préalable à la méthode de recherche dichotomique est de disposer d’un ensemble trié de données, car la détermination du sous-ensemble dans lequel se poursuit la recherche se fait par comparaison entre la valeur recherchée et les valeurs de début et de fin du sous-ensemble.
À retenir
La division par deux de l’ensemble de données de recherche à chaque appel indique que la complexité est en O(logN).
Recherche dichotomique itérative
Algorithme 4
Fonction : recherche(tab, valeur) Action : recherche la valeur « valeur » dans le tableau « tab » Débuttrouvé ⟵ FAUX résultat ⟵ -1 gauche ⟵ 0 droite ⟵ Longueur(tab) - 1 TantQue (gauche <= droite) ET (NON trouvé) Faire milieu ⟵ (droite + gauche) // 2 Si tab[milieu] = valeur Alors resultat ⟵ milieu trouvé ⟵ VRAI SinonSi tab[milieu] < valeur Alors gauche ⟵ milieu + 1 Sinon droite ⟵ milieu - 1 FinSi FinTantQue Renvoyer résultat Fin
Décrire le fonctionnement de l’algorithme pour les valeurs tab = [1, 3, 5, 8, 9] et val = 3.
Réponse
Démontrer que l’algorithme se termine.
Réponse
Variant de boucle :f(g,d)=d−g+1 où d signifie « droite » et g « gauche ».
Au début, g=0 et d=n−1 (où n est la taille du tableau).
Le variant initial est donc n, qui est un entier naturel.
À chaque itération, on a trois cas :
Si l’élément est trouvé, la boucle se termine.
Si l’élément cherché est plus grand que le milieu, on met à jour g=m+1
Si l’élément cherché est plus petit que le milieu, on met à jour d=m−1
Dans les deux derniers cas, la taille de l’intervalle est réduite de moitié (ou presque).
Donc, le variant diminue strictement à chaque itération.
Puisque le variant est initialement positif, diminue strictement à chaque itération, et que la boucle se termine quand il atteint 0 ou 1, on peut conclure que l’algorithme se termine toujours en un nombre fini d’étapes.
Démontrer que l’algorithme est correct.
Réponse
Invariant de boucle : À chaque itération de la boucle, l’élément recherché, s’il est présent dans le tableau, se trouve dans la sous-section de l’intervalle [gauche, droite], où :
gauche est l’indice de début de l’intervalle actuel,
droite est l’indice de fin de l’intervalle actuel.
Initialisation (avant la première itération)
Initialement, les indices gauche et droite sont positionnés de telle sorte que :
gauche = 0, qui représente le premier indice du tableau.
droite = n - 1, qui représente le dernier indice du tableau.
Ainsi, avant la première itération, l’élément recherché se trouve potentiellement dans l’intervalle entier du tableau [0, n - 1], ce qui respecte bien l’invariant de boucle.
Conclusion : L’invariant est vérifié avant la première itération.
Conservation (pendant l’itération)
Supposons que l’invariant soit vrai au début d’une itération, c’est-à-dire que si l’élément recherché est présent, il se trouve dans l’intervalle [gauche, droite].
L’algorithme calcule ensuite l’indice médian : milieu
Il compare l’élément à l’indice milieu avec l’élément recherché x :
Si l’élément au milieu est égal à x : L’algorithme s’arrête, et l’élément est trouvé, ce qui n’est pas en contradiction avec l’invariant.
Si l’élément au milieu est strictement inférieur à x : L’algorithme met à jour la borne gauche : gauche = milieu + 1
Cela signifie que x ne peut pas se trouver dans la sous-partie gauche du tableau (de l’indice gauche à milieu), car les éléments dans cette partie sont tous inférieurs à x. Par conséquent, l’élément recherché, s’il existe, se trouve dans le nouvel intervalle [gauche, droite], et l’invariant est préservé.
Si l’élément au milieu est strictement supérieur à x : L’algorithme met à jour la borne droite : droite = milieu − 1
Cela signifie que x ne peut pas se trouver dans la sous-partie droite du tableau (de milieu à droite), car les éléments dans cette partie sont tous supérieurs à x. Par conséquent, l’élément recherché, s’il existe, se trouve dans le nouvel intervalle [gauche, droite], et l’invariant est préservé.
Conclusion : L’invariant est préservé à chaque itération.
Terminaison
La boucle se termine lorsque l’intervalle devient vide, c’est-à-dire lorsque gauche > droite. Cela signifie que l’élément recherché n’existe pas dans le tableau (sinon, il aurait été trouvé lors des itérations précédentes).
Ainsi, lorsque l’algorithme se termine :
Soit il a trouvé l’élément recherché, ce qui est cohérent avec l’invariant.
Soit l’intervalle est vide, et donc l’élément n’est pas présent dans le tableau, ce qui est également conforme à l’invariant, car l’invariant stipule seulement que si l’élément est présent, il se trouve dans l’intervalle.
Conclusion : À la fin de l’algorithme, l’invariant reste valide et garantit que le résultat final est correct.
Démontrer que l’algorithme est en O(log2N).
Réponse
L’algorithme fonctionne en divisant l’intervalle de recherche par 2 à chaque itération. Ainsi, si le tableau contient n éléments, après une itération, la taille de l’intervalle est réduite à n/2, puis n/4, et ainsi de suite. En général, après k itérations, la taille de l’intervalle est réduite à n/2k.
L’algorithme se termine lorsque l’intervalle ne contient plus qu’un seul élément, ce qui se produit lorsque :
2kn=1
En résolvant cette équation, on obtient :
k=log2(n)
Cela signifie que l’algorithme effectue au plus log2(n) itérations pour un tableau de taille n.
Recherche dichotomique récursive
Algorithme 5
Fonction : recherche(tab, valeur, gauche, droite) Action : recherche la valeur « valeur » dans le tableau « tab » DébutSi gauche > droite Alors Renvoyer -1 Sinon milieu ⟵ (droite + gauche) // 2 Si tab[milieu] = valeur Alors Renvoyer milieu SinonSi tab[milieu] < valeur Renvoyer recherche(tab, valeur, milieu + 1, droite) Sinon Renvoyer recherche(tab, valeur, gauche, milieu - 1) FinSi FinSi Fin
Décrire le fonctionnement de l’algorithme pour les valeurs tab = [1, 3, 5, 8, 9], gauche = 0, droite = 4, et val = 3.
Réponse
Application
Exercice
Écrire un programme de devinette : l’utilisateur choisit un nombre au hasard (compris entre 1 et 50) et l’ordinateur doit découvrir ce nombre. Faire en sorte que le nombre de tentatives de l’ordinateur lui permette de trouver la bonne valeur à coup sur (choisir de façon pertinente ce nombre).
Physique, Chimie et Informatique > Terminales Spé. NSI > Récursivité
Un algorithme est une suite finie et non ambiguë
d’opérations ou d’instructions à réaliser afin de résoudre un problème.
En informatique, pour qu’un algorithme puisse être implémenté, il est
nécessaire de s’assurer que la « suite finie et non ambiguë d’opérations ou
d’instructions à réaliser » s’effectue en une durée finie .
À retenir
Lorsqu’on élabore ou étudie un algorithme, il est donc nécessaire de
vérifier :
Sa finitude : Il doit se terminer en un temps fini.
Sa correction : Il doit (généralement) donner le bon résultat.
Sa performance : Plusieurs algorithmes peuvent permettre de résoudre une même
classe de problèmes. Ils ne nécessiteront cependant pas tous l’utilisation de
la même quantité de mémoire ou le même nombre d’étapes de calcul, donc la
même durée.
Remarques
Ce n’est pas toujours une mauvaise nouvelle si certains algorithmes ont besoin d’un « temps infini » pour résoudre un problème : certains choix en cryptographie reposent sur l’idée que « casser » la protection nécessite une durée de calcul trop grande, pour le matériel dont on dispose aujourd’hui.
Pour certains problèmes on doit se contenter d’une solution approchée et pas d’une solution exacte.
À retenir
La performance d’un algorithme porte sur deux aspects : la durée du
calcul et la quantité de mémoire nécessaires à la résolution du
problème. Malheureusement ces deux points s’opposent . Il est souvent
nécessaire d’occuper davantage de mémoire pour gagner en temps de calcul, ou
d’écrire plus d’instructions, et donc faire plus de calculs, pour aboutir à
une gestion de la mémoire optimale.
Conformément au programme, on limite la performance algorithmique à la complexité algorithmique.
Notion de complexité algorithmique
Introduction
À retenir
La complexité algorithmique donne des informations
sur la durée du calcul nécessaire à la résolution du problème. Plus
la complexité algorithmique est petite, moins de calculs sont effectués et
plus l’algorithme est performant (sous réserve que la gestion de l’espace
mémoire utilisé par l’implémentation de l’algorithme ne constitue pas un
problème).
Avertissement
On exprime la complexité d’un algorithme en fonction de la taille (nombre)
des données qu’il manipule en considérant que chaque instruction
élémentaire s’effectue en temps constant.
Il existe plusieurs méthodes pour analyser la complexité d’un algorithme,
comme :
L’analyse moyenne : Il s’agit d’évaluer comment varie la durée moyenne des
calculs à effectuer en fonction du nombre de données manipulées.
L’analyse optimiste Il s’agit d’évaluer comment varie le nombre de calculs à
effectuer, dans le scénario le plus favorable, en fonction du nombre de
données manipulées.
Par exemple, on cherche une valeur dans une liste et c’est la première qui apparaît lors de cette recherche.
L’analyse pessimiste (ou du pire cas) : Il s’agit d’évaluer comment varie le
nombre de calculs à effectuer, dans le scénario le moins favorable, en
fonction du nombre de données manipulées.
Par exemple, on cherche une valeur dans une liste alors qu’elle n’est pas présente dans la liste.
Lorsqu’on utilise le résultat de l’analyse du « pire cas », aucune
mauvaise surprise ne peut intervenir, le pire cas à été envisagé à
l’avance.
Les complexités des différents algorithmes varient beaucoup. On peut
néanmoins regrouper les algorithmes en quelques grandes familles :
Complexité constante : Leur notation est de la forme O(1). Ces algorithmes sont indépendants du nombre de données à traiter.
Info
La complexité constante apparaît dans la recherche par index dans un tableau. La complexité constante est la plus « performante ».
Les algorithmes logarithmiques : Leur notation est de la forme O(logN). Ces
algorithmes sont très performants en temps de traitement. Le nombre de calculs
dépend du logarithme du nombre de données à traiter.
Sur la Figure ci-dessous, on peut constater que, plus le nombre de données N à
traiter est important, moins le nombre de calcul à effectuer augmente
rapidement — la valeur de la dérivée est de moins en moins grande.
La fonction logarithme à utiliser dépend du problème étudié mais, comme
la complexité est définie à un facteur près, la base du logarithme n’a pas
d’importance.
Info
La complexité logarithmique apparaît dans les problèmes dans lesquels
l’ensemble des données peut être décomposé en deux parties égales, qui
sont elles-mêmes décomposées en 2 (recherche par dichotomie, recherche dans un arbre binaire, etc.). La complexité logarithmique est très « performante ».
Avertissement
Le logarithme à utiliser est alors
la fonction réciproque de f:x⟼2x, c’est à dire log2
(aussi appelé logarithme entier).
Le logarithme entier d’un nombre x supérieur ou égal à 1 est le nombre de fois qu’il faut le diviser par deux pour obtenir un nombre inférieur ou égal à 1.
Les algorithmes linéaires : Leur notation est de la forme O(N). Ces
algorithmes sont rapides. Le nombre de calculs dépend, de manière linéaire,
du nombre de données initiales à traiter.
Info
La complexité linéaire apparaît dans les problèmes dans lesquels on
parcourt séquentiellement l’ensemble des données pour réaliser une
opération (recherche d’une valeur, par exemple). La complexité linéaire est considérée comme « efficace ».
Les algorithmes linéaires et logarithmiques (quasi-linéaire) : Leur notation est de la forme O(NlogN).
Info
La complexité linéaire et logarithmique apparaît dans des problèmes dans lesquels on découpe répétitivement les données en deux parties, que l’on parcourt
séquentiellement ensuite (tri Quicksort par exemple). La complexité quasi-linéaire est considérée comme « assez efficace ».
Les algorithmes de type polynomiale : Leur notation est de la forme O(Nk) où
k est la puissance.
Info
Une complexité quadratique apparaît, par exemple, lorsqu’on parcourt un
tableau à deux dimensions, lorsqu’on effectue un tri par comparaison, etc. La complexité polynomiale est considérée comme « moyennement efficace ».
Les algorithmes exponentiels ou factoriels : Leur notation est de la forme O(eN) ou O(N!). Ce sont les algorithmes les plus complexes.
Le nombre de calculs augmente de façon exponentielle ou factorielle en
fonction du nombre de données à traiter. Un algorithme de complexité
exponentielle traitera, dans le pire des cas, un ensemble de 10 données en
effectuant 22026 calculs ; un ensemble de 100 données en effectuant 2,688⋅1043 calculs !!!
On dit généralement que les problèmes produisant ce type d’algorithmes sont
« non calculables ».
Info
On rencontre les algorithmes de type exponentiels ou factoriels dans les problématiques liées à la
programmation de fonctions humaines comme la vision, la reconnaissance des
formes ou l’intelligence artificielle.
Complexité
Durée pour N=106
Logarithmique : O(logN)
10 ns
Linéaire : O(N)
1 ms
Quadratique : O(N2)
1/4 heure
Polynomiale : O(Nk)
30 ans si k=3
Exponentielle : O(2N)
plus de 10300000 milliards d’années
Ordres de grandeur des durées d’exécution d’un problème de taille 106 sur un ordinateur à un milliard d’opérations par seconde (« Informatique pour tous en CPGE », éditions Eyrolles).
Quelques règles simples permettant de déterminer la complexité d’un algorithme
Nous allons introduire, dans cette partie, quelques règles simples qui permettent de se faire une idée de l’efficacité d’un algorithme :
Une affectation ou l’évaluation d’une expression ont un temps d’exécution petit. Cette durée constitue souvent l’unité de base dans laquelle on mesure le temps d’exécution d’un algorithme.
Le temps pris pour exécuter une séquence d’instrutions p q est la somme des temps pris pour exécuter les instructions p puis q.
Le temps pris pour exécuter un test Si (b) Alors p Sinon q FinSi est inférieur ou égal au maximum des temps pris pour exécuter les instructions p et q, plus une unité qui correspond au temps d’évaluation de l’expression b.
Le temps pris pour exécuter une boucle Pour i variant de 1 à m par pas de 1 Faire p FinPour est m fois le temps pris pour exécuter l’instruction p si ce temps ne dépend pas de la valeur de i.
En particulier, quand deux boucles sont imbriquées, le corps de la boucle interne est répété à cause de cette boucle, mais aussi parce qu’elle-même est répétée dans son intégralité. Ainsi, si les deux boucles sont répétées respectivement m et m′ fois, alors le corps de la boucle interne est exécuté m×m′ fois en tout.
Quand le temps d’exécution du corps de la boucle dépend de la valeur de l’indice i, le temps total d’exécution de la boucle est la somme des temps d’exécution du corps de la boucle pour chaque valeur de i.
Le cas des boucles Tantque est plus complexe puisque le nombre d’itérations n’est en général pas connu à priori. Il doit être évalué au cas par cas.
Exercice
Pour chacun des programmes suivants, dire en fonction de n quel est le nombre d’opérations op que le programme effectue. Justifier votre résultat.
Pour i de 1 à n Faire
    op
Pour i de 1 à n Faire
    op; op
Pour i de 1 à n Faire
    Pour j de 1 à n Faire
        op
Pour i de 1 à n Faire
    Pour j de 1 à n Faire
        Pour k de 1 à n Faire
            op
Pour i de 1 à n Faire
    op; op
     Pour j de 1 à n Faire
         op
         Pour k de 1 à n Faire
            op
Pour i de 1 à n Faire
    Pour j de 1 à i Faire
        op
i ⟵ 1
j ⟵ 1
TantQue (i ≤ m) et (j ≤ n) Faire
    op
    i ⟵ i + 1
    j ⟵ j + 1
i ⟵ 1
j ⟵ 1
TantQue (i ≤ m) ou (j ≤ n) Faire
    op
    i ⟵ i + 1
    j ⟵ j + 1
Tant que n > 0 Faire
    op
    n ⟵ n // 2
Comment illustrer l’influence du nombre d’éléments passés en entrée
Quelques complexités à tout de suite identifier
En utilisant la fonction time du module time, écrire le code de fonctions qui :
montre que le temps d’accès à un élément d’une liste est en O(1) ;
montre que la recherche linéaire dans une liste est en O(N) ;
met en évidence la complexité de l’opérateur Python in ;
montre que la recherche linéaire dans une liste à deux dimensions est en O(N2) ;
montre que la recherche dichotomique dans une liste triée est en O(log(N)).
Terminaison d’un algorithme itératif : variant de boucle
La structure qui généralement doit retenir l’attention lors de l’analyse de
la terminaison d’un algorithme est la structure de boucle.
À retenir
On appelle variant d’une boucle une fonction qui a
pour variables les variables du problème, qui retourne une valeur entière positive et
qui décroît à chacune des itérations de la boucle, jusqu’à s’annuler ou
prendre une valeur constante négative qui dépend de la condition d’arrêt de
la boucle.
La découverte d’un variant de boucle permet de conclure que la boucle se
termine puisqu’il n’existe aucune suite infinie strictement décroissante d’entiers naturels.
Exemple 1 : Calcul de la plus petite puissance de deux supérieure ou égale à un entier n
Algorithme 1
Fonction :plusPetitePuissance(n) Entrée :entier naturel n Sortie :entier naturel p dont la valeur est égale à la plus petite
puissance de deux supérieure ou égale à n. Début p⟵1 TantQuep<nFaire p⟵2p FinTantQue Fin
Info
La fonction f d’expression f(p)=n−p est-elle un variant de boucle ?
f(p) est un entier positif.
Tant que p<n, f(p)>0
f décroît sur l’ensemble des valeurs de p puisque
f(pi+1)−f(p)=n−pi+1−n+pi=pi−pi+1=pi−2pi=−pi<0
Condition d’arrêt :pmax⩾n, donc f(pmax)⩽0.
La fonction f est un variant de boucle et la boucle se termine donc bien.
Exemple 2 : Palindrome
Algorithme 2
Fonction :palindrome(m) Entrée :chaîne de caractères m Sortie :booléen Vrai si la chaîne de caractères m est un palindrome, Faux sinon Début i⟵0 j⟵longueur(m)−1 TantQuei⩽jFaire Sim[i]=m[j]Alors i⟵i+1 j⟵j−1 Sinon Renvoyer Faux FinSi FintantQue Renvoyer Vrai Fin
Décrire au moyen d’un tableau indiquant l’évolution des valeurs des
variables le fonctionnement de l’algorithme 2 pour la chaîne de caractères
« sauras » puis pour la chaîne de caractères « radar ». Remarque : Le premier élément d’une chaîne a pour indice 0.
Réponse
Pour l’entrée « sauras » : i : 0, 1, 2 j : 5, 4, 3
La fonction retourne Faux.
Pour l’entrée « radar » : i : 0, 1, 2, 3 j : 4, 3, 2, 1
La fonction retourne Vrai.
Montrer que f(i,j)=j−i est un variant de la boucle TantQue.
Réponse
f(i,j)=j−i est-elle un variant de boucle ?
Tant que j>i, f(i,j) est un entier positif et f(i,j)=j−i>0.
f(i+1,j−1)=j−1−(i+1)=j−1−i−1=j−i−2=f(i,j)−2<f(i,j).
La fonction est donc décroissante sur l’ensemble des valeurs de i et de j.
Condition d’arrêt :i>j, donc f(i,j)=j−i<0
En déduire que la boucle TantQue se termine.
Réponse
La fonction f est un variant de boucle. La boucle se termine donc bien.
Correction d’un algorithme itératif : invariant de boucle
À retenir
On appelle invariant d’une boucle une propriété qui,
si elle est vraie avant l’exécution d’une itération, le demeure après
l’exécution de l’itération.
Un invariant de boucle doit être vrai avant de commencer la boucle et est
alors garanti de rester correct après chaque itération de la boucle. En
particulier, l’invariant sera toujours vrai à la fin de la boucle.
Les boucles et la récursivité étant fondamentalement similaire, il y a peu de
différence entre démontrer un invariant de boucles et prouver qu’un programme
est correct en utilisant un raisonnement par récurrence.
Exemple 3 : Calcul de 2n
Algorithme 3
Fonction :calculPuissanceDeux(n) Entrée :entier naturel n Sortie :entier naturel p dont la valeur est égale à 2n Début p⟵1 Pourkallant de 1 à nfaire p⟵2p FinPour Fin
Info
La propriété « À chaque tour de boucle p est une puissance de 2 » est un invariant de
boucle. En effet :
Initialisation : Avant d’entrer dans la boucle : p=1=20.
Conservation : On suppose l’invariant vérifié au tour i de la boucle : p=2i. Au tour i+1, pi+1=pi×2=2i×2=2i+1.
Terminaison : La boucle réalise n tours ; au dernier tour p=2n−1×2=2n
La proposition est donc bien un invariant de boucle et on peut conclure que l’algorithme est correct.
Exemple 4 : Quotient et reste de la division euclidienne d’un entier positif par un entier strictement
Algorithme 4
Fonction :division(a, b) Entrée :entiers naturels a et b Sortie :Quotient q et reste r de la division euclidienne
de l’entier naturel a par l’entier naturel b Début q⟵0 r⟵a TantQuer⩾bFaire q⟵q+1 r⟵r−b FinTantQue Renvoyerq,r Fin
Décrire le fonctionnement de l’algorithme pour l’entrée (a = 17, b = 5) au moyen d’un tableau indiquant l’évolution des valeurs des variables
au fil des itérations.
Réponse
abqr1750171751121752717532
Montrer que la boucle TantQue se termine en utilisant un variant de
boucle.
Réponse
La fonction f(r)=r−b peut-elle être un variant de boucle ?
f(r)=r−b est un entier.
Pour n’importe quel tour de boucle r⩾b, donc f(r)=r−b⩾0.
Soit r2=r1−b. f(r2)=r2−b=r1−b−b=f(r1)−b⩽f(r1).
La fonction f est décroissante.
Condition d’arrêt :r<b, donc f(r,b)=r−b<0.
La fonction f est bien un variant de boucle et cette boucle se termine.
Montrer que la propriété a=bq+r est un invariant de la
boucle TantQue, en déduire que l’algorithme produit le résultat
attendu.
Réponse
Si la propriété a=bq+r est un invariant de boucle, elle doit être vraie avant d’entrer dans la boucle, à chaque tour de boucle et une fois la boucle terminée.
Initialisation : Avant d’entrer dans la boucle, q=0 et r=a. Donc on a bien a=0×b+a.
Conservation : On suppose la propriété vraie au rang k quelconque de la boucle : a=bqk+rk.
Au rang k+1, qk+1=qk+1 et rk+1=rk−b. Donc a=bqk+1+rk+1=bqk+b+rk−b=bqk+rk.
Terminaison : La boucle s’arrête lorsque r<b. Au dernier tour de la boucle on a donc bien a=bq+r.
La propriété a=bq+r est bien un invariant de boucle et le programme est correct.
Écrire le code Python implémentant l’algorithme 4. La spécification de la fonction est la suivante :
defdivision_euclidienne(a:int,b:int)->tuple[int,int]:"""
Calcule la division euclidienne de l'entier naturel a par l'entier naturel b.
Retourne les entiers naturels q et r, quotient et reste de cette division.
"""
Réponse
defdivision_euclidienne(a:int,b:int)->tuple[int,int]:"""
Calcule la division euclidienne de l'entier naturel a par l'entier naturel b.
Retourne les entiers naturels q et r, quotient et reste de cette division.
"""q=0r=awhiler>=b:q=q+1r=r-breturnq,r
Écrire un jeu de tests pour la fonction division_euclidienne.
Réponse
Existe-t-il un ou des algorithmes qui réalisent la même opération plus efficacement ?
Réponses
la fonction trouve le plus grand élément dans la liste passée en argument.
f(i)=i−1 avec i=len(s) est-il un variant de boucle ?
f(i0)=len(s)−1 est un entier naturel si la liste s n’est pas vide.
f(ik+1)−f(ik)=len(s[1:])−1−len(s)+1=len(s[1:])−len(s)<0
La fonction f est strictement décroissante.
ider=1, f(ider)=1−1=0. f est un variant de boucle et la boucle se termine.
Invariant de boucle :
Exercice
On considère la fonction somme_premiers_entiers qui implémente l’algorithme :
Algorithme 5
Fonction :somme_premiers_entiers(n) Entrée :entier naturel n Sortie :somme des n premiers entiers naturels Début somme⟵0 i⟵1 TantQuei⩽nFaire somme⟵somme+1 i⟵i+1 FinTantQue Renvoyer somme Fin
Implémenter en Python l’algorithme proposé. Ne pas oublier la spécification de la fonction.
Écrire un jeu de test pour cette fonction.
Prouver que la boucle se termine à l’aide du variant de boucle f(n,i)=n−i où i est le compteur de la boucle.
Prouver que la proposition : « au début du tour du kième tour de la boucle, la variable somme est égale à la somme des k−1 premiers entiers naturels » est un invariant de boucle. En déduire que l’algorithme est correct.
Quelle est la complexité de cet algorithme ?
Réponses
defsomme_premiers_entiers(n:int)->int:"""
Calcule la somme des n premiers entiers.
HYPOTHÈSE : n entier naturel
"""somme=0i=0whilei<=n:somme=somme+ii=i+1returnsomme
Pour n’importe quel tour de boucle, on a i⩽n. Donc f(n,i)=n−i⩾0 ;
Au rang k+1, ik+1=ik+1 donc f(n,ik+1)=n−ik+1=n−ik−1=f(n,ik)−1<f(n,ik). La fonction f décroit lorsque la boucle progresse.
condition d’arrêt :i>n, donc f(n,i)=n−i<0.
La fonction f est positive, décroissante lorsque la boucle « tourne » et finalement prend une valeur négative lorsque la boucle est terminée ; c’est un variant de boucle. La présence d’un variant de boucle nous assure que la boucle se termine.
Initialisation : Avant d’entrer dans la boucle, somme=0.
Conservation : On suppose que somme=0+1+…+k−1 au début de la kième boucle.
Pendant la kième boucle, on a somme=somme+k=0+1+…+k−1+k.
Au début de la k+1ième boucle, on a donc bien somme=0+1+…+k.
Terminaison : La boucle s’arrête dès que i>n. Donc au début du n+1ième tour (tour de boucle qui n’aura jamais lieu), on a bien somme=0+1+…+n.
La proposition est bien un invariant de boucle, elle nous assure que le programme est corret.
Physique, Chimie et Informatique > Terminales Spé. NSI > Récursivité
Le mot fractale vient du latin fractus qui signifie brisé. En effet, une
figure fractale est un objet géométrique infiniment morcelé des détails
sont observables à une échelle arbitrairement choisie.
En zoomant sur une partie de la figure, on peut retrouver toute la
figure, on dit qu’elle est auto similaire.
Dans le code suivant (qu’il faudra étudier et exécuter) :
Quel est le cas de base de l’algorithme récursif ?
Où s’effectue l’appel récursif ?
Pourquoi le cas de base est-il toujours réalisé ?
importturtleimportmathasmdefdessine_etoile(t:turtle,pt:tuple,long:int)->None:iflong<=2:returnNoneforiinrange(6):x_ext=pt[0]+int(long*m.cos((2*m.pi/6)*i))y_ext=pt[1]+int(long*m.sin((2*m.pi/6)*i))pt_ext=(x_ext,y_ext)# Extrémité du segmentt.penup()t.setposition(pt)t.pendown()t.setposition(pt_ext)dessine_etoile(t,pt_ext,long/3)defmain():t=turtle.Turtle()t.speed(0)t.hideturtle()segment=300centre=(0,0)dessine_etoile(t,centre,segment)turtle.mainloop()main()
Le flocon de von Koch
La première courbe à tracer a été imaginée par le mathématicien suédois
Niels Fabian Helge von Koch, afin de montrer que l’on pouvait tracer des
courbes continues en tout point, mais dérivables en aucun.
Le principe est le suivant : on divise un segment initial en trois morceaux,
et on construit un triangle équilatéral sans base au-dessus du morceau
central. On réitère le processus n fois, n étant appelé l’ordre.
Ordres 0, 1, 2 et 3 de la fractale.
Si on trace trois fois cette figure, on obtient successivement un
triangle, une étoile, puis un flocon de plus en plus complexe.
Figures successives (ordre 0, 1, 2 et 4).
Principe de la construction
Info
La méthode de construction utilise un algorithme récursif :
À l’ordre 0, il suffit d’appeler une fois la méthode forward pour tracer un segment. C’est le cas de base.
À l’ordre 1, il faut appeler la méthode forward (4 fois), les méthodes left et right pour découper le segment en 4 parties (de même longueur).
À l’ordre n≥1, le code ressemble à celui de l’ordre 1, si ce
n’est qu’on remplace l’appel de chacune des méthodes forward par le tracé de
segments à l’ordre n−1. C’est l’appel récursif, on découpe chaque
partie de segment en sous-parties.
Travail
Définir la fonction de signature
koch_1(t:turtle,l:int)->None
qui dessine un segment de Koch à l’ordre 1, de longueur l, à l’aide de l’objet de type Turtle t. Les sous-segments de la figure sont de longueur l/3 et les angles
sont de 60 ou 120 degrés.
Définir la fonction main permettant de tester la fonction koch_1.
Remarque.
Les futurs tracés vont nécessiter beaucoup de calculs et
l’affichage de nombres points à l’écran. De façon à améliorer la
performance,
régler la vitesse de la tortue au maximum : t.speed(0) ;
cacher le symbole représentant la tortue à l’écran : t.hideturtle.
Définir la fonction de signature
koch(t:turtle,n:int,l:int)->None
qui dessine à l’écran un segment de
Koch d’ordre 0 ou 1, de longueur l, à l’aide de l’objet de type
Turtle t.
Le corps de la fonction doit uniquement gérer les deux cas : n=0
et n=1 (le cas n≥1 sera traité dans l’une des prochaines
questions.
Modifier la fonction main de façon à tester la fonction koch.
Cette partie généralise la fonction koch au cas n≥2. Il faut
découper chaque segment de droite en sous-parties ; il faut donc
remplacer chaque appel de la méthode forward dans koch par un appel de la
fonction koch elle-même : koch(t, n-1, ...).
Trouver par quoi remplacer les … et modifier la fonction.
Tester koch la nouvelle fonction pour une longueur de 300 pixels et
n∈[0,5] (au delà de cette dernière valeur, on ne voit plus
trop de différences).
Définir la fonction de signature qui dessine à l’écran
un flocon de von Koch, d’ordre n et dont chaque segment à une
longueur l.
Solution
"""
Tracé du flocon de Von Koch
"""importturtledefkoch_0(t,l):"""
koch_0 : Objet[turtle] * Entier/>0/ -> None
koch_0(t, l) trace à l'écran un segment de longueur l.
"""t.forward(l)defkoch_1(t,l):"""
koch_1: Objet[turtle] * Entier/>0/ -> None
koch_1(t, l) dessine une branche de longueur l du flocon de Von Koch à
l'ordre 1.
"""t.forward(l/3)t.left(60)t.forward(l/3)t.right(120)t.forward(l/3)t.left(60)t.forward(l/3)defkoch(t,n,l):"""
koch : Objet[turtle] * Entier/>0/ * Entier/>0/ -> None
koch(t, n, l) dessine une branche du flocon de Von Koch à
l'ordre n.
"""ifn==0:t.forward(l)else:koch(t,n-1,l/3)t.left(60)koch(t,n-1,l/3)t.right(120)koch(t,n-1,l/3)t.left(60)koch(t,n-1,l/3)defdessine_flocon(t,n,l):"""
dessine_flocon : Objet[turtle] * Entier/>0/ * Entier/>0/
-> None
dessine_flocon(t, n, l) dessine un flocon de Von Koch à
l'ordre n.
"""ifnott.isdown():t.pendown()koch(t,n,l)t.right(120)koch(t,n,l)t.right(120)koch(t,n,l)t.right(120)defmain():fen=turtle.Screen()fen.bgcolor("black")t=turtle.Turtle()t.color("white")t.speed(0)t.hideturtle()t.penup()t.goto(-150,150)t.pendown()dessine_flocon(t,5,400)# koch(t, 4, 300)# koch_1(t, 200)fen.exitonclick()main()
Arbre fractal
On peut appliquer le même principe pour construire d’autre fractales
visuellement différentes, mais construites sur le même principe.
Présentation
> Arbre fractal.
Par exemple, pour construire un arbre, on part d’un segment, et on
applique la transformation présentée ci-dessus à
chaque segment de la construction (on refait la transformation n fois
pour obtenir un arbre d’ordre n) :
> Base de la construction d'un arbre.
Les portions dessinées en pointillées sont celles sur lesquelles on
appliquera la transformation à l’ordre suivant (on les appelle les
segments non-terminaux). Les portions dessinées en trait plein sont
des segments qui ne seront pas transformés (on les appellera les
segments terminaux).
Pour transformer un segment non-terminal de longueur l, on trace un
segment terminal de longueur l/3, puis deux segments non-terminaux de
longueur 2l/3 à un angle θ du premier segment.
Travail
Suivre la même démarche que pour le flocon de Koch pour écrire une
fonction de signature qui trace l’arbre, et repositionne la tortue à
son point de départ.
Dans un premier temps, gérer les ordres 0 et 1 (utiliser la méthode
et aucun appel récursif), et tester la fonction. Vérifier en
particulier que la tortue est bien revenue à son point de départ à
la fin de l’exécution de la fonction dans les deux cas (n = 0 et n =
1).
Pour chaque tracé de segment non-terminal, remplacer l’appel à la
méthode par un appel récursif à la fonction , et vérifier le
comportement de la fonction à différents ordres. Cette fois-ci, une
profondeur 10 ou 11 donne un résultat assez joli.
Solution
"""
Programme qui dessine un arbre fractal.
"""importturtleimportmathasmdefarbre(t:turtle,n:int,longueur:int,theta:int)->None:ifn==0:t.color("red")t.forward(longueur)t.backward(longueur)t.color("black")else:t.width(n)t.forward(longueur/3)t.left(theta)arbre(t,n-1,longueur/3*2,theta)t.right(2*theta)arbre(t,n-1,longueur/3*2,theta)t.left(theta)t.backward(longueur/3)defmain():t=turtle.Turtle()t.hideturtle()t.speed(0)t.setheading(90)longueur=300theta=35n=11arbre(t,n,longueur,theta)# enregistrement de l'imagets=turtle.getscreen()ts.getcanvas().postscript(file="arbre.pdf")turtle.mainloop()main()
Physique, Chimie et Informatique > Terminales Spé. NSI
Modularité et robustesse du code
Au programme
Contenus
Capacités attendues
Commentaires
Modularité
- Utiliser des API (Application Programming Interface) ou des bibliothèques. - Exploiter leur documentation. - Créer des modules simples et les documenter.
- Mise au point des programmes. - Gestion des bugs.
- Dans la pratique de la programmation, savoir répondre aux causes typiques de bugs : problèmes liés au typage, effets de bord non désirés, débordements dans les tableaux, instruction conditionnelle non exhaustive, choix des inégalités, comparaisons et calculs entre flottants, mauvais nommage des variables, etc.
On prolonge le travail entrepris en classe de première sur l’utilisation de la spécification, des assertions, de la documentation des programmes et de la construction de jeux de tests. Les élèves apprennent progressivement à anticiper leurs erreurs.
Ce chapitre se concentre sur les modules de Python et sur les modalités
d’importation des données des modules dans l’environnement de travail.
À retenir
L’objectif de ce document est de souligner l’importance d’un code modulaire,
c’est à dire d’un code qui :
puisse être utilisé dans plusieurs programmes ;
puisse être documenté précisément ;
soit suffisamment compact pour être étudié avec soin et en particulier testé.
Qu’est-ce qu’un module ?
À retenir
Un module permet d’organiser logiquement le code Python.
Quand la taille du code augmente, il peut être pratique de le diviser en entités organisées qui
peuvent continuer à interagir.
Un module permet aussi de se créer une « boite à outils » contenant des fonctions appelées depuis
plusieurs programmes.
Finalement, un module permet de bénéficier du travail déjà effectué, maximisant ainsi la réutilisabilité du code.
Modules et fichiers
À retenir
Si les modules représentent un moyen d’organiser logiquement le code
Python, les fichiers permettent quant à eux d’organiser physiquement le
code.
À cette fin, chaque fichier est considéré comme un module individuel,
et réciproquement. Le nom de fichier d’un module est le nom du module
auquel on ajoute l’extension.py.
Un module peut contenir tout objet Python: variables, fonctions,
classes, …
Chemin de recherche et recherche de fichiers
L’importation de modules requiert un processus nommé chemin de recherche .
C’est une procédure de recherche dans un ensemble de répertoires (dossiers) du système
de fichiers — le résultat de cette recherche dépend donc de l’installation de Python et du système d’exploitation utilisé — pour trouver le fichier module:
Puisque le chemin de recherche consiste à construire une liste de
répertoires (dossiers), il est possible de la modifier. La méthode de liste append()
permet d’importer un module situé dans un répertoire absent du chemin de
recherche:
Il n’est pas nécessaire de modifier le chemin de recherche si le fichier
module se trouve dans le même répertoire que le fichier source
contenant le code qui importe le module.
Portée des variables et espaces de noms
À retenir
La portée d’un identificateur est la portion du programme à laquelle sa
déclaration s’applique. On emploie également le terme de visibilité .
Les variables définies dans une fonction ont une portée locale, celles
définies au plus haut niveau d’un module ont une portée globale.
À retenir
Les variables globales présentent une caractéristique notable : à moins
qu’elles n’aient été détruites, leur durée de vie est égale à celle du
script qui s’exécute. En revanche, les variables locales, comme le bloc de
pile dans lequel elles résident, sont temporaires et ne
« vivent » que le temps pendant lequel les fonctions dans
lesquelles elles sont définies sont actives.
Dans le cas où une variable locale porte le même nom qu’une variable
globale, c’est la variable locale qui est utilisée. Python cherche d’abord
dans l’espace de nom local avant de chercher dans l’espace de nom global.
Il est donc possible de « masquer » une variable globale, en utilisant une
variable locale de même nom.
Info
Lorsque l’interpréteur Python importe un module, les règles de portée
s’appliquent : si l’import se situe au niveau du module, sa portée est globale,
s’il se situe dans une fonction, sa portée est locale.
Import de modules
L’instruction import
À retenir
L’import d’un module nécessite l’emploi de l’instruction import. La syntaxe
est la suivante :
importos
Il est possible d’importer plusieurs modules :
importosimportsys
Lorsque l’interpréteur rencontre un import, le chemin de recherche est
utilisé pour accéder au module. Si celui-ci est trouvé, il est importé. Comme annoncé ci-dessus, les
règles de portée s’appliquent : si l’import se situe au niveau du module, sa
portée est globale, s’il se situe dans une fonction, sa portée est locale.
Avertissement
L’appel import amène le module dans l’espace de nom, pas les objets qu’il
contient. La notation . doit être utilisée afin d’utiliser ces objets.
Comment accéder à la liste des objets contenus dans un module ?
On peut utiliser la fonction dir :
>>>importos>>>dir(os)
Comment obtenir l’aide d’un module ?
On peut utiliser la fonction help :
>>>importos>>>help(os)
> Résultat de l'importation du module `os`. Aucune référence à l'attribut `name` n'existe dans l'espace de nom global.
Comment obtenir la liste de tous les modules importés par un programme ?
>>>dir()
L’expression from … import
À retenir
Il est possible d’importer des objets particuliers d’un module dans le
programme. L’objet appartient alors réellement à l’espace de nom du
programme.
>>>fromosimportname>>>print(name)posix
Remarque
Ce type d’import peut présenter de réels dangers dans un programme dont le nombre de lignes est important et dont le développement s’effectue sur une longue durée. Que se passe-t-il si, dans le programme principal, un attribut ou
une fonction portent le même nom que l’élément importé ?
Il existe une façon encore plus dangereuse d’utiliser l’expression from ... import ... :
>>>fromosimport*
Tous les objets contenus dans le module sont alors ajoutés à l’espace de nom
globale du programme.
Avertissement
Éviter le plus possible la forme d’importation : from nom_module import * !
L’instruction import … as
Il arrive que l’on souhaite importer un module ou un attribut de module
portant un nom déjà employé dans l’application, ou que ce nom ne convienne
pas parce qu’il est trop long. On peut changer le nom lié localement du module
et procéder ensuite comme avec le nom complet :
>>>importmatplotlib.pyplotasplt>>>plt.plot(x,y)
Import vs chargement
À retenir
Un module n’est incorporé dans l’espace de nom global qu’une seule fois, quel que soit le nombre de fois
où il est importé.
Exemple de création d’un module
Dans le fichier demo.py :
"""
Un module de démonstration.
"""# Fonctions du moduledefb()->str:"""
Affiche b.
""""return"b"defa()->str:"""Affiche a."""return"a"# Attributs (variables) du modulec=2d=2if__name__=="__main__":# test des fonctions du moduleassertb()=="b"# place des assert
Dans l’interpréteur intéractif, lancé depuis le dossier dans lequel on a enregistré le module demo.py :
Lorsqu’un problème intervient lors de l’exécution d’un programme (division
par zéro, tentative d’ouverture d’un fichier qui n’existe pas, erreur de
syntaxe, etc.), l’interpréteur passe dans un mode particulier dans lequel
il stoppe l’exécution du programme en cours et affiche une erreur :
Le message affiché contient le traceback, c’est à dire la pile d’appel — le chemin parcouru par l’interpréteur pour atteindre l’erreur (soit la liste des fonctions traversées pour atteindre l’erreur).
Ce message comporte le type d’exception levée (ZeroDivisionError, IOError, NameError, SyntaxError, etc.) et un message qui décrit le problème rencontré.
Remarque
Dans le cas d’une erreur de syntaxe, le message d’erreur indique même où est
détectée l’erreur à l’aide d’une flèche (en fait, elle se trouve
généralement juste avant l’endroit pointé par la flèche).
À retenir
Pour éviter que le programme ne se termine définitivement ou qu’il se
termine sans que la raison n’en soit explicite, il est conseillé de gérer
les exceptions.
Exemple : Gestion des entrées du clavier
>>>whileTrue:try:x=int(input("Entrer un nombre entier :"))breakexceptValueError:print("Oups ! Ce n'est pas un nombre. Nouvelle tentative")
À retenir
Le gestion des exceptions repose sur quelques mots clés : try, except, else
et finally et sur une liste de types d’exceptions dont la liste peut être
consultée dans la documentation en ligne de Python :
try : le bloc de code qui suit ce mot clé est exécuté séquentiellement.
En cas de problème, l’exécution est interrompue et l’interpréteur passe au
bloc d’instructions suivant le mot clé except.
except NomErreur : ce bloc d’instructions est exécuté si une erreur a
été détectée dans le bloc try et si son type correspond à NomErreur.
Plusieurs clauses except peuvent être utilisées. Il n’est pas nécessaire
d’indiquer le type de l’erreur (tous les types sont alors traités de façon
identique).
else : cette directive permet d’isoler dans la partie try la ou les
instructions qui peuvent poser problème. Toutes les instructions suivantes
(qui ne doivent donc être exécutées que si aucun problème intervient)
peuvent être placées dans le bloc else.
finally : le bloc qui suit est exécuté dans tous les cas de figure, qu’une
exception ait été levée ou pas. C’est donc ici que l’on peut s’assurer
qu’un fichier ouvert dans le bloc try est correctement fermé, quoi qu’il
arrive.
Exemple : Prise en compte de plusieurs erreurs
>>>try:f=open("fichier.txt",'r')s=f.readline()i=int(s.strip())exceptIOErroraserr:print("I/O Erreur : {0}".format(err))exceptValueError:print("Je ne suis pas parvenu à convertir en entier la donnée.")finally:f.close()
Utilisation de else
>>>try:f=open("fichier.txt",'r')exceptIOError :print("Je ne parviens pas à lire le fichier.")else:n=f.readlines()print("Le fichier comporte {0} lignes.".format(n))finally:f.close()
Les exceptions dans la définition d’une fonction
>>>defdivision(x,y):try:resultat=x/yexceptZeroDivisionError:print("Division par zero !")else:print("Le resultat est {0}".format(resultat))finally:print("Je suis toujours présent !")>>>division(2,1)Leresultatest2Jesuistoujoursprésent!>>>division(2,0)Divisionparzero!Jesuistoujoursprésent!
Tout fichier manipulé doit être correctement fermé. Il n’est donc pas
envisageable d’utiliser la fonction open sans gérer les exceptions. Utiliser
les instructions try, except et finally peut cependant apparaître
contre-productif (cela fait beaucoup de code pour une action courante). with
permet de manipuler les fichiers en étant certain qu’ils seront fermés
correctement, quoi qu’il arrive.
Écrire un module nommé convert_temp contenant les fonctions réalisant les conversions entre des températures exprimées en degrés Celsius, degrés Fahrenheit et Kelvin : C2F, F2C, C2K, K2C, F2K and K2F.
Appeler ces fonctions depuis un autre programme.
Physique, Chimie et Informatique > Terminales Spé. NSI > Modularité et robustesse du code
Cette séance a pour objectif de vous familiariser avec la création et la
manipulation de modules.
Info
Comme il est maintenant de tradition vous diviserez le code de votre programme
principal en trois parties:
Importation des modules ;
Définitions des fonctions ;
Partie principale (lieu d’appel des fonctions).
Vous documenterez aussi systématiquement vos fonctions (une aide sera
fournie dans les questions relatives à la définition de chacune de ces
fonctions).
En mathématique, on démontre qu’un capital placé à un certain taux
d’intérêt évolue selon la formule :
C=C0(1+360×100t)n
où C est le montant du capital considéré le jour de l’examen, C0 le
montant initial du capital, t le taux d’intérêt (en pourcentage) et n le
nombre de jours écoulés depuis le dépôt.
Remarque
Pour une durée de placement exprimée en jours, l’usage fait que l’intérêt est calculé sur la base de l’année financière ou commerciale comptant 360 jours et non pas l’année civile de 365 jours (ou 366 jours). Par ailleurs, lorsque la durée est exprimée en jours, les mois sont comptés à leur nombre exact de jours.
Selon le problème à résoudre on peut bien évidemment aussi écrire:
Créer un module, nommé capitalisation, qui contient les quatre
fonctions montant_actuel, montant_initial,
jours_ecoules et taux_annuel qui implémentent les quatre
expressions données ci-dessus.
Les spécification des fonctions sont les suivantes :
defmontant_actuel(C0:float,t:float,n:int)->float:"""
Cette fonction calcule, à partir du montant initial, du taux
d'intérêt et de la durée de dépôt, le montant actuel.
"""
defmontant_initial(C:float,t:float,n:int)->float:"""
Cette fonction calcule, à partir du montant actuel, du taux
d'intérêt et de la durée de dépôt, le montant initial déposé.
"""
defjours_ecoules(C0:float,C:float,t:float)->float:"""
Cette fonction calcule, à partir du montant initial, du montant
actuel et du taux d'intérêt, la durée écoulée en jours.
"""
deftaux_annuel(C0:float,C:float,n:int)->float:"""
Cette fonction calcule, à partir du montant initial, du montant
actuel et de la durée de dépôt (en jours), le taux annuel.
"""
Avertissement
Penser à gérer les exceptions (le module sys possède une fonction exit
qui permet d’interrompre proprement un programme lorsqu’on lui passe le
nombre 1 en argument).
Placer un commentaire au début du module qui décrit son fonctionnement.
Incorporer à ce module un bloc if __name__ == '__main__': permettant de
tester ces fonctions.
Choisir les valeurs suivantes pour les variables de test : C = 2.2133983053266699,
C0 = 2.0, t = 5.000000000000782, n = 730 et vérifier que chacune des fonctions
donne le bon résultat.
Écrire un programme qui importe le module créé.
Vérifier que les
commentaires intégrés au module sont accessibles à l’aide de la fonction
help().
À l’aide de ce programme, répondre aux questions suivantes :
On place 10 000 euros à 7 % d’intérêt. Quelle est la valeur du montant au
bout d’une année ?
On place 10 000 euros à 7 % d’intérêt. Au bout de quelle durée ce
montant est-il doublé ?
On place 10 000 euros. Au bout de 60 jours, le montant est de 10 042 euros.
À quel taux d’intérêt a été placée cette somme ?
Corrigé
"""
Module permettant d'effectuer des calculs de capitalisation
Variables : C est le montant à l'instant considéré, C0 est le
montant initial, t est le taux d'intérêt (en pourcentage) et n
le nombre de jours écoulés depuis le dépôt.
À partir de 3 paramètres, le 4ème peut être calculé à partir de :
C = montant_actuel(C0, t, n)
C0 = montant_initial(C, t,n)
n = jours_ecoules(C0,C,t)
t = taux_annuel(C0,C,n)
"""importsysfrommathimportlogdefmontant_actuel(C0:float,t:float,n:int)->float:"""
Cette fonction calcule, à partir du montant initial, du taux
d'intérêt et de la durée de dépôt, le montant actuel.
"""try:C=C0*(1+t/(360*100))**nexcept:print("Un des arguments passé à la fonction est incorrect. Fin du programme.")sys.exit(1)returnCdefmontant_initial(C:float,t:float,n:int)->float:"""
Cette fonction calcule, à partir du montant actuel, du taux
d'intérêt et de la durée de dépôt, le montant initial déposé.
"""try:C0=C*(1+t/(360*100))**(-n)except:print("Un des arguments passé à la fonction est incorrect. Fin du programme.")sys.exit(1)returnC0defjours_ecoules(C0:float,C:float,t:float)->float:"""
Cette fonction calcule, à partir du montant initial, du montant
actuel et du taux d'intérêt, la durée écoulée en jours.
"""try:n=log(C/C0)/log(1+t/(360*100))except:print("Un des arguments passé à la fonction est incorrect. Fin du programme.")sys.exit(1)returnndeftaux_annuel(C0:float,C:float,n:int)->float:"""
Cette fonction calcule, à partir du montant initial, du montant
actuel et de la durée de dépôt (en jours), le taux annuel.
"""try:t=360*100*((C/C0)**(1/n)-1)except:print("Un des arguments passé à la fonction est incorrect. Fin du programme.")sys.exit(1)returntif__name__=="__main__":C=2.2133983053266699C0=2.0t=5.000000000000782n=730# Test des fonctionsassertC==montant_actuel(C0,t,n)assertC0==montant_initial(C,t,n)assertn==jours_ecoules(C0,C,t)assertt==taux_annuel(C0,C,n)
Physique, Chimie et Informatique > Terminales Spé. NSI > Modularité et robustesse du code
La somme des inverses des carrés des nombres entiers converge vers 6π2.
k=1∑∞k21=6π2
On utilise cette formule pour trouver une approximation de π.
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
importmathdefterme(k:int)->float:return1/(k**2)defapproxpi(n:int)->float:s=0# utilise les termes jusqu’à 1/n**2 inclusforkinrange(n):s=s+terme(k)returnmath.sqrt(s*6)
Lors de l’exécution de approxpi(1000) une exception est levée à l’exécution de la ligne 4. Quel est le type d’exception ?
a. ValueError
b. SyntaxError
c. TypeError
d. ZeroDivisionError
e. IndexError
f. NameError
Bien que l’exécution soit interrompue ligne 4, la source de l’erreur est ailleurs
Expliquer d’où provient l’erreur et proposer un correctif.
Enquêter sur une erreur de calcul de produit scalaire
Le produit scalaire de deux vecteurs u et v de l’espace, de coordonnées respectives (u1,u2,u3) et (v1,v2,v3), est le nombre réel u1v1+u2v2+u3v3.
Le code suivant permet de calculer des produits scalaires. Il est testé sur des vecteurs de l’espace choisis au hasard :
importrandomfromtypingimportTupledefscalaire(v1:Tuple[int],v2:Tuple[int])->float:"""
Calcule le produit scalaire des deux vecteurs v1 et v2.
"""s=0forkinrange(len(v1)):s=s+v1[k]*v2[k]returnsdefrandom_vect(n:int)->tuple:"""
Génère un vecteur de taille n contenant des entiers non nuls
entre -10 et 10
"""v=[]foriinrange(n):val=random.randint(-10,10)ifval!=0:v.append(val)returntuple(v)defmain():foriinrange(20):print(scalaire(random_vect(3),random_vect(3)))main()
Prises séparément, les deux fonctions semblent opérationnelles :
En analysant le traceback donné plus haut, indiquer quel est le type d’exception qui a été levée, et sur quelle ligne de code.
Sur la ligne en question, qu’est-ce qui pourrait avoir provoqué l’erreur ?
Proposer d’ajouter un affichage print(...) à un endroit du programme pour essayer de mettre en évidence la nature du problème, puis exécuter à nouveau le code.
Expliquer l’erreur. Pourquoi ne se produit-elle pas toujours au même moment ?
Proposer un correctif.
Calculer la valeur d’un mot : arithmancie
On souhaite associer une valeur numérique à une chaîne de caractères. La valeur associée à la chaîne est la somme des valeurs associées à chacun des caractères qui la composent. Aux lettres non accentuées de A à Z, qu’elles soient en minuscules ou en majuscules, on associe leur numéro d’ordre dans l’alphabet, de 1 à 26. À tous les autres symboles (lettres accentuées, chiffres, espaces, ponctuations), on associe la valeur 0.
On rappelle que ord("a") donne le code numérique associé à la lettre "a" passée en paramètre.
La chaîne string.ascii_uppercase est définie dans le module string et vaut "ABCDEFGHIJKLMNOPQRSTUVWXYZ".
Pour chacune des propositions suivantes, proposer un test qui montre que la fonction ne répond pas au cahier des charges de l’énoncé.
Proposer un ensemble complet de tests pour la fonction que l’on veut créer (on nomme cette fonction valeur).
Proposer le code de cette fonction (il est possible de s’inspirer d’une des versions vues à la question 1. en la corrigeant). Ne pas oublier de vérifier que la fonction écrite passe bien les tests de la question 2.
Module d’arithmétique
Créer un module contenu dans un fichier nommé arithmetique.py. Ce module contient des fonctions sur l’arithmétique des nombres entiers. En particulier :
– expo qui prend en paramètres les entiers a, b et n et calcule le reste de la division par n de ab ;
– pgcd qui prend en paramètres les entiers a et b et renvoie le plus grand diviseur commun de a et b (définition du pgcd) ;
– decomposition qui prend un entier positif n en paramètre et renvoie la liste de ses facteurs premiers ainsi que leur multiplicité.
Créer le module avec les trois fonctions proposées.
Proposer des dosctrings pour le module et les trois fonctions décrites. Annoter les fonctions avec les annotations de type.
Ajouter quelques tests sous forme d’assertions.
Algorithme naïf pour la fonction decomposition
La première idée consiste à balayer la liste des nombres premiers en testant si le nombre premier p divise n. Si oui, on recommence l’algorithme pour n//p, en ne testant que les diviseurs premiers encore envisageables. On s’arrête quand le nombre premier à tester devient supérieur à la racine carrée du nombre qu’il est censé diviser.
Ainsi pour décomposer 2088 en produit de facteurs premiers
2088
2
2 divise 2088 le quotient est 1044
1044
2
2 divise 1044, le quotient est 522
522
2
2 divise 522, le quotient est 261
261
3
2 ne divise pas 261, mais 3 divise 261 et le quotient est 87
87
3
3 divise 87 et le quotient est 29
29
ni 3, ni 5 ne divisent 29 et 72 est plus grand que 29 (fin)
On obtient la décomposition attendue : 2088=23×32×29.
Une API (en anglais « Application programming interface ») est une interface de programmation d’application. Elle est destinée à être utilisée par des programmes. Le principe de ce type d’interface est le même que celui des UI (« User Interface ») ou des GUI (« Graphical User Interface ») destinées elles à un utilisateur humain.
Composée de constantes, de fonctions, de classes, elle sert de lien entre un programme et les programmes qui vont l’utiliser. Elle peut être proposée par un service web avec une documentation décrivant l’utilisation qui permettra la communication et l’échange des données. Il existe, par exemple, plusieurs API de géolocalisation qui peuvent être intégrées à des programmes. Une API est très souvent proposée par une bibliothèque logicielle composée de fonctions destinées à être utilisées dans divers programmes.
Le principe de base est que le fonctionnement interne n’a pas besoin d’être connu du programme utilisateur. Cela nécessite une documentation fournie décrivant précisément son l’utilisation. Ainsi, lors de l’élaboration d’un logiciel il est possible d’utiliser des parties d’autres logiciels, sans connaître leur fonctionnement interne, si l’on sait comment faire interagir ces différentes parties.
Par exemple, pour utiliser une fonction il suffit de connaître sa spécification, c’est à dire son nom, les types de ses paramètres et de la valeur qu’elle retourne et sa documentation. Dans tous les cas, l’utilisateur, un programme ou un humain, se contente de fournir les données demandées et obtient le résultat du traitement.
Travail à réaliser
Créer un module dont l’API est la suivante :
>>>help(aires)Helponmoduleaires:NAMEairesDESCRIPTIONFournituredefonctionscalculantlessurfacesdediversesfiguresgéométriques.FUNCTIONSdisque(rayon:float)->floatRenvoiel'aire du disque de rayon r.rectangle(largeur:float,longueur:float)->floatRenvoiel'aire d'unrectangledecôtéslargeuretlongueur.triangle(base:float,hauteur:float)->floatrenvoiel'aire d'untriangledebasebaseetdehauteurhauteur.DATApi=3.14159FILE/home/runner/aires/aires.py
Créer, de la façon qui semblera la plus pertinente, un jeu de tests des fonctions, dans ce module.
Écrire un programme principal qui utilise ce module.
Expliquer quelle est la différence entre les deux spécifications suivantes :
defdisque(rayon:float)->float:"""
Renvoie l'aire du disque de rayon r.
"""
et
defdisque(rayon:float)->float:"""
Renvoie l'aire du disque de rayon r.
HYPOTHÈSE: r > 0
"""
On souhaite prendre en charge les cas où l’utilisateur fournirait une dimension négative (erronée donc).
Modifier le code des fonctions de telle sorte qu’une exception de type ValueError soit levée chaque fois qu’une valeur négative est passée en argument.
Remarque : on pourra se renseigner sur l’utilisation du mot-clé raise.
Stabilité d’une API
Il est important, lorsqu’on souhaite faire évoluer une API, de faire en sorte que les utilisateurs qui l’utilisaient déjà, avant la modification, puissent toujours le faire sans avoir à modifier le programme ou voir celui-ci ne plus fonctionner.
Sauf décision volontaire qu’il faudra communiquer aux utilisateurs, l’évolution d’une API doit apporter de nouvelles fonctionnalités sans en retirer.
Par exemple, on pourrait vouloir proposer aux utilisateurs la possibilité d’arrondir le résultat du calcul d’une aire.
Modifier le code des différentes fonctions de façon à ce qu’il ressemble à celui de la fonction disque ci-dessous (la partie sur la levée de l’exception ValueError n’est pas insérée dans le code proposé).
Vérifier que le programme écrit à la question 3. fonctionne toujours sans aucune modification.
defdisque(rayon:float,dec:int=-1)->float:"""
Renvoie l'aire du disque de rayon r.
"""aire=pi*rayon*rayonifdec>=0:aire=round(aire,dec)returnaire
En déduire comment se comportent, en Python, les paramètres d’une fonction auxquels on attribue des valeurs dans la signature.
Dans le programme principal modifier l’appel à la fonction disque de telle sorte que le résultat de son calcul soit arrondi à deux chiffres après la virgule.
Le code utilise la fonction intégrée au langage Python round pour arrondir un float à un certain nombre de chiffres après la virgule.
Écrire sa propre fonction round en n’utilisant que les opérateurs *, /, +, ** et la fonction int.
Physique, Chimie et Informatique > Terminales Spé. NSI
Paradigmes de programmation
Au programme
Contenus
Capacités attendues
Commentaires
Paradigmes de programmation.
- Distinguer sur des exemples les paradigmes impératif, fonctionnel et objet. - Choisir le paradigme de programmation selon le champ d’application d’un programme.
Avec un même langage de programmation, on peut utiliser des paradigmes différents. Dans un même programme, on peut utiliser des paradigmes différents.
des règles de grammaire qui définissent la syntaxe des expressions ;
d’une sémantique qui définit le sens des expressions.
À retenir
Un langage peut être :
interprété : un interpréteur lit et analyse le code séquentiellement,le traduit en langage machine et lance son exécution.
compilé : un compilateur lit et analyse le code puis le traduit en langage machine. Par la suite l’exécutable généré peut être lancé.
Remarque : Python un langage interprété mais le code n’est pas directement traduit dans le langage machine de l’ordinateur sur lequel le programme est lancé mais dans le langage machine d’une machine virtuelle (bytecode). Dans un second temps, ce langage machine est interprété par le logiciel.
Avertissement
Un compilateur n’est pas obligé d’effectuer une lecture séquentielle du fichier contenant le code ; il peut donc davantage l’analyser (recherche d’erreurs de typage par exemple) et effectuer des optimisations.
Paradigme de programmation
À retenir
On appelle paradigme de programmation une façon de se représenter un problème informatique et sa résolution.
Le paradigme choisi a une très grande influence sur la manière de concevoir un programme, il constitue donc un des critères principaux pour le choix d’un langage.
Il existe un grand nombre de paradigmes de programmation, le programme de la NSI se concentre sur la programmation impérative, la programmation fonctionnelle et la programmation objet.
Certains langages sont très liés à certains paradigmes mais la plupart permettent de mettre en œuvre plusieurs paradigmes ; c’est le cas de Python :
En programmation impérative les opérations sont décrites en séquences d’instructions, dont l’ordre est déterminé par le programmeur, et donc l’objectif est la modification de l’état de la mémoire (variables).
Les « langages impératifs » sont les plus répandus parmi l’ensemble des langages de programmation et sont ceux qui sont les plus proches du fonctionnement des processeurs : exécuter une suite d’instructions élémentaires.
Info
Les instructions de base de ce paradigme sont :
la séquence d’instructions : les instructions sont exécutées les unes après les autres ;
l’assignation ou affectation : on stocke ou on modifie une information en mémoire (dans une variable) ;
l’instruction conditionnelle : un bloc d’instruction n’est effectué que si une certaine condition est réalisée ;
la boucle : une séquence d’instructions est répétée un certain nombre de fois (boucle Pour) ou jusqu’à ce qu’une condition soit réalisée.
les branchements : la séquence d’instruction est transférée à un autre endroit dans le code.
De nombreux langages incluent un goto permettant de réaliser un branchement ou la possibilité d’écrire des fonctions — qui ne sont dans ce cas qu’une suite d’instructions (et donc n’ont aucun sens mathématique).
Info
La programmation impérative s’appuie sur le modèle des machines à états, avec une mémoire centrale et des instructions qui modifient son état grâce à des affectations successives. Cela nécessite pour le programmeur d’avoir à tout instant un modèle exact de l’état de la mémoire que le programme modifie.
Mots clés pour repérer un langage impératif
affectation, mémoire, instruction, boucle, mutabilité, effets de bord, …
Lorsque le programme à réaliser s’exprime sous forme d’actions à réaliser. Les actions reflètent les changements dans l’environnement (mémoire) du programme.
Dans le cadre de la programmation système, pour une gestion manuelle, potentiellement fine, de l’allocation mémoire.
En programmation fonctionnelle un programme est considéré comme l’application (au sens mathématique du terme) d’une fonction à l’ensemble des données que le programme doit manipuler. Ce programme donne donc toujours le même résultat pour les mêmes données (pas d’effet de bord).
Info
La programmation fonctionnelle s’affranchit de façon radicale des effets de bord en interdisant toute opération d’affectation.
La manipulation de variables est remplacée par la composition de fonctions (boîtes noires imbriquées les unes dans les autres).
Les langages purement fonctionnels remplacent les boucles par la récursivité.
Les langages fonctionnels mettent tous en œuvre une gestion automatique de l’allocation mémoire.
Dans les langages fonctionnels les fonctions sont des citoyennes de première classe : une fonction peut recevoir une fonction comme argument, une fonction peut retourner une fonction.
Remarque
La mise en œuvre des langages fonctionnels fait un usage sophistiqué de la pile (cf. chapitre 1 sur la récursivité et chapitre sur la structure de pile) car, afin de s’affranchir de la nécessité de stocker des données temporaires dans des tableaux, ils font largement appel à la récursivité. L’une des multiples techniques pour rendre la compilation de la récursivité plus efficace est une technique dénommée récursion terminale (en anglais : tail-recursion), qui consiste à accumuler les résultats intermédiaires dans une case mémoire de la pile et à la passer en paramètre dans l’appel récursif. Ceci permet d’éviter d’empiler les appels récursifs dans la pile en les remplaçant par une simple succession de sauts. Le code généré par le compilateur est alors similaire à celui généré par une boucle en impératif.
La programmation fonctionnelle éliminant les effets de bord (fonctions pures), il est plus facile de faire effectuer des calculs en parallèle aux programmes développés dans un style fonctionnel pur.
Mots clés pour repérer un langage impératif
déclaratif, expressions, immutabilité, ordre supérieur, λ-calcul, fonction pure, …
Exemples de langages fonctionnels
Haskell, Lisp, Scheme, OCaml, …
Usage typique
Manipulations de haut niveau ;
Calculs algébriques, abstraits ;
Écriture de compilateurs.
Comparaison des deux styles de programmation
Exercice 1 : illustration des différences entre les style impératif et fonctionnel
Définir une fonction qui réalise la somme des nombres d’une liste passée en argument,
En style impératif.
En style fonctionnel.
Style impératif
1
2
3
4
5
6
7
8
defsomme(liste:list[float])->float:"""
Calcule la somme des éléments de la liste liste.
"""somme=0fornbreinliste:somme=somme+nbrereturnsomme
Cette fonction manipule la variable locale somme et utilise une boucle for. Le paradigme utilisé est bien impératif.
Style fonctionnel
1
2
3
4
5
6
7
8
defsomme(liste:list[float])->float:"""
Calcule la somme des éléments de la liste liste.
"""iflen(liste)==0:return0else:returnliste[0]+somme(liste[1:])
Cette fonction ne manipule aucune variable et n’utilise pas de boucle mais la récursivité. Le paradigme employé est bien fonctionnel.
Remarque :liste[1:] est une sous-liste de liste dans laquelle le premier élément de liste n’est pas présent.
Style fonctionnel avec récursion terminale
1
2
3
4
5
6
7
8
defsomme(liste:list[float],total:float=0)->float:"""
Calcule la somme des éléments de la liste liste.
"""iflen(liste)==0:returntotalelse:returnsomme(liste[1:],liste[0]+total)
Avertissement
L’utilisation de la récursivité, seule, n’implique pas forcément que le paradigme de programmation utilisé est fonctionnel. Il faut regarder l’ensemble du programme.
Exercice 2 : un exemple de fonction non pure
Écrire une fonction (sans grand intérêt !!!) dont la spécification est la suivante :
defelevation_puissance(n:int)->float:"""
Retourne le nombre demandé à l'utilisateur à la puissance n.
"""
1
2
3
4
5
6
7
defelevation_puissance(n:int)->float:"""
Retourne le nombre demandé à l'utilisateur à la puissance n.
"""x=float(input("Veuillez entrer le nombre à élever à la puissance n : "))returnx**n
Il est évident que deux appels successifs à la fonction elevation_puissance avec le même argument (2 par exemple) pourront renvoyer des valeurs différentes puisque celles-ci dépendent de la valeur entrée par l’utilisateur. Cette fonction n’est pas une fonction pure ; sa définition n’est pas acceptable du point de vue de la programmation fonctionnelle.
Exercice 3 : illustration d’un effet de bord
Définir une fonction qui élève au carré chaque élément d’une liste.
En style impératif (avec effet de bord possible).
En style fonctionnel (sans effet de bord).
Style impératif avec effet de bord.
1
2
3
4
5
6
7
8
9
defliste_carre(liste:list[float])->None:"""
Élève au carré chaque élément de la liste liste.
"""foriinrange(len(liste)):liste[i]=liste[i]**2l=[1,2,3,4]liste_carre(l)
La fonction modifie la liste globale liste ! Le problème a pour origine la mutabilité de la structure de données « liste » et le passage d’une référence à la fonction, et non pas une copie de cette liste.
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
defliste_carre(liste:list[float])->list[float]:"""
Élève au carré chaque élément de la liste liste.
"""newList=liste[:]defeleve_carre(liste:list[float])->list[float]:iflen(liste)==0:returnlisteelse:return[liste[0]**2]+eleve_carre(liste[1:])returneleve_carre(newList)
On copie dans un premier temps la liste et on agit sur cette nouvelle liste.
À noter que cette copie n’était dans l’absolu pas nécessaire car l’opérateur + appliqué à des opérandes du type « séquence » génère une nouvelle liste en Python.
Programmation objet
À retenir
La programmation objet s’inspire du monde réel dans lequel des objets créés à partir de patrons (ou moules) interagissent les uns avec les autres.
Mettre en œuvre ce paradigme nécessite donc de modéliser le problèmepar une interaction d’objets dont on définit les caractéristiques.
À retenir
Un objet possède un état (des champs ou attributs) et un comportement (des méthodes).
Une classe est un patron permettant de fabriquer des objets.
Une classe est aussi la définition d’un nouveau type de données.
L’un des objectifs principaux de la notion d’objet est d’organiser des programmes complexes grâce aux notions :
d’encapsulation ;
d’abstraction ;
d’héritage ;
de polymorphisme ;
Remarque : Seules les deux premières notions apparaissent dans le programme de NSI.
Encapsulation
Le principe de l’encapsulation est de regrouper dans le même objet, les données (attributs) et les traitements (méthodes) qui lui sont spécifiques. Ainsi un objet est défini par ses attributs et ses méthodes.
Les objets partagent tous les mêmes méthodes mais les attributs leurs sont propres.
Abstraction
L’intérêt de la POO est qu’elle permet de créer des objets possédant un certain degré d’abstraction.
Ce processus d’abstraction consiste à identifier des caractéristiques et des mécanismes communs pour un ensemble d’éléments.
Attributs
Ce sont les données de l’objets, ses caractéristiques.
Méthodes
Ce sont les comportements de l’objet.
Héritage
Le concept d’héritage permet de créer des sous-classes plus spécialisées à partir de classes plus générales (appelées super-classe).
La super-classe (classe mère) déclare des méthodes et des attributs communs.
La sous-classe hérite des attributs, des méthodes et du type de la super-classe et peut les redéfinir (cf. polymorphisme).
Polymorphisme
Le polymorphisme est la faculté pour une méthodeportant le même nom mais appartenant à des classes distinctes héritées d’effectuer un travail différent.
Cette propriété est acquise par la technique de la surcharge.
Dans ce premier exemple, on considère une classe qui modélise un compte bancaire.
Une classe est un nouveau type et un objet est une instance de classe
Taper et exécuter le code suivant :
classCompte:"""
Modélisation d'un compte bancaire.
"""pass
Info
Un nom de classe commence toujours (c’est une convention) par une lettre capitale ;
pass est l’instruction Python qui indique de ne rien faire.
Quelles actions a déclenché le code précédent ?
Réponse
Création d’un objet Classe Compte ;
Création d’une variable Compte dans l’espace de nom global. Cette variable référence l’objet Classe Compte
À la suite, taper et exécuter le code suivant :
compte_1=Compte()
Quelle action a déclenché le code précédent ?
Réponse
Création d’un objet (ou instance) de la classe Compte ;
Création d’une variable compte_1 dans l’espace de nom global. Cette variable référence l’objet.
Afin d’en découvrir davantage sur compte_1, taper et exécuter l’instruction suivante :
print(compte_1)
Que nous apprend l’affichage à l’écran ?
Réponse
<__main__.Compte object at 0x7f7cc89bec88>
compte_1 appartient à l’espace de nom global et référence un objet de type Compte situé à l’adresse 0x7f7cc89bec88.
« Définir une classe est équivalent à définir un nouveau type. »
Quelle instruction Python pourrait démontrer cette affirmation ?
Réponse
print(type(compte_1))
Un objet possède des attributs dont les valeurs lui sont propres
Un compte bancaire possède généralement un propriétaire et un solde. Taper et exécuter les lignes de code suivantes :
compte_1.proprietaire="Pascal"compte_1.solde=1000
Les attributs (ou variable) proprietaire et solde appartiennent-ils à l’espace de nom global ?
Réponse
À retenir
Les attributs sont des variables locales à l’objet.
Taper et exécuter les instructions qui permettent de créer un objet compte_2 dont le propriétaire se nomme « Natacha » et dont le solde est de 2000.
Réponse
Les objets compte_1 et compte_2 partagent-ils les valeurs des attributs ?
Réponse
Les attributs sont des variables locales à l’objet.
À retenir
Deux instances d’une même classe ne partagent pas leurs attributs.
Un objet possède un comportement
Modifier le code de définition de la classe de façon à ce qu’il soit :
classCompte:"""
Modélisation d'un compte bancaire.
"""defretrait(self,valeur:float)->None:"""
Retire valeur au solde.
"""self.solde=self.solde-valeur
La fonction retrait est appelée méthode. Quelle est sa particularité ?
Réponse
La fonction retrait est locale à la classe ; c’est la raison pour laquelle on parle de méthode.
La méthode retrait est-elle locale à chaque objet ?
Réponse
À retenir
Les objets instances d’une même classe partagent les méthodes.
Natacha vient de retirer 50. Le code qui permet de prendre en compte ce retrait dans le programme est
compte_2.retrait(50)
Observer l’effet de l’instruction.
N’y a-t-il rien de surprenant dans l’appel de la méthode retrait ?
Réponse
La définition de la méthode retrait fait apparaître deux paramètres : self et valeur alors que lors de l’appel de la fonction on ne fournit qu’un seul argument qui semble être valeur.
À quoi peut bien servir le paramètre self dans la définition d’une méthode ?
Réponse
Info
Les méthodes étant partagées par les différentes instances (objets) d’une classe, elle ne peuvent à priori pas savoir sur quel objet elle doivent agir.
L’information sur cet objet est donc passée automatiquement par Python à la méthode. Pour être plus clair, l’instruction
compte_2.retrait(50)
est équivalente à
Compte.retrait(compte_2,50)
À retenir
Lorsqu’on définit une méthode, le premier paramètre doit toujours être nommé self (c’est une convention). Il représente l’objet sur lequel la méthode doit agir.
Créer l’objet compte_3 et lui retrirer le montant 100. Quel est le problème ?
Réponse
compte_3=Compte()compte_3.retrait(100)
On obtient l’erreur suivante :
AttributeError: 'Compte' object has no attribute 'solde'
C’est tout à fait normal car l’objet compte_3 ne possède par d’attribut solde.
Les attributs d’un objet doivent être initialisés à la création de cet objet
Modifier le code de la classe Compte :
classCompte:"""
Modélisation d'un compte bancaire.
"""def__init__(self,proprietaire:str="",solde:float=0)->None:self.proprietaire=proprietaireself.solde=soldedefretrait(self,valeur:float)->None:"""
Retire valeur au solde.
"""self.solde=self.solde-valeur
Est-ce que l’erreur apparue à la question 12. est toujours présente ?
Afin de bien comprendre le rôle de la méthode __init__, créer le compte compte_4. À quoi sert cette méthode ?
Réponse
La méthode permet d’initialiser l’objet : ses attributs sont automatiquement créés, des valeurs par défaut peuvent même leur être affectées.
Toutes les variables ne sont pas des attributs
Essayer d’imaginer comment déterminer simplement le nombre de comptes créés.
Réponse
L’idéal serait qu’un compteur compte soit incrémenté chaque fois qu’un compte est créé.
Modifier le code de la classe Compte :
classCompte:"""
Modélisation d'un compte bancaire.
"""nbre_comptes=0def__init__(self,proprietaire:str="",solde:float=0)->None:self.proprietaire=proprietaireself.solde=soldedefretrait(self,valeur:float)->None:"""
Retire valeur au solde.
"""self.solde=self.solde-valeur
La variable nbre_comptes est-elle locale aux objets ? Est-elle locale à la classe ?
Réponse
La variable nbre_comptes est locale à la classe : c’est une variable de classe.
À retenir
Les variables de classe sont partagées par tous les objets.
Modifier le code de la classe Compte :
classCompte:"""
Modélisation d'un compte bancaire.
"""nbre_comptes=0def__init__(self,proprietaire:str="",solde:float=0)->None:Compte.nbre_comptes=Compte.nbre_comptes+1self.proprietaire=proprietaireself.solde=soldedefretrait(self,valeur:float)->None:"""
Retire valeur au solde.
"""self.solde=self.solde-valeur
Comment manipule-t-on une variable de classe ?
Réponse
À retenir
Pour manipuler une variable de classe, il faut précéder son nom du nom de la classe.
Dans un module nommé personne, créer la classe Personne dont la spécification est la suivante :
classPersonne:"""
Modélisation d'une personne.
Attributs
---------
- nom : str
Renseigné à la création de l'objet
- Prenom : str
Renseigné à la création de l'objet
- email : str
Email. Initialisé à ""
- telephone : str
Numéro de téléphone. Initialisé à ""
- date_naissance : str
Chaîne de caractères au format jour/mois/année (4 chiffres). Initialisé à ""
- jour_naissance : int
Déterminé à partir de la date de naissance. Initialisée à -1
- mois_naissance : int
Déterminé à partir de la date de naissance. Initialisée à -1
- annee_naissance : int
Déterminé à partir de la date de naissance. Initialisée à -1
"""
Les spécifications des méthodes sont les suivantes :
def__init__(self,nom:str,prenom:str)->None:"""
Initialisation des attributs.
"""
defmodifier_nom(self,nom:str)->None:"""
Permet de modifier le nom de la personne.
"""
defobtenir_nom(self)->str:"""
Retourne le nom de la personne.
"""
defmodifier_prenom(self,prenom:str)->None:"""
Permet de modifier le prénom de la personne.
"""
defobtenir_prenom(self)->str:"""
Retourne le prénom de la personne.
"""
defobtenir_email(self)->str:"""
Retourne l'email de la personne.
"""
defrenseigner_email(self,email:str)->None:"""
Renseigne l'attribut email de la personne.
"""
defobtenir_telephone(self)->str:"""
Retourne le numéro de téléphone de la personne.
"""
defrenseigner_telephone(self,telephone:str)->None:"""
Renseigne l'attribut telephone de la personne.
"""
defrenseigner_date_naissance(self,date:str)->None:"""
Récupère la date de naissance sous la forme jour/mois/année.
Renseigne l'attribut date_naissance et, après un traitement, les attributs
jour_naissance, mois_naissance, annee_naissance.
Lève une exception de type ValueError si l'année ne possède pas le bon format.
"""
defobtenir_date_naissance(self)->str:"""
Retourne la date de naissance.
"""
defobtenir_age(self,annee_en_cours:int)->int:"""
Retourne l'age de la personne à partir de l'année en cours.
Lève une exception de type Exception si la date de naissance n'a pas été renseignée au préalable.
"""
La méthode infos suivante doit aussi faire parti de cette classe :
definfos(self)->str:"""
Retourne toutes les informations relatives à la personne.
"""chaine="""
Prénom : {} Nom : {} Date de naissance : {} Email : {} Téléphone : {} """.format(self.obtenir_prenom(),self.obtenir_nom(),self.obtenir_date_naissance(),self.obtenir_email(),self.obtenir_telephone(),)returnchaine
Avertissement
Tester la classe en instanciant au moins un objet de type Personne et en utilisant toutes les méthodes.
Classe Compte_bancaire
Dans un module nommé compte_bancaire créer la classe Compte_bancaire dont la spécification est la suivante :
classCompte_bancaire():"""
Définition d'un compte bancaire.
Attributs
---------
- proprietaire : Personne
Personne propriétaire du compte. Initialisé à la création de l'objet.
- identifiant : int
Identifiant unique du compte. Initialisé à la création de l'objet par un calcul réalisé par une méthode statique.
- solde : float
Solde du compte. Initialisé à la création de l'objet.
Les spécifications des méthodes sont les suivantes :
Avertissement
Ne pas oublier d’importer la classe Personne du module personne au début du fichier.
def__init__(self,proprietaire:Personne,montant_initial:float)->None:"""
Initialisation des attributs.
"""
@staticmethoddefdetermine_id(proprietaire:Personne)->int:"""
Détermine l'identifiant du compte aléatoirement à partir du
nom et du prénom du propriétaire.
Méthode statique
"""
defobtenir_solde(self)->float:"""
Retourne le solde du compte.
"""
defdepot(self,montant:float)->None:"""
Ajoute montant au solde
"""
defretrait(self,montant:float)->None:"""
Retire le montant montant du solde à la condition qu'il y ait suffisamment d'argent.
Une exception de type ValueError est levée si le montant est trop important
"""
La méthode infos suivante fait aussi partie de la classe :
definfos(self)->str:"""
Informations sur le compte.
"""chaine="""
Compte numéro : {} Solde : {} """.format(self.identifiant,self.solde)chaine=chaine+self.proprietaire.infos()returnchaine
Avertissement
Tester la classe en instanciant au moins un objet de type Compte_bancaire et en utilisant toutes les méthodes.
Classe Banque
Cette classe est de loin la moins développée du document, vous pourrez ajouter des méthodes selon vos idées.
Dans un module nommé banque, créer la classe Banque dont la spécification est la suivante :
classBanque:"""
Modélisation d'une banque.
Attributs
---------
- nom : str
Nom de la banque. Initialisé lors de la création de l'objet.
- comptes : Liste[Compte_bancaire]
Liste des comptes bancaires au sein de la banque.
"""
Avertissement
Ne pas oublier d’importer la classe Personne du module personne au début du fichier.
Ne pas oublier d’importer la classe Compte_bancaire du module compte_bancaire au début du fichier.
Les spécifications des méthodes sont les suivantes :
def__init__(self,nom:str)->None:"""
Initialisation de l'objet
"""
Incorporer les méthodes suivantes dans la classe :
defcreation_compte(self)->None:"""
Prend en charge l'ouverture d'un compte au sein de la banque.
"""print("Procédure de création du compte :")print("---------------------------------")nom=input("Nom du propriétaire du compte : ")prenom=input("Prenom du propriétaire du compte : ")montant_initial=float(input("Montant du dépôt initial : "))p=Personne(nom,prenom)c=Compte_bancaire(p,montant_initial)self.comptes.append(c)definfos(self)->str:"""
Informations sur la banque
"""chaine="""
-----------
"""forcompteinself.comptes:chaine=chaine+compte.infos()chaine="""
-----------
"""returnchaine
Programme principal
Dans le fichier nommé main, instancier un objet de type Banque et créer quelques comptes bancaires.
Définit une classe nommée Fraction pour représenter les nombres rationnels. Cette classe doit posséder deux attributs num et denom, de type entier, qui représentent respectivement le numérateur et le dénominateur du nombre rationnel.
On demande que le dénominateur soit un entier positif.
Écrire le constructeur de cette classe. Une exception de type ValueError doit être levée si le dénominateur n’est pas un nombre entier positif.
Ajouter une méthode __str__ qui renvoie une chaîne de caractères de la forme "12 / 7", ou simplement "12" lorsque le dénominateur vaut 1.
Ajouter les méthodes __add__ et __mul__ qui reçoivent une deuxième fraction et qui retournent un nouvel objet de type Fraction, représentant respectivement la somme et le produit de deux fractions.
Ajouter des méthodes __eq__ et __lt__ qui reçoivent une deuxième fraction et qui retournent True si la première fraction représente un nombre respectivement égal ou strictement inférieur à la deuxième fraction.
Avertissement
S’assurer que les fractions sont toujours sous forme réduite.
Remarque : jeu de tests possibles
f1=Fraction(4,2)print(f1)f2=Fraction(35,9)print(f2)# Addition de nombres rationnelsf3=f1+f2assertstr(f3)=="53 / 9"# Multiplication de nombres rationnelsf4=f1*f2assertstr(f4)=="70 / 9"# Test de l'égalité de deux nombres rationnelsf5=Fraction(2,1)assert(f1==f2)==Falseassert(f5==f1)==True# Teste si un nombre rationnel est plus petit qu'un autreassert(f1<f2)==Trueassert(f1<f5)==True# Test si réduction fonctionnef6=Fraction(48,6)print(f6)f7=Fraction(39,6)print(f7)
Résoudre un problème grâce aux paradigmes objet et fonctionnel
L’objectif de ce document est d’illustrer une fois encore l’intérêt des différents paradigmes de programmation.
Cas d’étude : fonction avec paramètres
On considère l’équation qui traduit le mouvement d’une balle lancée verticalement vers le haut avec une vitesse v0 depuis l’origine des altitudes telle que l’écrit un physicien :
y(t)=−21gt2+v0t
Ce physicien a donc tendance à considérer que y est une fonction de la variable t et que cette fonction dépend des paramètres v0 et g.
Comment définir cette fonction en informatique, sachant que g est un paramètre fixe g=9,81m/s2 mais que v0 est un paramètre qu’il peut être utile de faire varier ?
Réponse
defy(t:float,v0:float)->float:"""
Calcule l'altitude d'une balle lancée vers le haut verticalement avec la vitesse v0 au cours du temps depuis l'origine des altitudes.
REMARQUE : la fonction définit un paramètre constant g = 9.81
"""g=9.81return-0.5*g*t**2+v0*t
Problème
Le physicien qui vient de définir la fonction de la question 1. peut vouloir utiliser les fonctions que certains modules, tels que les modules math, numpy ou scipy, proposent. Ces fonctions étant les plus générales possibles, elles implémentent le point de vue du physicien, y est une fonction de t, plutôt que celui de l’informaticien, y est une fonction de t et de v0.
Comment modifier la définition de la fonction y pour qu’elle puisse être utilisée avec n’importe quelle autre fonction ?
Illustration du problème
On peut avoir envie de déterminer la vitesse vy(t) de la balle. La relation mathématique entre vy(t) et y(t) est la suivante
vy(t)=dtdy=y′(t)
vy(t) est la dérivée par rapport au temps de y(t).
On peut montrer, en analyse numérique, que, en un point d’abscisse x0
f′(x0)≈hf(x0+h)−f(x0)
Définir la fonction diff dont la spécification est :
defdiff(f:Callable,x0:float,h:float=1e-7)->float:"""
Calcule la dérivée de la fonction f au point d'abscisse x0.
REMARQUE : le paramètre h est fixé à h = 1e-7 par défaut.
"""
Réponse
defdiff(f:Callable,x0:float,h:float=1e-7)->float:"""
Calcule la dérivée de la fonction f au point d'abscisse x0.
REMARQUE : le paramètre h est fixé à h = 1e-5 par défaut.
"""return(f(x0+h)-f(x0))/h
Tester cette fonction en calculant la dérivée de cos(x) au point x=0.
Rappel :(cos(0))′=−sin(0)=0.
Réponse
importmathasmprint(diff(m.cos,0))
La fonction diff peut-elle être utilisée pour déterminer la dérivée de la fonction y ?
Réponse
Non, puisque diff ne prend que le nom de la fonction à dériver en argument et pas ses paramètres. diff suppose que la fonction f est une fonction à une seule variable.
Première (très mauvaise !) solution : utilisation d’une variable globale
Écrire la fonction y1 dont la spécification est
defy1(t:float)->float:"""
Calcule l'altitude d'une balle lancée vers le haut verticalement avec la vitesse v0 au cours du temps depuis l'origine des altitudes.
REMARQUE : la fonction définit un paramètre constant g = 9.81
REMARQUE : la fonction utilise la variable globale v0.
"""
Déterminer la valeur de la vitesse de la balle à la date t=0,1s en utilisant la fonction y1.
Remarque :v0=3m/s et la réponse attendue est vy=2,02m/s.
Réponse
v0=3t=0.1print(diff(y1,t))
Pourquoi est-ce une mauvaise idée que d’utiliser des variables globales ?
Réponse
Une variable globale peut être utilisée et modifiée à plusieurs endroits d’un programme. Il n’est pas toujours facile, lors de l’appel d’une fonction utilisant une variable globale, de savoir exactement quelle est sa valeur.
Deuxième méthode : représenter une fonction par une classe
Sans utilisation des méthodes spéciales
À retenir
Une classe définit un nouveau type et est constituée d’attributs (variables) et de méthodes (fonctions). Les attributs sont accessibles en lecture et en modification par toutes les méthodes ; ce sont des variables globale à la classe !
Définir la classe Y1 dont la spécification est
classY1:"""
Classe représentant la fonction mathématique y.
Attributs
---------
g : float
Paramètre g dont la valeur est fixée à l'initialisation de l'objet.
v0 : float
Paramètre v0 dont la valeur est récupérée à l'initialisation de l'objet.
Méthode
-------
valeur(self, t: float) -> float
Retourne la valeur de y à la date t passée en argument.
"""
Réponse
classY1:"""
Classe représentant la fonction mathématique y.
Attributs
---------
g : float
Paramètre g dont la valeur est fixée à l'initialisation de l'objet.
v0 : float
Paramètre v0 dont la valeur est récupérée à l'initialisation de l'objet.
Méthode
-------
valeur(self, t: float) -> float
Retourne la valeur de y à la date t passée en argument.
"""def__init__(self,v0:float,g:float=9.81)->None:self.v0=v0self.g=gdefvaleur(self,t:float)->float:"""
Retourne la valeur de y à la date t passée en argument.
"""return-0.5*self.g*t**2+self.v0*t
Créer un objet de type Y1 et vérifier que la valeur de la fonction y à la date t=0,1s, lorsque v0=3m/s est 0,25m.
Réponse
yo=Y1(3)print(yo.valeur(0.1))# ou assert yo.valeur(0.1) == y(0.1, 3)
Déterminer la vitesse de la balle à cet instant.
Réponse
yo=Y1(3)print(diff(yo.valeur,0.1))
En utilisant une méthode spéciale
On peut penser que la définition de la classe Y1 fait trop apparaître le concept d’objet au détriment de celui de fonction. En particulier, l’appel yo.valeur(0.1) n’est pas aussi clair que yo(0.1).
Les classes possèdent cependant, en Python, une méthode spéciale nommée __call__ appelée automatiquement chaque fois que l’on utilise un objet comme une fonction.
Définir la classe Y2 dont le code est proche de celui de Y1 mais qui redéfinit la méthode __call__ à la place de définir la méthode valeur.
Réponse
classY2:"""
Classe représentant la fonction mathématique y.
Attributs
---------
g : float
Paramètre g dont la valeur est fixée à l'initialisation de l'objet.
v0 : float
Paramètre v0 dont la valeur est récupérée à l'initialisation de l'objet.
"""def__init__(self,v0:float,g:float=9.81)->None:self.v0=v0self.g=gdef__call__(self,t:float)->float:"""
Retourne la valeur de y à la date t passée en argument.
"""return-0.5*self.g*t**2+self.v0*t
Déterminer la vitesse de la balle à dans les mêmes conditions qu’à la question 10.
Réponse
yo=Y2(3)print(yo(0.1))
Troisième méthode : premiers pas dans le monde fonctionnel
À retenir
En programmation fonctionnelle, les fonctions sont des objets de première classe : une fonction peut être passée comme argument à une autre fonction, une fonction peut retourner une fonction.
Qu’attend comme argument la fonction fixe_param ?
Réponse
fixe_param possède le paramètre v0.
Que sont les variables v0 et g pour la fonction calcule_y ?
Réponse
Ce sont des variables externes (non locales). En fait calcule_y les considère comme des variables globales (même si elles sont seulement locales à la fonction fixe_param). Le dernier point de ce document précise le vocabulaire.
Quel est le type de y3 ?
Réponse
y3 référence une fonction.
Que signifie l’instruction y3(0.1) ?
Réponse
y3(0.1) est un appel de fonction. On appelle la fonction référencée par la variable y3 avec l’argument 0.1.
Info
Utiliser le site Pythontutor pour bien comprendre l’effet de chacune des instructions.
Quelles lignes de code faudrait-il modifier si maintenant la balle est lancée à la vitesse v0=5m/s et que l’on cherche toujours sa position à la date t=0,1s ?
Réponse
y5=fixe_param(5)print(y5(0.1))
Quel est le rôle de la fonction fixe_param ?
Réponse
fixe_param enveloppe calcule_y, elle permet de réaliser une fermeture (closure).
À retenir
Dans un langage de programmation, une fermeture (en anglais : closure) est une fonction accompagnée de son environnement lexical. L’environnement lexical d’une fonction est l’ensemble des variables non locales qu’elle a capturé, soit par valeur (c’est-à-dire par copie des valeurs des variables), soit par référence (c’est-à-dire par copie des adresses mémoires des variables). Une fermeture est donc créée, entre autres, lorsqu’une fonction est définie dans le corps d’une autre fonction et utilise des paramètres ou des variables locales de cette dernière.
Le but de ce sujet est de réaliser en Python une implémentation du jeu de la vie en utilisant la programmation objet.
Info
Un automate cellulaire consiste en une grille régulière de « cellules » contenant chacune un « état » choisi parmi un ensemble fini et qui peut évoluer au cours du temps. L’état d’une cellule au temps t+1 est fonction de l’état au temps t
d’un nombre fini de cellules appelé son « voisinage ». À chaque nouvelle unité de temps, les mêmes règles sont appliquées simultanément à toutes les cellules de la grille, produisant une nouvelle « génération » de cellules dépendant entièrement de la génération précédente.
Le jeu de la vie a été inventé par le mathématicien britannique John H. Conway (1937-2020). C’est un exemple de ce qu’on appelle un automate cellulaire bidimensionnel. Il se déroule sur un tableau rectangulaire (L×H) de cellules. Une cellule est représentée par ses coordonnées x et y qui vérifient 0⩽x<L et 0⩽y<H.
Une cellule peut être dans deux états : vivante ou morte. La dynamique du jeu s’exprime par les règles de transition suivantes :
une cellule vivante reste vivante à la génération suivante si elle est entourée de 2 ou 3 voisines vivantes et meurt sinon ;
une cellule morte devient vivante à la génération suivante si elle possède exactement 3 voisines vivantes.
La notion de « voisinage » dans le jeu de la vie est celle des 8 cases qui peuvent entourer une case donnée (on parle de voisinage de Moore).
Pour implémenter la simulation, on va tout d’abord rechercher une modélisation objet du problème, puis procéder à son implémentation.
Avertissement
Chaque fonction/méthode devra posséder une spécification.
Modélisation objet
Quelles classes peut-on envisager au premier abord pour implémenter ce problème ?
Réponse
Les classes Grille et Cellule viennent facilement à l’esprit, on peut penser à une classe Etat représentant l’état d’une cellule si l’on veut pousser la modélisation un peu plus loin.
Quelles méthodes pourrait-on imaginer pour chaque classe ?
Réponse
Nous retrouverons ces méthodes dans l’implémentation, mais il faut au moins songer ici aux méthodes qui permettent de récupérer l’état interne des attributs et de les modifier. Il faut aussi penser à la représentation du voisinage d’une cellule et aux méthodes permettant de le modifier ou de le récupérer.
Dans quelle classe pouvons-nous représenter simplement la notion de voisinage d’une cellule ? Et le calculer ?
Réponse
Il peut être commode qu’une Cellule connaisse ses voisins, mais une Grille est plus à même de calculer les voisinages. On peut donc définir une méthode de calcul de voisinage dans la Grille et des méthodes pour affecter ou lire la liste des voisins dans la Cellule, ce qui lui permettra de calculer son état futur selon les règles du jeu de la vie.
Une cellule est au bord si x=0, x=L−1, y=0 ou y=H−1. Combien de voisins possède une cellule qui n’est pas au bord ?
Combien de voisins possède une cellule qui est au bord ?
Réponse
Une cellule qui n’est pas au bord possède 8 voisins. Une cellule qui est en bordure en possède 3 dans les angles ou 5 ailleurs sur les bords.
Que pourrions-nous aussi considérer comme voisin de droite de la case en haut et à droite de la grille ? Et comme voisin du haut ?
Réponse
Nous pourrions considérer que le voisin de la cellule en haut et à droite de la grille est la cellule en haut et à gauche. De même le voisin du haut de la case en haut à droite pourrait être la cellule en bas à droite de la grille (grille torique).
Implémentation du jeu
Avertissement
Chaque classe sera définie dans un fichier différent.
La classe Cellule
Implémenter tout d’abord une classe Cellule avec comme attributs :
un booléen actuel initialisé à False ;
un booléen futur initialisé à False ;
une liste voisins initialisée à None.
Remarque. La valeur False signifie que la cellule est morte et True qu’elle est vivante.
Ajouter les méthodes suivantes :
est_vivant qui renvoie l’état actuel (vrai ou faux) ;
set_voisins qui permet d’affecter comme voisins la liste passée en paramètre ;
get_voisins qui renvoie la liste des voisins de la cellule ;
naitre qui met l’état futur de la cellule à True ;
mourir qui permet l’opération inverse ;
basculer qui fait passer l’état futur de la cellule dans l’état actuel.
Ajouter à la classe Cellule une méthode __str__ qui retourne le caractère "X" si la cellule est vivante et un tiret "-" sinon.
Expliquer brièvement l’utilité d’une telle méthode __str__ en Python.
Ajouter une méthode calcule_etat_futur dans la classe Cellule qui permet d’implémenter les règles d’évolution du jeu de la vie en préparant l’état futur à sa nouvelle valeur.
La classe Grille
Créer la classe Grille et y définir les attributs suivants :
largeur (passé en argument) ;
hauteur (passé en argument) ;
matrix : un tableau de cellules à 2 dimensions implémenté en Python par une liste de listes.
Remarque : Définir la méthode set_matrix pour construire le tableau.
Remarque : Une nouvelle Cellule sera créée par l’appel Cellule().
Ajouter les méthodes :
dans_grille qui indique si un point de coordonnées i et j est bien dans la grille ;
set_cell_xy qui permet d’affecter une nouvelle cellule à la case (i,j) de la grille, si (i,j) est bien dans la grille ;
get_cell_xy qui permet de récupérer la cellule située dans la case (i,j) de la grille, si (i,j) est bien dans la grille ;
get_largeur qui permet de récupérer la largeur de la grille ;
get_hauteur qui permet de récupérer la hauteur de la grille ;
est_voisin une méthode statique qui vérifie si les cases (i,j) et (x,y) sont voisines dans la grille.
Ajouter une méthode get_voisins qui renvoie la liste des voisins d’une cellule.
Fournir une méthode set_voisins qui affecte à chaque cellule de la grille la liste de ses voisins.
Donner une méthode __str__ qui permet d’afficher la grille sur un terminal.
On veut remplir aléatoirement la Grille avec un certain taux de Cellule vivantes. Définir une méthode remplir_alea avec le taux (en pourcentage) en argument.
Le jeu
Définir une méthode jeu permettant de passer en revue toutes les Cellules de la Grille, de calculer leur état futur, puis une méthode actualise qui bascule toutes les cellules de la Grille dans leur état futur.
Dans le fichier principal, entrer le code suivant afin de lancer le jeu :
Chaque méthode définie devra être accompagnée de sa spécification.
Manipulation de points
On considère la classe nommée Point ayant les attributs suivants :
__abs : attribut privé de type float pour représenter l’abscisse du point ;
__ord : attribut privé de type float pour représenter l’ordonnée du point.
Définir la class Point et le constructeur __init__ permettant d’initialiser les deux attributs.
Info
L’encapsulation est un concept fondamental de la conception objet. L’idée est de ne pas laisser accessibles les attributs depuis l’extérieur de la classe/objet ; les attributs sont alors dits privés (ou protégés si l’accès est nécessaire dans une sous-classe).
En Python, par convention, le nom des attributs privés commence par __.
L’accès et la modification des attributs nécessitent alors la définition de méthodes appellées getters et setters.
Les noms de ces méthodes sont, par exemple pour l’attribut __abs, get_abs et set_abs.
Définir les getters et les setters pour les deux attributs.
Modifier la méthode __init__ de façon à ce qu’elle utilise les setters.
Définir la méthode __str__ qui retourne la représentation mathématique d’un point sous forme d’une chaîne de caractères : "(abs, ord)".
Définir la méthode calcul_distance qui calcule la distance du point courant à un point passé en argument.
La signature de la fonction est calcul_distance(self: Point, p: Point) -> float.
Info
On rappelle que la distance entre deux points A(x1,y1) et B(x2,y2) est égale à : (x2−x1)2+(y2−y1)2.
Définir la méthode calcul_milieu qui retourne un objet situé à égale distance du point courant et d’un point passé en argument.
La signature de la fonction est calcul_milieu(self: Point, p: Point) -> Point.
Info
On rappelle que la point situé à égale distance de deux points A(x1,y1) et B(x2,y2) a pour coordonnées xM=2x1+x2 et yM=2y1+y2.
On considère maintenant la classe nommée TroisPoints ayant les attributs suivants :
__premier : attribut privé de type Point ;
__deuxieme : attribut privé de type Point ;
__troisieme : attribut privé de type Point ;
Définir la class TroisPoints et le constructeur __init__ permettant d’initialiser les trois attributs.
Définir les getters et les setters pour les trois attributs.
Modifier la méthode __init__ de façon à ce qu’elle utilise les setters.
Définir la méthode sont_alignes qui retourne True si les trois points sont alignés, False sinon.
La signature de la fonction est sont_alignes(self) -> True.
Info
On rappelle que trois points A, B et C sont alignés si AB=AC+BC ou si AC=AB+BC ou si BC=AC+AB (AB, AC et BC sont des distances).
Définir la méthode est_isocele qui retourne True si les trois points forment un triangle isocèle et False sinon.
Info
On rappelle qu’un triangle est isocèle si AB=AC ou AB=BC ou AC=BC (AB, AC et BC sont des distances).
(Facultatif car HP) Implémenter une version statique (méthodes décorées par le décorateur @staticmethod) des deux méthodes calcul_distance et calcul_milieu.
Tester tous les objets et méthodes depuis la fonction main du programme.
Carnet d’adresses
On considère les deux classes Personne et Adresse.
Les attributs de la classe Adresse sont :
__rue : un attribut privé de type chaîne de caractères.
__ville : un attribut privé de type chaîne de caractères.
__code_postal : un attribut privé de type chaîne de caractères.
Les attributs de la classe Personne sont :
__nom : un attribut privé de type chaîne de caractères.
__sexe : un attribut privé de type chaîne de caractères (cet attribut aura comme valeur soit
’M’ soit ’F’).
__adresses : un attribut privé de type tableau d’objet de la classe Adresse.
Définir les deux classes Adresse et Personne dans deux fichiers différents. Ne pas oublier de
définir les getters/setters et les constructeurs.
Définir une troisième classe ListePersonnes ayant un seul attribut personnes : un tableau
d’objets Personne.
Définir les getters/setters et le constructeur de cette classe. La signature de la fonction set_personnes est set_personnes(self, p: Personne) -> None.
Définir la méthode recherche_par_nom, de signature recherche_par_nom(n: str) -> Personne, qui permet de chercher dans le tableau personnes si l’attribut __nom d’un objet de type Personne est égal à la valeur du paramètre n. Si c’est le cas, la méthode retourne le premier objet correspondant, sinon None.
Définir la méthode test_code_postal, de signature test_code_postal(cp: str) -> bool qui permet de vérifier dans le tableau personnes si un objet possède au moins une adresse dont le code postal égal au paramètre cp. Si c’est le cas, elle retourne True, sinon False.
Définir la méthode compte_personne_ville, de signature compte_personne_ville(ville: str) -> int, qui permet de calculer le nombre d’objets dans le tableau personnes ayant une adresse dans la ville passée en paramètre.
Définir la méthode edit_personne_nom, de signature edit_personne_nom(ancien_nom: str, nouveau_nom: str) -> None, qui remplace les noms
de personnes ayant un nom égal à la valeur ancien_nom par nouveau_nom.
Définir la méthode edit_personne_ville, de signature edit_personne_ville(nom: str, nouvelle_ville: str) -> None, qui remplace les villes
de personnes ayant un nom égal à la valeur du paramètre nom par nouvelle_ville.
Dans la fonction main, tester toutes les méthodes réalisées dans les questions précédentes.
Écrire le code de la classe Domino telle que le constructeur initialise les variables gauche et droite.
Penser à définir et utiliser une fonction verifie_valeur dont la spécification est
defverifie_valeur(self,val:int,cote:str)->int:"""
Vérifie que la valeur attribuée au Domino est correcte.
Dans le cas contraire, lève une exception.
"""
Écrire le code de la fonction est_double dont la spécification est
defest_double(self:Domino)->bool:"""
Teste si le domino est double.
"""
Écrire le code de la fonction est_blanc dont la spécification est
defest_blanc(self:Domino)->bool:"""
Teste si le domino est blanc, c'est à dire si ces valeurs gauche et
droite sont nulles.
"""
Écrire le code de la fonction nbre_points dont la spécification est
defnbre_points(self:Domino)->int:"""
Compte le nombre de points.
"""
Écrire le code de la classe JeuDominos dont le constructeur initialise la variable nbre_pieces à 28 et crée la variable jeu de type liste de dominos.
Définir la fonction creation_jeu dont l’objet est la création du jeu.
Écrire le code de la fonction melanger dont la spécification est
defmelanger(self:JeuDominos)->None:"""
Mélange aléatoirement le jeu de dominos.
"""
Écrire le code de la fonction distribuer dont la spécification est
defdistribuer(self:JeuDominos,nbre_joueurs:int)->List[Domino]:"""
Extractions des dominos attribués à un joueur de la liste des dominos et retour des dominos attribués à ce joueur.
"""
Écrire le code de la fonction affiche_jeu dont la spécification est
defaffiche_jeu(self:JeuDominos)->None:"""
Affiche le jeu ou la pioche en fonction de l'avancée du jeu.
"""
Initialiser le jeu, et le mélanger.
Pour le joueur 1, utiliser le code suivant
print("Joueur 1")print("========")jeu_j1=jeu.distribuer(2)points_joueur_1=0nbre_dominos_blancs_j1=0nbre_dominos_doubles_j1=0fordominoinjeu_j1:print(domino)points_joueur_1+=domino.nbre_points()ifdomino.est_blanc():nbre_dominos_blancs_j1+=1ifdomino.est_double():nbre_dominos_doubles_j1+=1print(f"{points_joueur_1} points possibles, dont {nbre_dominos_blancs_j1} dominos blancs et {nbre_dominos_doubles_j1} dominos doubles.")
Adapter le code précédent pour le joueur 2.
Afficher la pioche.
Physique, Chimie et Informatique > Terminales Spé. NSI
Programmation fonctionnelle
Au programme
Contenus
Capacités attendues
Commentaires
Paradigmes de programmation.
- Distinguer sur des exemples les paradigmes impératif, fonctionnel et objet. - Choisir le paradigme de programmation selon le champ d’application d’un programme.
Avec un même langage de programmation, on peut utiliser des paradigmes différents. Dans un même programme, on peut utiliser des paradigmes différents.
S’il n’est pas facile de répondre précisément à cette question, on peut essayer de mettre en évidence les idées que le paradigme fonctionnel promeut :
Les fonctions doivent être des objets de première classe, c’est à dire que les fonctions doivent pouvoir être passées comme arguments à une fonction, les fonctions doivent aussi pouvoir être retournées par une fonction.
Les fonctions doivent (le plus possible) être pures, c’est à dire ne générer aucun effet de bord.
La manipulation de variable doit être la plus limitée possible : il est possible de s’en servir comme étiquettes mais le contenu de ces variables doit être le moins modifié possible.
Les fonctions doivent permettre la composition : la valeur d’une fonction est passée comme argument à une fonction dont la valeur est passée comme argument à une autre fonction, …
En fait, le programme lui-même est évalué et retourne une valeur.
La récursion doit être utilisée à la place des boucles puisqu’il n’est pas question de modifier l’état d’un programme (donc la valeur d’un compteur de boucle, par exemple).
Les listes (c’est même l’origine du langage Lisp) sont souvent la structure de données de base des programmes fonctionnels.
Il n’est cependant pas question de modifier ces listes (méthode append).
Découverte des quelques éléments de programmation fonctionnelle
Suite de Collatz
On peut générer la suite de Collatz, pour un entier n donné, de la sorte :
si n est pair, on le divise par 2 ;
sinon on le multiplie par 3 et on ajoute 1.
On stoppe le processus lorsque la valeur de n est égale à 1.
La définition de la suite est donc :
un+1={2un3un+1si un est pairsinon.
Récursivité
Définir la fonction dont la spécification est :
defcollatz_iter(n:int)->None:"""
Implémentation de l'algorithme itératif qui permet de déterminer la suite de Collatz".
La fonction affiche les termes.
"""
Solution
defcollatz_iter(n:int)->None:"""
Implémentation de l'algorithme itératif qui permet de construire la suite de Collatz".
La fonction affiche les termes.
"""whilen!=1:print(n,end=" ")ifn%2==0:n=n//2else:n=3*n+1print(1)
Définir la fonction dont la spécification est :
defcollatz_recur(n:int)->None:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La fonction affiche les termes.
"""
Solution
defcollatz_recur(n:int)->None:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La fonction affiche les termes.
"""ifn==1:print(1)else:print(n,end=" ")ifn%2==0:returncollatz_recur(n//2)else:returncollatz_recur(3*n+1)
Génération de listes
Définir la fonction dont la spécification est :
defcollatz(n:int)->List[int]:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La suite est retournée sous forme d'une liste.
"""
Solution
defcollatz(n:int)->List[int]:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La suite est retournée sous forme d'une liste.
"""ifn==1:return[1]else:ifn%2==0:return[n]+collatz(n//2)else:return[n]+collatz(3*n+1)
Comment manipuler une liste sans réaliser la moindre boucle ?
Après avoir construit la liste contenant la suite de Collatz débutant au nombre n, on peut vouloir en extraire, par exemple, tous les nombres pairs.
À l’aide de la fonction help découvrir la spécification de la fonction filter. Écrire cette spécification en français.
Réponse
filter(functionorNone,iterable)-->filterobject"""
Retourne un itérateur dont les valeurs sont celles pour
lesquelles l'application de la fonction function retourne
True.
Si aucune fonction n'est fournie, retourne un itérateur dont
les valeurs sont les valeurs True
"""
Définir la fonction dont la spécification est la suivante :
defest_pair(n:int)->bool:"""
Détermine si n est pair.
"""
Solution
defest_pair(n:int)->bool:"""
Détermine si n est pair.
"""returnn%2==0
Quelle instruction permet de générer une nouvelle liste ne contenant que les éléments pairs de la liste générée par l’application collatz(7) ?
Remarque :filter réalise une évaluation paresseuse et ne retourne pas une liste mais un itérateur. Ce concept est fondamental en programmation fonctionnelle mais ne sera pas abordé dans ce document.
Le résultat de l’application de filter doit donc être passé comme argument à la fonction list : list(filter(..., ...)).
Solution
list(filter(est_pair,collatz(7)))
Programmer la fonction est_pair avec le mot-clé def nécessite d’entrer de nombreuses lignes de code pour, au final, ne nécessiter qu’une seule expression : n % 2 == 0. Les langages fonctionnels permettent généralement de définir des fonctions anonymes (lambda expressions).
En Python, l’expression
lambdax,y:x**y
est une fonction qui associe à x et y le nombre xy. L’application suivante est donc possible
>>>(lambdax,y:x**y)(2,3)8
Malheureusement, la fonction anonyme, une fois utilisée est « perdue » puisqu’elle ne possède pas de nom ! Il est cependant possible de la référencer par une variable :
>>>au_carre=lambdax:x**2>>>au_carre(2)4
Avertissement
Les fonctions anonymes sont limitées à une expression en Python.
Reprendre l’instruction qui permet de générer une nouvelle liste ne contenant que les éléments pairs de la liste générée par l’application collatz(7), en remplaçant l’appel à la fonction est_pair par une fonction anonyme.
Solution
list(filter(lambdan:n%2==0,collatz(7)))
À l’aide de la fonction help découvrir la spécification de la fonction map. Écrire cette spécification en français.
Réponse
map(func,*iterables)-->mapobject"""
Retourne un itérateur qui applique la fonction func
à chaque valeur de l'itérateur *iterables passé en
argument.
Stoppe une fois que toutes les valeurs de *iterables
ont été traitées.
"""
Quelle instruction permet de générer une nouvelle liste contenant chaque élément de la liste générée par l’application collatz(7) multiplié par 3 ?
Utiliser une fonction anonyme.
Remarque :map réalise aussi une évaluation paresseuse et ne retourne pas une liste mais un itérateur. Le résultat de l’application de map doit donc être passé comme argument à la fonction list : list(map(..., ...)).
Solution
list(map(lambdax:3*x,collatz(7)))
Quelle instruction permet de générer une nouvelle liste contenant chaque élément pair de la liste générée par l’application collatz(7) multiplié par 3 ?
Utiliser une fonction anonyme.
Solution
Les List Comprehensions, introduites en classe de première, permettent d’écrire en Python des instructions réalisant les mêmes opérations que filter et map de façon très efficace et lisible.
Écrire l’instruction qui permet de générer une nouvelle liste ne contenant que les éléments pairs de la liste générée par l’application collatz(7), à l’aide d’une List comprehension.
Solution
[nfornincollatz(7)ifn%2==0]
Écrire l’instruction qui permet de générer une nouvelle liste dont les termes sont le triple de chaque terme de la liste générée par l’application collatz(7), à l’aide d’une List comprehension.
Solution
[3*nfornincollatz(7)]
Écrire l’instruction qui permet de générer une nouvelle liste dont les termes sont le triple de chaque terme de la liste générée par l’application collatz(7) si ces termes sont pairs, à l’aide d’une List comprehension.
Solution
[3*nfornincollatz(7)ifn%2==0]
Quelques mots sur l’évaluation paresseuse (laziness)
La fonction collatz génère une liste de nombre. Ce comportement est acceptable tant que le nombre d’éléments de la liste est limité mais terriblement inefficace lorsque le nombre de termes devient très important puisque toute la structure doit être calculée et placée en mémoire avant toute autre opération.
On appelle évaluation paresseuse le mécanisme qui consiste à ne pas construire toute la structure dans un premier temps et à ensuite agir sur cette structure mais à agir sur les éléments au fur et à mesure de leur création.
L’iterateur le plus utilisé jusqu’à présent en cours est range :
>>>range(10)range(0,10)>>>list(range(10))[0,1,2,3,4,5,6,7,8,9]# on oblige l'itérateur à fournir toutes les valeurs
Le tri par insertion a été étudié en classe de 1ère. Dans ce document, après un rappel du cours de 1ère, nous allons implémenter une version récursive de cet algorithme et ensuite utiliser la possibilité que les fonctions en Python ont d’accepter des fonctions comme paramètres, afin de rendre plus générale et utile cette fonction de tri.
Tri du joueur de cartes
Le tri par insertion est un tri « naturel » souvent qualifié de « tri du joueur de carte ». Comment un joueur de carte fait-il pour trier les cartes ?
- Au début, la main gauche du joueur est vide et ses cartes sont posées sur la table.
- Le joueur prend alors sur la table les cartes, une par une avec sa main droite, pour les placer dans sa main gauche.
- Pour savoir où placer une carte dans son jeu, le joueur la compare avec chacune des cartes déjà présentes dans sa main gauche, *en examinant les cartes de la droite vers la gauche*.
- *À tout moment, les cartes tenues par la main gauche sont triées* ; ces cartes étaient, à l'origine, les cartes situées au sommet de la pile sur la table.
Tri par insertion
Avertissement
Une correction du code à développer ci-dessous se trouve
ici
Introduction
La méthode du tri par insertion est ilustré à
ici
, ou, de façon plus folklorique,
ici
.
Visualiser la première vidéo (s’arrêter au bout de 4min40). Essayer de bien comprendre la méthode.
Algorithme itératif
Le tri par insertion est efficace lorsqu’on cherche à trier un tableau contenant un petit nombre d’élements ou un tableau dans lequel les éléments sont déjà pratiquement triés.
Idée
À chaque étape du processus, le tableau est divisé en deux sous-tableaux : le premier (indices plus petits que l’indice courant) est trié, le second (indices plus grands que l’indice courant n’est pas encore trié). On cherche la place de l’élément courant (non encore trié) dans le tableau trié.
Le tri par insertion est basé sur l’utilisation de deux boucles imbriquées :
La première boucle, une boucle Pour, parcourt la liste des valeurs, de la deuxième à la dernière ;
La seconde boucle, une boucle TantQue, cherche à placer l’élément courant dans la première partie triée du tableau (indices inférieurs à l’indice courant).
Début
1.nb ⟵ len(tab)
2.Pour i variant de 1 à nb-1 Faire
3.clé ⟵ tab[i]
4.j ⟵ i - 1
5.TantQue j >= 0 et tab[j] > clé Faire
6.tab[j + 1] ⟵ tab[j]
7.j ⟵ j - 1
8.FinTantQue
9.tab[j + 1] ⟵ clé
10.FinPour Fin
Remarque. L’algorithme du tri par insertion est un algorithme de tri en place. La réorganisation du tableau ne nécessite pas la création d’un nouveau tableau, ce qui économise de la place en mémoire.
Faire tourner « à la main » l’algorithme lorsque la fonction reçoit le tableau tab = [5,2,4,6,1,3].
À quoi sert l’instruction, ligne 2 ?
Expliquer les conditions d’arrêt de la boucle while, ligne 5.
Implémenter la fonction en langage Python et la tester en l’appelant avec les arguments donnés à la question précédente.
Réponse
deftri(tab:List[int])->List[int]:"""
Implémentation du tri par insertion.
Algorithme itératif.
"""foriinrange(1,len(tab)):val=tab[i]j=i-1whiletab[j]>valandj>=0:tab[j+1]=tab[j]j=j-1tab[j+1]=valreturntab
Comment prouve-t-on, de façon générale, la terminaison d’un algorithme ?
Réponse
On définit un variant de boucle.
Est-il nécessaire de prouver la terminaison de la boucle externe de cet algorithme ? De la boucle interne ?
Réponse
La boucle externe est une boucle Pour. Il n’est donc pas nécessaire de prouver sa terminaison. Par contre la boucle interne est une boucle TantQue. Il faut donc prouver sa terminaison.
Démontrer la terminaison de cet algorithme.
Réponse
La fonction f définie par f(j)=j est-elle un variant de boucle ?
Première valeur de j : i−1, donc première valeur de f : f(j)=i−1>0 puisque i>1.
f est-elle décroissante ? fj+1−fj=j−1−j=−1, La fonction est bien décroissante.
Dernière valeur de j : −1, donc f(j)=−1.
f est une fonction positive, décroissante dont la dernière valeur est négative : c’est bien un variant de boucle. La boucle se termine.
Comment prouve-t-on, de façon générale, la correction d’un algorithme ?
Réponse
On recherche un invariant de boucle.
Définir un invariant de boucle et prouver que l’algorithme est correct.
Réponse
Invariant de boucle.
La question à se poser est : « Qu’est ce qui est constant à chaque étape de cet algorithme ? »
Au début de chaque itération de la boucle Pour externe le tableau tab[0, ... , i-1] est un tableau trié constitué des i plus petits éléments du tableau tab, dans l’ordre croissant.
Rappels.
Nous devons montrer trois choses, concernant un invariant de boucle :
Initialisation. Il est vrai avant la première itération de la boucle.
Conservation. S’il est vrai avant une itération de la boucle, il le reste avant l’itération suivante.
Terminaison. Une fois terminée la boucle, l’invariant fournit une propriété utile qui aide à montrer la validité de l’algorithme.
Si les deux premières propriétés sont vérifiées, alors l’invariant est vrai avant chaque itération de la boucle.
La troisième propriété est peut-être la plus importante : elle est utilisée pour prouver la validité de l’algorithme.
Démonstration de la correction de l’algorithme.
Initialisation.i=1, tab[0] est alors un tableau à un élément, trié de façon évidente.
Conservation. Par hypothèse, pour i compris entre 1 et nb-2, tab[0, ,i-1] est un tableau trié. Lors de l’itération i, on recherche le plus petit élément du tableau tab[i, ... ,nb-1] et on le place à la position d’indice i. À partir de l’hypothèse, cet élément est plus grand que n’importe quel élément du tableau tab[0, ,i-1] (sinon il appartiendrait déjà à ce tableau) ; le tableau tab[0, ... ,i] est donc trié.
Terminaison. Au début de la boucle dans laquelle i=nb-2, tab[0, ... ,nb-3] est un tableau trié. À l’issue de cette boucle, on a déterminé le plus petit élément entre tab[nb-2] et tab[nb-1] et on a placé correctement ces éléments ; le tableau tab[0, ... ,nb-1] est donc trié et l’algorithme est correct.
Déterminer la complexité de l’algorithme.
Réponse
Rappels.
Au chapitre précédent, la notion de complexité a été introduite. Nous allons rappeller, dans cette partie, quelques règles simples qui permettent de se faire une idée de l’efficacité d’un algorithme.
Une affectation ou l’évaluation d’une expression ont un temps d’exécution petit que l’on considère constant. Cette durée constitue souvent l’unité de base dans laquelle on mesure le temps d’exécution d’un algorithme.
Le temps pris pour exécuter une séquence d’instructions p puis q est la somme des temps pris pour exécuter les instructions p puis q.
Le temps pris pour exécuter un test Si (b) Alors p Sinon q FinSi est inférieur ou égal au maximum des temps pris pour exécuter les instructions p et q, plus une unité qui correspond au temps d’évaluation de l’expression b.
Le temps pris pour exécuter une boucle Pour i variant de 1 à m par pas de 1 Faire p FinPour est m fois le temps pris pour exécuter l’instruction p si ce temps ne dépend pas de la valeur de i.
En particulier, quand deux boucles sont imbriquées, le corps de la boucle interne est répété à cause de cette boucle, mais aussi parce qu’elle-même est répétée dans son intégralité. Ainsi, si les deux boucles sont répétées respectivement m et m’ fois, alors le corps de la boucle interne est exécuté m * m’ fois en tout.
Quand le temps d’exécution du corps de la boucle dépend de la valeur de l’indice i, le temps total d’exécution de la boucle est la somme des temps d’exécution du corps de la boucle pour chaque valeur de i.
Le cas des boucles Tantque est plus complexe puisque le nombre d’itérations n’est en général pas connu à priori.
On étudie seulement la complexité du pire et on se limite à l’influence des boucles. Si on note N le nombre d’élements dans le tableau,
pour i=0, la boucle interne effectue N−1 tours ;
pour i=1, la boucle interne effectue N−2 tours ;
pour i=3, la boucle interne effectue N−3 tours ;
pour i=N−3, la boucle interne effectue 2 tours ;
pour i=N−2, la boucle interne effectue 1 tour.
Finalement, il y a 1+2+…+(N−2)+(N−1)=∑k=1N−1k=2(N−1)∗N=2N2−2N. La complexité de l’algorithme est en O(N2).
Algorithme récursif
Algorithme 2
Fonction tri_rec
Déclaration Paramètre tab : tableau d’Entiers Paramètre i : Entier Variable nb : Entier
Début
1.nb ⟵ len(tab)
2.Si i == nb Alors
3.Retourner tab
4.Sinon
5.insere(tab, i)
6.Retourner tri_rec(tab, i + 1)
7.FinSi Fin
Début
1.Si i == 0 ou tab[i - 1] <= tab[i] Alors
2.Retourner tab[i]
3.Sinon
4.temp ⟵ tab[i - 1]
5.tab[i - 1] ⟵ tab[i]
6.tab[i] ⟵ temp
7.Retourner insere(tab, i - 1)
7.FinSi Fin
Décrire le fonctionnement de l’algorithme récursif avec soin lorsque la fonction reçoit le tableau tab = [5,2,4,6,1,3].
Implémenter en Python l’algorithme récursif.
Réponse
deftri_rec(tab:List[int],i:int=1)->List[int]:"""
Implémentation du tri par insertion
"""ifi==len(tab):returntabelse:insere(tab,i)returntri_rec(tab,i+1)definsere(tab:List[int],i:int)->List[int]:"""
Insère tab[i] dans le tableau tab[:i] déjà trié, récursivement.
"""ifi==0ortab[i-1]<=tab[i]:returntab[i]else:temp=tab[i-1]tab[i-1]=tab[i]tab[i]=tempreturninsere(tab,i-1)
Ajout d’une fonctionnalité au tri par insertion
Le tri par insertion, tel que nous l’avons implémenté, permet de trier des tableaux contenant tous les objets qui admettent < comme opérateur : int, float, str, … mais aussi tuple !!!
Vérifier que la fonction tri_rec est bien capable de trier la liste [(7, 8), (3, 4), (1, 2), (5, 6)].
Quel est le critère de tri ?
Comment doit-on modifier nos fonctions de tri pour qu’elles trient par ordre décroissant ? Pour qu’elles trient le second élément de tuples passés comme arguments ?
Exemple de problème à traiter : Trier la liste suivante par année de naissance (ordre croissant)
L’idée est de confier la relation d’ordre à une fonction auxiliaire que l’on passe comme argument à la fonction de tri.
Cette fonction auxiliaire doit être un prédicat.
Modifier les fonction tri-rec et insere de façon à ce qu’elles admettent la fonction inf comme argument. La fonction inf est responsable de la relation d’ordre lors du tri.
Réponse
deftri_g(inf:Callable,tab:List[int],i:int=1)->List[int]:"""
Implémentation d'un algorithme générique de tri par insertion.
Algorithme récursif.
"""ifi==len(tab):returntabelse:insere_g(inf,tab,i)returntri_g(inf,tab,i+1)definsere_g(inf:Callable,tab:List[int],i:int)->List[int]:"""
Insère tab[i] dans le tableau tab[:i] déjà trié, récursivement.
"""ifi==0orinf(tab[i],tab[i-1]):returntab[i]else:temp=tab[i-1]tab[i-1]=tab[i]tab[i]=tempreturninsere_g(inf,tab,i-1)
Écrire une fonction inf qui permet de trier un tableau d’entiers par ordre croissant.
Réponse
definfe(x,y):"""
Relation d'ordre générique.
Pas vraiment possible de donner les types.
"""returny<=x
Modifier la fonction inf de façon à ce que le tableau soit trié par ordre décroissant.
Physique, Chimie et Informatique > Terminales Spé. NSI
Structures de données fournies avec le langage Python
Au programme
Contenus
Capacités attendues
Commentaires
- Structures de données, interface et implémentation.
- Spécifier une structure de données par son interface. - Distinguer interface et implémentation. - Écrire plusieurs implémentations d’une même structure de données.
L’abstraction des structures de données est introduite après plusieurs implémentations d’une structure simple comme la file (avec un tableau ou avec deux piles).
- Dictionnaires, index et clé.
- Distinguer la recherche d’une valeur dans une liste et dans un dictionnaire.
Structures de données fournies avec le langage Python
Python possède dans la bibliothèque standard un grand nombre de structures de données, programmées de manière efficace.
Rappels : modules, fonctions
À retenir
Pour chaque module, on distingue :
sa réalisation (ou implémentation) : c’est le code lui-même.
son interface (API) : c’est l’énumération des fonctions définies dans le module qui sont utilisées depuis d’autres modules/programmes, les clients.
L’interface doit présenter une documentation dans laquelle tout ce que doit savoir le client doit être indiqué.
L’objectif de l’interface est que le client n’ait pas à consulter l’implémentation pour utiliser les fonctions.
Avertissement
L’interface peut être envisagée comme une abstraction du module : une description de ce qui caractérise ce module sans jamais entrer dans les détails de l’implémentation.
À retenir
Pour chaque fonction du module, la spécification doit indiquer :
son nom.
la liste de ses paramètres accompagnés de leur type.
le type de la valeur retournée.
la documentation de la fonction.
Avertissement
La spécification peut être envisagée comme une abstraction de la fonction : une description de ce qui caractérise cette fonction sans jamais entrer dans les détails de l’implémentation.
Avantages d’une barrière d’abstraction
Séparation du programme en deux composantes : Implémentation et code client.
La barrière d’abstraction permet de faire varier l’implémentation sans impacter le client.
La barrière d’abstraction permet de cacher (encapsuler) le code de l’implémentation.
Pourquoi différentes structures de données ?
Les structures de donnéesorganisent différemment les données que le programme traite. Le langage Python fournissant le type list, on pourrait se demander pourquoi ne pas systématiquement l’utiliser et pourquoi devoir apprendre de nouveaux types.
En fait, la spécialisation des structures de données rend la programmation plus simple (utilisation de l’API) et plus efficace (complexité).
Avertissement
Nous verrons dans les prochains chapitres qu’il faut distinguer l’objet que l’on manipule dans un programme de son implémentation (comment il est programmé).
À retenir
Un même type peut être implémenté de différentes façons. Dans tous les cas, il présente la même interface au programmeur (API).
On parle donc de type abstrait.
Principaux types abstraits fournis avec le langage Python
Liste : list
Le type list de Python n’est pas implémenté à l’aide de listes chaînées (que nous étudierons au chapitre 7), car la suppression ou l’ajout ailleurs qu’en fin de liste nécessite de décaler les valeurs de fin de liste, et n’est donc pas réalisé en temps constant. D’autre part, l’accès à un élément quelconque est réalisé en temps constant, ce qui n’est pas le cas avec une liste chaînée.
Le type list de Python est implémenté à l’aide de tableaux dynamiques.
Tableau associatif : dict
Le type dict de Python est une implémentation du type abstrait tableau associatif. L’implémentation correspond à une table de hachage, ce qui signifie que la valeur est stockée dans un tableau et que la position dans ce tableau dépend du résultat d’une fonction de hachage appliquée à la clé. En un temps indépendant du nombre de valeurs stockées dans le dictionnaire, Python peut retrouver la valeur associée à n’importe quelle clé : pour cela il calcule un indice à partir de la valeur de la clé (qui doit donc être hachable, c’est-à-dire récursivement non mutable) et récupère la valeur stockée à cet indice dans un tableau.
Une caractéristique essentielle des dictionnaires est que la récupération d’une valeur associée à une clé se fait en un temps constant, indépendant de la taille du dictionnaire. De même, savoir si une clé fait partie du dictionnaire prend un temps constant (alors que vérifier si un élément est dans une liste prend un temps proportionnel à la taille de la liste).
Ensemble : set
Un ensemble Python (set) est équivalent à un dictionnaire ne contenant que des clés. Par construction, chaque élément est donc unique. De plus, avec le type set on dispose déjà des opérations ensemblistes habituelles, implémentées de manière très efficace : union, intersection, différence, etc.
Opérations usuelles et complexité en temps
Opérations sur les listes
Type Python
Implémentation
Opération
Exemple
Complexité
list
Tableau dynamique
Ajout à la fin
lst.append(x)
O(1)
lst=[]
Accès à un élément
lst[i]
O(1)
len(lst)
Modification d’un élément
lst[i] = x
O(1)
Effacement d’un élément
del lst[i]
O(n)
Insertion d’un élément
lst.insert(i, x)
O(n)
Recherche d’un élément
x in lst
O(n)
Opérations sur les dictionnaires
Type Python
Type abstrait
Opération
Exemple
Complexité
dict
Tableau associatif
Ajout d’un élément
d[key] = val
O(1)
d={}
Modification d’un élément
d[key] = val
O(1)
len(d)
Effacement d’un élément
del d[key]
O(1)
Accès à un élément
d[key]
O(1)
Recherche d’une clé
key in d
O(1)
Recherche d’une valeur
val in d.values()
O(n)
Opérations sur les ensembles
Type Python
Type abstrait
Opération
Exemple
Complexité (moyenne)
set
Ensemble
Ajout d’un élément
s.add(elt)
O(1)
s = {}
Retrait d’un élément
s.remove(elt)
O(1)
len(s)
Test d’appartenance
elt in s
O(1)
Union
s | t
O(n+m)
Intersection
s & t
O(min(n,m))
Différence
s - t
O(n)
Différence symétrique
s ^ t
O(n)
Exemple : Définition et implémentation du type abstrait « Liste » à l’aide de tableaux dynamiques en Python
Interface du type abstrait « Liste »
L’interface de la classe est la suivante :
HelponclassListeinmodule__main__:classListe(builtins.object)|Liste()->'None'||Classeimplémentantletype«Liste»,|versiontrèssimplifiéedutype«liste»dePython.||Methodsdefinedhere:||__getitem__(self:'TableauDynamique',i:'int')->'object'|Retournel'élément d'indicei.||__init__(self:'TableauDynamique')->'None'|Créationd'un tableau vide à l'initialisation.||__len__(self:'TableauDynamique')->'int'|Retournelenombred'éléments dans le tableau.||append(self:'TableauDynamique',obj:'object')->'None'|Ajoutel'élément obj en dernière position dans le tableau.
Implémentation
Créer la classe Liste.
Dans la méthode __init__, initialiser trois attributs privés _nbre, _capacite et _tab tels que _nbre donne le nombre d’éléments dans le tableau (initialement égal à 0), _capacite donne le nombre maximal possible d’éléments dans le tableau (initialement égal à 1) et _tab référence un tableau créé à l’aide de la fonction py_object du module ctypes.
Remarque : le code de création du tableau est le suivant :
def_construit_tableau(self:Liste,capacite:int):"""
Construction d'un tableau de capacité donnée.
"""return(capacite*ctypes.py_object)()
Définir la méthode __len__ dont la spécification est :
def__len__(self:Liste)->int:"""
Retourne le nombre d'éléments dans le tableau.
"""
Définir la méthode __getitem__ dont la spécification est :
def__getitem__(self:Liste,i:int)->object:"""
Retourne l'élément d'indice i.
Une exception est levée si l'indice n'appartient
pas au bon intervalle.
"""
Définir la méthode privée _augmente_taille dont la spécification est :
def_augmente_taille(self:Liste,capacite:int)->None:"""
Crée un nouveau tableau de dimension capacite puis copie tous les
éléments de l'ancien tableau dans ce dernier.
Fait en sorte que le nouveau tableau soit le tableau désormais
utilisé.
Met à jour l'attribut capacite.
"""
Définir la méthode append dont la spécification est :
defappend(self:Liste,obj:object)->None:"""
Ajoute l'élément obj en dernière position dans le tableau.
"""
Remarque : La méthode append doit appeler la méthode _augmente_taille.
Définir la méthode __repr__ dont la spécification est :
def__repr__(self:Liste)->str:"""
Retourne la chaîne de caractères représentant le tableau.
"""
Tester le bon fonctionnement de la classe.
Corrigé
from__future__importannotationsimportctypesclassListe:"""
Implémentation du type abstrait liste avec des
tableaux dynamiques.
"""def__init__(self:Liste)->None:"""
Initialisation de l'objet
"""self._nbre=0# Nbre d'éléments dans la listeself._capacite=1# Nbre max d'éléments dans le tableauself._tab=self._construit_tableau(self._capacite)# Tableaudef_construit_tableau(self:Liste,capacite:int):"""
Construction d'un tableau de capacité donnée.
"""return(capacite*ctypes.py_object)()def__len__(self:Liste)->int:"""
Retourne le nombre d'éléments dans le tableau.
"""returnself._nbredef__getitem__(self:Liste,i:int)->object:"""
Retourne l'élément d'indice i.
Une exception est levée si l'indice n'appartient
pas au bon intervalle.
"""ifi>=self._nbre:raiseIndexError("Indice trop grand !")elifi<0:i=self._nbre+ireturnself._tab[i]def_augmente_taille(self:Liste,capacite:int)->None:"""
Crée un nouveau tableau de dimension capacite puis copie
tous les éléments de l'ancien tableau dans ce dernier.
Fait en sorte que le nouveau tableau soit le tableau désormais
utilisé.
Met à jour l'attribut capacite.
"""new_tab=self._construit_tableau(capacite)foriinrange(self._nbre):# new_tab[i] = self._tab.__getitem__(i)new_tab[i]=self._tab[i]self._tab=new_tabself._capacite=capacitedefappend(self:Liste,obj:object)->None:"""
Ajoute l'élément obj en dernière position dans le tableau.
"""ifself._nbre==self._capacite:self._augmente_taille(2*self._capacite)self._tab[self._nbre]=objself._nbre+=1def__repr__(self:Liste)->str:"""
Retourne la chaîne de caractères représentant le tableau.
"""chaine="["foriinrange(self._nbre):chaine+=str(self._tab[i])ifi!=self._nbre-1:chaine+=", "chaine+="]"returnchaineif__name__=="__main__":liste=Liste()print(f"Longueur de la liste : {len(liste)}")print(f"Capacité du tableau : {liste._capacite}")liste.append(3)# TableauDynamique.append(liste, 3)print(f"Longueur de la liste : {len(liste)}")print(f"Capacité du tableau : {liste._capacite}")print(liste)foriinrange(112):liste.append(i)print(f"Longueur de la liste : {len(liste)}")print(f"Capacité du tableau : {liste._capacite}")print(liste)
Physique, Chimie et Informatique > Terminales Spé. NSI > Structures de données fournies avec le langage Python
Au zoo de Beauval, il y a 5 éléphants d’Asie, 17 écureuils d’Asie, 2 pandas d’Asie, etc.
On représente cet inventaire à l’aide d’un dictionnaire, de façon suivante :
On souhaite se doter d’une fonction plus_grand_nombre() qui prend un zoo en paramètre et qui renvoie le nom de l’animal le plus représenté dans ce zoo.
Par exemple
Quel type de boucle peut-on envisager pour le code de cette fonction ?
for cle in dico.keys()
for valeur in dico.values()
for (cle, valeur) in dico.items()
Aucune boucle.
Écrire le corps de cette fonction.
On souhaite se doter d’une fonction nombre_total qui prend un zoo en paramètre ainsi que le nom d’un continent, et qui renvoie le nombre d’animaux originaires de ce continent dans le zoo.
Par exemple :
Quel type de boucle peut-on envisager pour le code de cette fonction ?
for cle in dico.keys()
for valeur in dico.values()
for (cle,valeur) in dico.items()
Aucune boucle.
Écrire le code de cette fonction.
On souhaite se doter d’une fonction nombre qui prend un zoo en paramètre ainsi que le nom d’un animal, et qui renvoie le nombre de représentants de cet animal dans le zoo.
Par exemple :
Quel type de boucle peut-on envisager pour le code de cette fonction ?
for cle in dico.keys()
for valeur in dico.values()
for (cle,valeur) in dico.items()
Aucune boucle.
Écrire le code de cette fonction.
Solution
fromtypingimportDict,Tupledefplus_grand_nombre(zoo:Dict[str,Tuple[str,int]])->str:"""
Retourne le nom de l’animal le plus représenté dans le zoo.
"""nbre_max=0# nbre maximale d'animauxforcle,valeurinzoo.items():ifvaleur[1]>nbre_max:nbre_max=valeur[1]cle_max=cleelifvaleur[1]==nbre_max:cle_max+=", "+clereturncle_maxdefnbre_total_continent(zoo:Dict[str,Tuple[str,int]],continent:str)->int:"""
Retourne le nombre d’animaux originaires de ce continent dans le zoo.
"""nbre_total=0# Nbre total d'animaux pour le continentforvaleurinzoo.values():ifvaleur[0]==continent:nbre_total+=valeur[1]returnnbre_totaldefnbre_pour_animal(zoo:Dict[str,Tuple[str,int]],animal:str)->int:"""
Retourne le nombre de représentants de animal dans zoo.
"""ifanimalinzoo.keys():rep=zoo[animal][1]else:# si animal pas présent dans zoorep=0returnrepif__name__=="__main__":zoo_Beauval={"éléphant":("Asie",5),"écureuil":("Asie",17),"panda":("Asie",2),"hippopotame":("Afrique",7),"girafe":("Afrique",4),"lion":("Afrique",17),}zoo_LaFleche={"ours":("Europe",4),"tigre":("Asie",7),"girafe":("Afrique",11),"hippopotame":("Afrique",3),}assertplus_grand_nombre(zoo_LaFleche)=="girafe"assertplus_grand_nombre(zoo_Beauval)=="écureuil, lion"assertnbre_total_continent(zoo_LaFleche,"Afrique")==14assertnbre_total_continent(zoo_Beauval,"Asie")==24assertnbre_pour_animal(zoo_Beauval,"panda")==2assertnbre_pour_animal(zoo_LaFleche,"panda")==0
Physique, Chimie et Informatique > Terminales Spé. NSI
Listes chaînées
Au programme
Contenus
Capacités attendues
Commentaires
- Listes.
- Distinguer des structures par le jeu des méthodes qui les caractérisent. - Choisir une structure de données adaptée à la situation à modéliser.
- Les listes n’existent pas de façon native en Python.
Un tableau est une structure de données dans laquelle les éléments, tous de même type, occupent des positions contiguës en mémoire.
Le nombre d’éléments qu’un tableau peut contenir est déterminé à la création d’un tableau.
Type Python
Type
Opération
Exemple
Complexité
N’existe pas
Tableau
Accès à un élément
tab[i]
O(1)
Modification d’un élément
tab[i] = x
O(1)
Effacement d’un élément
retire(tab, i)
O(n)
Insertion d’un élément
insere(tab, x, i)
O(n)
Recherche d’un élément
est_dans(tab, x)
O(n)
Info
La structure de données appelée « liste » dans le langage Python est implémentée à l’aide de tableaux dynamiques.
Remarque : Dans la suite de ce document, on va considérer que la liste Python tab, créé par l’instruction tab = [i for i in range(20)] est de longueur fixe. Elle se comporte alors comme un tableau.
Pourquoi la recherche d’un élément dans un tableau quelconque (non trié donc) est en O(N) ?
Écrire le prédicat est_dans de spécification :
defest_dans(tab:List[int],n:int)->bool:"""
Recherche si la valeur n est présente au moins une fois
dans le tableau tab.
Algorithme itératif.
"""
Écrire un jeu de tests.
(Facultatif) Écrire le prédicat est_dans_rec de spécification :
defest_dans_rec(tab:List[int],n:int,i:int=0)->bool:"""
Recherche si la valeur n est présente au moins une fois
dans le tableau tab.
Algorithme récursif, i est l'indice de recherche.
"""
Quelle est la complexité des algorithmes précédents en fonction de N, la taille du tableau ?
Réponse
Dans l’algorithme itératif, dans le pire des cas (valeur absente du tableau) N tours de boucle sont effectués.
Dans l’algorithme récursif, N appels récursifs sont effectués.
L’algorithme est donc en O(N).
Pourquoi l’insertion d’un élément dans un tableau est en O(N) ?
Dans cette partie, on imagine que le tableau a cette allure :
1
1
2
3
4
5
vide
vide
vide
Si on introduit, en position 1, la valeur 7. Le tableau est alors :
7
1
1
2
3
4
5
vide
vide
Avertissement
Cette opération n’est possible, sans crainte de perdre des données, que si toutes les cellules du tableau ne contiennent pas des données.
Toute fonction permettant l’insertion de valeurs doit donc avertir un utilisateur dans le cas contraire.
Remarque : Dans le code ci-dessous, les cellules seront considérées vides si elles contiennent la valeur None.
Écrire la fonction insere dont la spécification est :
definsere(tab:List[int],n:int,i:int)->None:"""
Insère la valeur n à l'indice i du tableau tab.
Algorithm itératif et en place.
Lève une exception si le tableau est déjà plein.
HYPOTHÈSE : la gestion des "trous" n'est pas assurée,
l'algorithme se contente de décaler les valeurs vers
la droite.
"""
(Facultatif) Écrire la fonction insere_rec dont la spécification est :
definsere_rec(tab:List[int],n:int,i:int,k:int)->None:"""
Insère la valeur n à l'indice i du tableau tab.
Algorithm récursif et en place. k est l'indice de recherche. Sa première valeur doit être len(tab) - 1.
Lève une exception si le tableau est déjà plein.
HYPOTHÈSE : la gestion des "trous" n'est pas assurée,
l'algorithme se contente de décaler les valeurs vers
la droite.
"""
Quelle est la complexité des algorithmes précédents en fonction de N, la taille du tableau ?
Réponse
Dans le pire des cas (insertion à la première place du tableau), on déplace N−1 valeurs.
L’algorithme est donc en O(N).
Structure de liste chaînée
À retenir
Les listes chaînées constituent une structure de données :
de longueur modifiable ;
plus efficace que les tableaux lorsqu’il s’agit d’ajouter ou de retirer un élément (il n’est pas nécessaire de faire de la place en déplaçant les éléments) ;
qui servira de brique à l’élaboration d’autres structures de données.
À retenir
Une liste chaînée permet de représenter une liste ; chaque élément de cette liste est une cellule contenant :
la valeur de l’élément à stocker ;
l’adresse mémoire de la cellule représentant l’élément suivant.
Remarque : le symbole ⊥ marque la fin de la liste dans les schémas.
Comment implémenter une cellule ?
En langage Python, on peut implémenter une cellule à l’aide d’une classe, de listes ou de tuples.
Définir la classe Cellule dont la spécification est :
classCellule:"""
Implémentation d'une cellule de liste chaînée
de nombres entiers.
Attributs
---------
valeur : int
Valeur à stocker dans la liste
suivante : Cellule
Addresse de la cellule suivante (chaînée)
"""
Info
La dernière cellule d’une liste chaînée devra pointer vers l’objetNonequi représente donc une cellule vide.
Instancier 3 objets c1, c2, c3, de type Cellule, dont les valeurs sont 1, 2, 3.
Tous ces objets sont pour l’instant isolés (ils ne pointent vers aucune autre cellule si ce n’est la cellule vide None).
Créer la liste lst à l’aide de ces trois objets.
Comment aurait-on pu créer la liste lst en une seule instruction ?
Les listes chaînées sont des structures fondamentalement récursives
À retenir
Une liste chaînée est :
soit la liste vide (objet None) ;
soit constituée de son premier élément (objet de type Cellule) et du reste des éléments qui forment aussi une liste.
Une liste chaînée est donc une structure récursive.
Une liste chaînée est-elle forcément homogène
Tout au long de ce document nous allons uniquement envisager des listes chaînées de nombres entiers. Rien n’impose, cependant, à l’attribut valeur de la classe Cellule d’être un entier. Chaque cellule peut même posséder des attributs valeur de type différent. Les listes chaînées peuvent donc être hétérogènes.
Quelques opérations sur les listes chaînées
Avertissement
Le point de vue envisagé dans la suite de ce document est celui de la programmation impérative : nous allons définir des fonctions qui vont modifier la liste chaînée.
Nous créerons une classe enveloppe dans un prochain document, de façon à ce notre liste chaînée ait la même interface qu’une liste Python.
Longueur d’une liste chaînée
Écrire la fonction longueur dont la spécification est :
deflongueur(lst:Cellule)->int:"""
Détermine la longueur de la liste lst.
Algorithme récursif.
"""
Écrire la fonction longueur_iter dont la spécification est :
deflongueur_iter(lst:Cellule)->int:"""
Détermine la longueur de la liste lst.
Algorithme itératif.
"""
Déterminer la complexité du calcul de la longueur d’une liste.
Réponse
On réalise autant d’appels récursifs (ou de tours de boucles qu’il y a d’éléments dans la liste).
La complexité est donc en O(N).
Affichage de tous les éléments d’une liste
Écrire la fonction affichage_elements_liste dont la spécification est :
defaffichage_elements_liste(lst:Cellule)->None:"""
Affiche tous les éléments de la liste lst.
Chaque élément est séparé par une tabulation "\t"
"""
Définir la fonction list_to_str dont la spécification est :
deflist_to_str(lst:Cellule,premier:bool=True)->str:"""
Retourne une chaîne de caractères constituée de toutes
les valeurs, sous la forme : "[valeur1, valeur2, ...]".
premier est positionné à True si la valeur est la première
de la liste et à False pour toutes les autres valeurs.
"""
Valeur du n-ième élément d’une liste
Écrire la fonction n_ieme_element dont la spécification est :
defn_ieme_element(lst:Cellule,i:int)->int:"""
Retourne le n-ième élément de la liste. La convention
suivie est celle de Python, le premier élément ayant
l'indice i = 0.
Algorithme récursif.
Lève une exception si l'indice de la liste est trop grand.
"""
Écrire la fonction n_ieme_element_iter dont la spécification est :
defn_ieme_element_iter(lst:Cellule,i:int)->int:"""
Retourne le n-ième élément de la liste. La convention
suivie est celle de Python, le premier élément ayant
l'indice i = 0.
Algorithme itératif.
Lève une exception si l'indice de la liste est trop grand.
"""
Déterminer la complexité de la recherche du n-ième élément d’une liste.
Réponse
Si l’élément dont on cherche la valeur est le dernier de la liste il est nécessaire de faire N appels récursifs (ou tours de boucles).
Si l’indice est hors des limites, il est ici aussi nécessaire de parcourir toute la liste avant de s’en rendre compte.
L’algorithm est donc en O(N).
Modification de la valeur d’une cellule sans modifier la structure de la liste
Écrire la fonction modifier_n_ieme_element dont la spécification est :
defmodifier_n_ieme_element(lst:Cellule,i:int,valeur:int)->None:"""
Modifie le n-ième élément de la liste. La convention
suivie est celle de Python, le premier élément ayant
l'indice i = 0.
Algorithme récursif.
Lève une exception si l'indice de la liste est trop grand.
"""
Ajout d’une valeur à la fin de la liste
Écrire la fonction ajout_fin_liste dont la spécification est :
defajout_fin_liste(lst:Cellule,valeur:int)->None:"""
Ajout de valeur à la fin de la liste.
La liste lst est modifiée.
Algorithme récursif.
"""
Quelle est la complexité de la fonction ajout_fin_liste ?
Réponse
On doit parcourir toute la liste pour ajouter un élément à la fin. La complexité est donc linéaire.
Ajout d’une valeur au début de la liste
Écrire la fonction ajout_debut_liste dont la spécification est :
defajout_debut_liste(lst:Cellule,valeur:int)->Cellule:"""
Ajout de valeur au début de la liste.
La nouvelle adresse de la tête de liste doit être
retournée.
"""
Quelle est la complexité de cette fonction ?
Réponse
O(1)
Retrait du dernier élément d’une liste
Écrire la fonction retrait_dernier_element dont la spécification est :
defretrait_dernier_element(lst:Cellule)->int:"""
Retire le dernier élément de la liste et le retourne.
Algorithme récursif.
"""
Quelle est la complexité de cette fonction ?
Réponse
Il faut parcourir la liste, donc O(N).
Retrait du premier élément d’une liste
Écrire la fonction retrait_premier_element dont la spécification est :
defretrait_premier_element(lst:Cellule)->tuple[int,Cellule]:"""
Retire le premier élément de la liste et le retourne.
La nouvelle adresse de la tête de liste doit être
retournée.
"""
Quelle est la complexité de cette fonction ?
Réponse
O(1).
Retrait du n-ième élément d’une liste
Écrire la fonction retrait_n_ieme_element dont la spécification est :
defretrait_n_ieme_element(lst:Maillon,i:int)->int:"""
Retire le n-ième élément de la liste lst. La convention
suivie est celle de Python, le premier élément ayant
l'indice i = 0.
Algorithme récursif.
Lève une exception si l'indice de la liste est trop grand,
ne prend pas en charge le retrait du premier élément.
"""
Quelle est la complexité de cette fonction ?
Réponse
Le retrait en lui-même est en O(1) mais il faut arriver jusqu’à la valeur. L’ensemble est donc en O(N).
Concaténation de deux listes
À retenir
On appelle concaténation de deux listes l’opération consistant à mettre bout à bout les deux listes.
Écrire la fonction concatener dont la spécification est :
defconcatener(lst1:Cellule,lst2:Cellule)->Cellule:"""
Concatène les listes lst1 et lst2. Une nouvelle liste est
créée et retournée.
Les éléments de la première liste sont copiés alors que ceux
de la deuxième sont insérés. lst1 et lst2 ne sont donc pas modifiées.
ATTENTION : tout élément de lst partagé avec lst2 modifié l'est aussi
dans lst2.
Algorithme récursif.
"""
Écrire la fonction copie dont la spécification est :
defcopie(lst:Cellule)->Cellule:"""
Réalise une nouvelle copie de la liste lst.
Algorithme récursif.
"""
Se servir de la fonction copie pour écrire la fonction concatener_avec_copie_integrale dont la spécification est :
defconcatener_avec_copie_integrale(lst1:Cellule,lst2:Cellule)->Cellule:"""
Concatène les listes lst1 et lst2. Les éléments des listes lst1 et lst2
sont recopiés pour former une nouvelle liste.
Algorithme récursif.
"""
Quelle est la complexité de la fonction concatener ? Même question pour la fonction concatener_avec_copie_integrale.
Réponse
Dans le premier cas, il est nécessaire de recopier tous les éléments de lst1. La complexité est donc linéaire et dépend du nombre d’élements de lst1.
Dans le second cas, on recopie tous les éléments de lst1 et de lst2. La complexité est donc linéaire et est la somme du nombre d’éléments de lst1 et de lst2.
Renverser une liste
Écrire la fonction renverser dont la spécification est :
defrenverser(lst:Cellule)->Cellule:"""
Retourne une nouvelle liste formée des éléments de lst à l'envers.
Les éléments peuvent avoir été recopiés ou pas.
Algorithme récursif.
"""
Remarque. Cette fonction doit s’appuyer sur les fonctions concatener ou concatener_avec_copie_integrale.
Remarque. Cet algorithme est particulièrement inefficace.
Conclusion
À retenir
Une liste chaînée est une structure de données utile pour représenter une séquence finie d’éléments.
Chaque élément est contenu dans une cellule, qui fournit, en plus de la valeur, un moyen pour accéder à la cellule suivante.
Les éléments d’une liste chaînée ne sont pas situés dans des emplacements contigüs en mémoire.
Les opérations sur les listes chaînées se programment sous la forme de parcours qui suivent ces liaisons, en utilisant la récursivité ou des boucles.
À retenir
Une liste chaînée est un type abstrait de données qui doit, au minimum, fournir les fonctions suivantes :
insère : insère un élément dans la liste ;
supprime : supprime et renvoie l’élément de position spécifié de la liste ;
longueur : renvoie le nombre d’éléments de la liste ;
est_vide : détermine si la liste est vide ou pas ;
nième_élément : retourne la valeur du nième élément depuis le début.
Action
Liste chaînée
Tableau
Tableau dynamique
Accès à un élément
O(n)
O(1)
O(1)
Insertion/suppression du 1er élément
O(1)
O(n) (si place)
O(n)
Insertion à la fin
O(n)
O(1) (si place)
O(1) (si place) O(n) (si pas de place)
Suppression du dernier élément
O(n)
O(1)
O(1)
Insertion/suppression au milieu
O(n)
O(n) (si place)
O(n)
Quelques exemples d’utilisation des listes chaînées
Les logiciels de visualisation d’images utilisent parfois une liste chaînée pour afficher les images précédentes et suivantes à l’aide des boutons « précédent » et « suivant ».
Des navigateurs Web peuvent utiliser une liste chaînée pour accéder aux pages à l’aide des boutons « précédent » et « suivant ».
Les boutons « précédent » et « suivant » des lecteurs de musique peuvent utiliser une liste chaînée doublement/circulaire.
Les tracés et les formes sur le canevas, de MS-Paint sont connectés via une liste chaînée.
Le balayage « gauche/droite » sur Tinder utilise une liste doublement chaînée.
On peut garder la trace des tours dans un jeu multi-joueurs à l’aide d’une liste chaînée circulaire.
Les lignes de code dans un IDE peuvent être enregistrées dans une liste doublement chaînée.
Annexe : Tests possibles pour les fonctions codées
if__name__=="__main__":# c1 = Cellule(1, None)# c2 = Cellule(2, None)# c3 = Cellule(3, None)# lst = c1# lst.suivante = c2# c2.suivante = c3lst=Cellule(1,Cellule(2,Cellule(3,Cellule(4,None))))affichage_elements_liste(lst)assertlongueur(lst)==4assertlongueur_iter(lst)==4assertn_ieme_element(lst,0)==1assertn_ieme_element(lst,3)==4# print(n_ieme_element(lst, 4))assertn_ieme_element_iter(lst,0)==1assertn_ieme_element_iter(lst,3)==4# print(n_ieme_element_iter(lst, 4))lst1=Cellule(1,Cellule(2,Cellule(3,Cellule(4,None))))lst2=Cellule(5,Cellule(6,Cellule(7,None)))lst3=concatener_avec_copie_integrale(lst1,lst2)print(lst3)print(list_to_str(lst3))# Modification de la listemodifier_n_ieme_element(lst,0,12)assertn_ieme_element_iter(lst,0)==12# Ajout en fin de listeajout_fin_liste(lst,Cellule(25,None))affichage_elements_liste(lst)print(list_to_str(lst))# Ajout en début de listelst=ajout_debut_liste(lst,Cellule(34,None))affichage_elements_liste(lst)# Retrait dernier élémentdernier=retrait_dernier_element(lst)print(dernier)affichage_elements_liste(lst)
Implémentation du type abstrait Liste Chaînée à l'aide de listes Python
Reprendre toutes les fonctions des sections 2 et 3 du document 1 de ce chapitre, en implémentant cette fois le type abstrait « Liste chaînée » à l’aide de tuples (à la place de la classe).
Réponse
defest_dans(tab:list[int],val:int)->bool:"""
Recherche la présence de val dans tab.
"""trouve=Falsei=0whilei<len(tab)andnottrouve:ifval==tab[i]:trouve=Truei+=1returntrouvedefest_dans_rec(tab:list[int],n:int,i:int=0)->bool:"""
Recherche si la valeur n est présente au moins une fois
dans le tableau tab.
Algorithme récursif, i est l'indice de recherche.
"""ifi==len(tab):returnFalseeliftab[i]==n:returnTrueelse:returnest_dans_rec(tab,n,i+1)definsere(tab:list[int],n:int,i:int)->None:"""
Insère la valeur n à l'indice i du tableau tab.
Algorithm itératif et en place.
Lève une exception si le tableau est déjà plein.
HYPOTHÈSE : la gestion des "trous" n'est pas assurée,
l'algorithme se contente de décaler les valeurs vers
la droite.
"""dernier_indice=len(tab)-1iftab[dernier_indice]!=None:raiseException("Tableau plein !")k=dernier_indicewhilek>i:tab[k]=tab[k-1]k-=1# for k in range(dernier_indice, i, -1):# tab[k] = tab[k - 1]tab[i]=ndefinsere_rec(tab:list[int],n:int,i:int,k:int)->None:"""
Insère la valeur n à l'indice i du tableau tab.
Algorithm récursif et en place. k est l'indice de
recherche.
Sa première valeur doit être len(tab) - 1.
Lève une exception si le tableau est déjà plein.
HYPOTHÈSE : la gestion des "trous" n'est pas
assurée, l'algorithme se contente de décaler
les valeurs vers la droite.
"""dernier_indice=len(tab)-1iftab[dernier_indice]!=Noneandk==dernier_indice:raiseException("Tableau plein !")elifk==i:tab[i]=nreturnNoneelse:tab[k]=tab[k-1]returninsere_rec(tab,n,i,k-1)if__name__=="__main__":tab=[iforiinrange(20)]assertest_dans(tab,12)==Trueassertest_dans(tab,0)==Trueassertest_dans(tab,20)==Falseassertest_dans_rec(tab,12)==Trueassertest_dans_rec(tab,0)==Trueassertest_dans_rec(tab,20)==Falseprint("Insertion itérative")tab=[1,1,2,3,4,5,None,None,None]print(tab)insere(tab,7,0)print(tab)insere(tab,7,0)print(tab)insere(tab,7,0)print(tab)# insere(tab, 7, 0)# print(tab)print()print("Insertion récursive")tab=[1,1,2,3,4,5,None,None,None]print(tab)insere_rec(tab,7,0,len(tab)-1)print(tab)insere_rec(tab,7,0,len(tab)-1)print(tab)insere_rec(tab,7,0,len(tab))print(tab)
Par transformation des fonctions du document 1 dans ce chapitre en méthodes, écrire le code de la classe Liste qui définit le type abstrait « Liste chaînée ».
Réponse
from__future__importannotationsclassMaillon:"""
Un maillon de la liste.
"""def__init__(self:Maillon,valeur:int,suivant:Maillon=None)->None:self.valeur=valeurself.suivant=suivantclassListe:"""
Implémentation de la classe liste.
"""def__init__(self:Liste,valeur:int=None)->None:"""
Initialisation de l'objet. Il est possible de créer une liste
vide ou une liste contenant un élément.
Il est possible de créer directemnt une liste contenant plusieurs
éléments il faut utiliser une fonctionnalité de Python que vous
ne connaissez pas forcément et qui n'est pas au programme.
"""ifvaleurisNone:self.maillons=Noneelse:self.maillons=Maillon(valeur)defest_vide(self:Liste)->bool:"""Détermine si la liste est vide."""returnself.maillonsisNonedef__len__(self:Liste)->int:"""Retourne le nombre d'éléments dans la liste."""ifself.est_vide():return0else:nbre=0maillon=self.maillonswhilemaillonisnotNone:nbre+=1maillon=maillon.suivantreturnnbredefappend(self:Liste,valeur:int)->None:"""
Ajoute valeur à la fin de la liste.
"""ifself.est_vide():self.maillons=Maillon(valeur)else:maillon=self.maillonswhilemaillon.suivantisnotNone:maillon=maillon.suivantmaillon.suivant=Maillon(valeur)defappend_first(self:Liste,valeur:int)->None:"""
Ajoute valeur au début de la liste.
"""maillon=Maillon(valeur)maillon.suivant=self.maillonsself.maillons=maillondefpop(self:Liste)->int:"""
Retire le dernier élément de la liste et le retourne.
Lève une erreur si la liste est vide.
"""ifself.est_vide():# Liste videraiseException("La liste est vide !")maillon=self.maillonsifmaillon.suivantisNone:# Cas d'une liste à un élémentvaleur=maillon.valeurself.maillons=Nonereturnvaleurelse:whilemaillon.suivant.suivantisnotNone:# Cas généralmaillon=maillon.suivantvaleur=maillon.suivant.valeurmaillon.suivant=Nonereturnvaleurdefpop_first(self:Liste)->int:"""
Retire le premier élément de la liste et le retourne.
Lève une erreur si la liste est vide.
"""ifself.est_vide():# Liste videraiseException("La liste est vide !")valeur=self.maillons.valeurself.maillons=self.maillons.suivantreturnvaleurdef__getitem__(self:Liste,i:int)->int:"""
Redéfinition de la fonction d'accès à l'élément d'indice i.
"""ifself.est_vide():raiseException("La liste est vide !")maillon=self.maillonsj=0whilej<i:ifmaillonisNone:raiseIndexError("Indice hors des limites !")maillon=maillon.suivantj+=1returnmaillon.valeurdef__str__(self:Liste)->str:"""
Représentation de la liste sous-forme d'une chaîne de caractères.
"""rep="["maillon=self.maillonswhilemaillonisnotNone:rep+=str(maillon.valeur)ifmaillon.suivantisnotNone:rep+=", "maillon=maillon.suivantrep+="]"returnrep
Physique, Chimie et Informatique > Terminales Spé. NSI
Piles et Files
Au programme
Contenus
Capacités attendues
Commentaires
- Piles - Files.
- Distinguer des structures par le jeu des méthodes qui les caractérisent. - Choisir une structure de données adaptée à la situation à modéliser.
- On distingue les modes FIFO (first in first out) et LIFO (last in first out) des piles et des files.
Une structure de données ou type de données abstrait est un moyen d’organiser et de manipuler les données en mémoire. Un TDA est donc définit par :
Son nom ;
Sa spécification, c’est à dire la liste des manipulations/opérations que l’on peut ou pas effectuer.
La spécification indique généralement la complexité de chacune des opérations prévues par le TDA.
Avertissement
Un type de données abstrait ne dépend pas de la manière dont la structure de données est implémentée dans le langage de programmation utilisé.
Un TDA peut être implémenté de plusieurs façons différentes.
Qu’est-ce qu’une pile ?
Info
Une pile est une structure de données abstraite dans laquelle les données sont organisées comme le seraient des assiettes dans une pile d’assiettes contenue dans une boite de profondeur quelconque mais étroite (ce qui empêche de manipuler les assiettes par le côté).
On peut donc seulement :
Empiler une nouvelle assiette au-dessus des autres assiettes (ou d’aucune assiette si la pile est vide) ;
Retirer l’assiette située tout en haut de la pile ;
Regarder l’assiette située tout en haut de la pile ;
Regarder si la pile est vide.
Spécification d’une Pile de valeurs de type T
Créer une pile (type) :
fonction : creer_pile()⟶ retourne une pile vide ;
complexité idéale : O(0) (pas tout à fait vrai mais suffisant pour comprendre la suite).
Empiler une valeur en haut de la pile :
fonction : empiler(p: Pile[T], valeur: T)⟶None ;
complexité idéale : 1 opération élémentaire.
Accéder à la valeur située tout en haut de la pile :
fonction : lire(p: Pile[T])⟶ retourne la dernière valeur de la pile ;
Complexité idéale : 1 opération élémentaire.
Retirer la dernière valeur de la pile :
fonction : depiler(p: Pile[T])⟶T ;
complexité idéale : 1 opération élémentaire.
Tester si une pile est vide :
fonction : est_vide(p: Pile[T])⟶ retourne un booléen ;
complexité idéale : 1 opération élémentaire.
Avertissement
La spécification d’une pile montre qu’il n’existe aucune opération élémentaire pour :
accéder à une donnée qui n’est pas sur le haut de la pile ;
déterminer combien de données contient la pile.
…
À retenir
La valeur dépilée est toujours la dernière valeur à avoir intégré la pile : Last In, First Out (LIFO)
Exemple d’utilisation d’une pile
Tout navigateur possède un bouton permettant de retourner sur des pages que l’on a déjà consultées.
Expliquer quelle structure de données permet de réaliser cette opération simplement et décrire les opérations en jeu.
Implémentation d’une structure de Pile à l’aide d’une liste Python
L’idée est de définir le type Pile à l’aide d’une classe ne possédant qu’un seul attribut nommé contenu, qui référence une liste, puis de créer les méthodes de la spécification.
On peut, par la suite, utiliser les méthodes des listes de Python.
Définir une classe nommée Pile et faire en sorte qu’à l’initialisation de tout objet de type Pile, l’attribut contenu référence une liste vide.
Écrire le code de la méthode est_vide de la spécification.
Écrire le code de la méthode empiler de la spécification.
Écrire le code de la méthode depiler de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de dépiler une pile vide.
Écrire le code de la méthode lire de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de lire une pile vide.
Tester le code.
Vérifier que la complexité de chacune des méthodes est égale à la complexité annoncée dans la spécification.
L’implémentation à l’aide des listes Python est efficace car, en moyenne, les méthodes append et pop, s’exécutent en temps constant. Tous les langages ne présentent cependant pas la structure de tableau dynamique et une autre implémentation doit alors être mise en œuvre.
Implémentation d’une structure de Pile à l’aide d’une liste chaînée
L’idée est de définir le type Pile à l’aide d’une classe ne possédant qu’un seul attribut nommé contenu, qui référence une liste chaînée, puis de créer les méthodes de la spécification.
Écrire le code de la classe Cellule, cellule d’une liste chaînée.
Définir une classe nommée Pile et faire en sorte qu’à l’initialisation de tout objet de type Pile, l’attribut contenu référence la liste vide.
Écrire le code de la méthode est_vide de la spécification.
Écrire le code de la méthode empiler de la spécification. Attention à bien choisir la façon d’empiler la valeur. On peut passer d’une complexité en O(1) à une complexité en O(N) !
Écrire le code de la méthode depiler de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de dépiler une pile vide.
Écrire le code de la méthode lire de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de lire une pile vide.
Tester le code.
Vérifier que la complexité de chacune des méthodes est égale à la complexité annoncée dans la spécification.
Une pile est une structure de données de type dernier entré, premier sorti (LIFO). Elle peut être implémentée facilement à l’aide d’une liste chaînée ou avec la structure de liste (tableau dynamique) de Python.
Exercices
Exercice 1
Compléter le code de la classe Pile (version liste chaînée) en ajoutant les méthodes vider et taille.
Évaluer approximativement le nombre d’opérations élémentaires de la structure Pile effectuées par la méthode taille.
Exercice 2
Pour améliorer la complexité de la méthode taille on ajoute l’attribut taille à la classe Pile.
Reprendre le code de la classe Pile en modifiant toutes les méthodes qui doivent l’être.
L’écriture polonaise inverse des expressions mathématiques place l’opérateur après ses opérandes. Cette notation ne nécessite ni l’utilisation des parenthèses ni la définition des règles de priorité des opérateurs.
Ainsi l’expression l’expression (1+2×3)×4 s’écrit 123×+4×.
La valeur d’une telle expression peut être calculée facilement en utilisant une pile pour stocker les résultats intermédiaires. Pour cela, on observer un à un les éléments de l’expression et on effectue les actions suivantes :
si on voit un nombre, on le place sur la pile ;
si on voit un opérateur binaire, on récupère les deux nombres au sommet de la pile, on leur applique l’opérateur, et on replace le résultat au sommet de la pile.
Si l’expression est bien écrite, il doit toujours y avoir deux nombres sur la pile lorsqu’un opérateur apparaît et à la fin du processus il ne doit rester qu’un seul nombre sur la pile. Ce nombre est le résultat.
L’opérateur unaire − (l’opposé) devra être considéré comme un opérateur binaire dans cette implémentation : −3 sera donc écrit 03−.
Écrire une fonction prenant en paramètre une chaîne de caractères représentant une expression en notation polonaise inverse composée d’additions et de multiplications de nombres entiers et renvoyant la valeur de cette expression. On supposera que les éléments de cette expression sont séparés par des espaces.
Attention, cette fonction ne doit pas renvoyer de résultat si l’expression est mal écrite.
Une structure de données ou type de données abstrait est un moyen d’organiser et de manipuler les données en mémoire. Un TDA est donc définit par :
Son nom ;
Sa spécification, c’est à dire la liste des manipulations/opérations que l’on peut ou pas effectuer.
La spécification indique généralement la complexité de chacune des opérations prévues par le TDA.
Avertissement
Un type de données abstrait ne dépend pas de la manière dont la structure de données est implémentée dans le langage de programmation utilisé.
Un TDA peut être implémenté de plusieurs façons différentes.
Qu’est-ce qu’une file ?
Info
Une file est une structure de données abstraite dans laquelle les données sont organisées comme le seraient des personnes dans une file d’attente (au guichet de la poste par exemple) :
à chaque fois qu’une personne arrive, elle se place à la fin de la file ;
lorsqu’un guichet se libère, c’est la personne arrivée en premier parmi celles qui attendent qui est servie.
Spécification d’une File de valeurs de type T
Créer une file (type) :
fonction : creer_file()⟶ retourne une file vide ;
complexité : O(0) (pas tout à fait vrai mais suffisant pour comprendre la suite).
Enfiler une valeur à la fin de la file :
fonction : enfiler(f: File[T], valeur: T)⟶None ;
complexité : 1 opération élémentaire.
Accéder à la valeur située au début de la file :
fonction : lire(f: File[T])⟶ retourne la première valeur de la file ;
Complexité : 1 opération élémentaire.
Retirer la première valeur de la file :
fonction : defiler(f : File[T])⟶T ;
complexité : 1 opération élémentaire.
Tester si une file est vide :
fonction : est_vide(f: File[T])⟶ retourne un booléen ;
complexité : 1 opération élémentaire.
Avertissement
La spécification d’une file montre qu’il n’existe aucune opération élémentaire pour :
accéder à une donnée qui n’est pas la première de la file ;
déterminer combien de données contient la file.
…
À retenir
La valeur retirée de la file est toujours la première valeur à l’avoir intégrée : First In, First Out (FIFO)
Implémentation d’une structure de file à l’aide d’une liste Python
L’idée est de définir le type File à l’aide d’une classe ne possédant qu’un seul attribut nommé contenu, qui référence une liste, puis de créer les méthodes de la spécification.
On peut, par la suite, utiliser les méthodes des listes de Python.
Définir une classe nommée File et faire en sorte qu’à l’initialisation de tout objet de type File, l’attribut contenu référence une liste vide.
Écrire le code de la méthode est_vide de la spécification.
Écrire le code de la méthode enfiler de la spécification.
Écrire le code de la méthode defiler de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de défiler une file vide.
Écrire le code de la méthode lire de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de lire une file vide.
Tester le code.
La complexité de chacune des méthodes est égale à la complexité annoncée dans la spécification ?
Comment pourrait-on améliorer la complexité de la méthode defiler ?
Modifier toutes les méthodes qui doivent l’être de façon à améliorer l’implémentation de la classe File.
Implémentation d’une structure de file à l’aide d’une liste chaînée
L’idée est de définir le type File à l’aide d’une classe ne possédant qu’un seul attribut nommé contenu, qui référence une liste chaînée, puis de créer les méthodes de la spécification.
Écrire le code de la classe Cellule, cellule d’une liste chaînée.
Définir une classe nommée File et faire en sorte qu’à l’initialisation de tout objet de type File, l’attribut contenu référence la liste vide.
Écrire le code de la méthode est_vide de la spécification.
Réfléchir au code de la méthode enfiler de la spécification et établir sa complexité.
Afin de rendre le code performant, on utilise l’attribut queue. Cet attribut pointer toujours vers le dernier élément de la file.
Ajouter l’attribut queue à la définition de la classe.
Écrire le code de la méthode defiler de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de défiler une file vide.
Écrire le code de la méthode lire de la spécification.
Cette méthode doit lever une exception de type IndexError lorsqu’on essaie de lire une file vide.
Implémentation d’une structure de file à l’aide de deux piles
On considère dans cette partie le modèle d’un jeu de cartes où on disposerait d’une pioche, au sommet de laquelle on peut prendre des cartes (disposées face cachée), et d’une défausse au sommet de laquelle on peut reposer des cartes (disposées face apparente).
Chacun de ces paquets est une pile. Ils forment la réserve de cartes.
Les règles du jeu sont :
toute carte prise dans la réserve est retirée dans l’une de ces piles (la pioche) ;
toute carte remise dans la réserve est ajoutée à l’autre pile (la défausse).
On doit ajouter à ces règles une relation entre les deux paquets : une fois la pioche vide, on retourne la défausse pour en faire une nouvelle pioche, laissant à la place une défausse vide.
Cette gestion des cartes correspond à une structure de file : une fois la pioche initiale vidée, les cartes sont piochées précisément dans l’ordre dans lequel elles ont été défaussées. La première défaussée est la première piochée (FIFO).
Définir une classe nommée File et faire en sorte qu’à l’initialisation de tout objet de type File, les attributs entree et sortie soient créés en référencent deux piles vides.
Écrire le code de la méthode est_vide de la spécification.
Une file est vide lorsque les deux piles sont vides.
Ajouter un nouvel élément à la file consiste à empiler cet élément sur la pile d’entrée.
Écrire le code de la méthode enfiler de la spécification.
Pour retirer la valeur la plus ancienne dans la file deux cas sont à considérer :
la pile de sortie n’est pas vide : la valeur est la dernière de cette pile. Il suffit donc de dépiler la pile de sortie.
la pille de sortie est vide : il faut d’abord dépiler la pile d’entrée dans la pile de sortie puis dépiler cette pile de sortie.
Écrire le code de la méthode defiler de la spécification.
Écrire le code de la méthode lire de la spécification (le problème à considérer est très similaire à celui du retrait de la première valeur).
Une file est une structure de données de type premier entré, premier sorti (FIFO). Elle peut être implémentée facilement à l’aide d’une liste chaînée, avec la structure de liste (tableau dynamique) de Python ou à l’aide de deux piles.
Physique, Chimie et Informatique > Terminales Spé. NSI
- Identifier des situations nécessitant une structure de données arborescente. - Évaluer quelques mesures des arbres binaires (taille, encadrement de la hauteur, etc.).
- On fait le lien avec la rubrique « algorithmique ».
…de la partie « Algorithmique »
Contenus
Capacités attendues
Commentaires
- Algorithmes sur les arbres binaires et sur les arbres binaires de recherche.
- Calculer la taille et la hauteur d’un arbre. Parcourir un arbre de différentes façons (ordres infixe, préfixe ou suffixe ; ordre en largeur d’abord). Rechercher une clé dans un arbre de recherche, insérer une clé.
- Une structure de données récursive adaptée est utilisée. L’exemple des arbres permet d’illustrer la programmation par classe. La recherche dans un arbre de recherche équilibré est de coût logarithmique.
Structures de données abstraites arborescentes : les arbres
La notion de listes chaînées est parfaite pour structurer un ensemble d’élements destinés à être énumérés séquentiellement. Elle permet aussi d’implémenter les structures de piles et de files. Elle n’est cependant pas adaptée aux accès spécifiques à des positions données dans la séquence, puisqu’il faut alors parcourir toutes les cellules depuis le début de la liste jusqu’à la position souhaitée (complexité en O(N)).
Lorsqu’on manipule une information présentant une certaine hiérarchie, il est commun de la représenter graphiquement :
Arbre généalogique
graph TD
A(Jules) --> B(Mireille)
A(Jules) --> C(Gérard)
A(Jules) --> D(Guy)
B --> E(David)
E --> F(Gabriel)
E --> G(Louise)
C --> H(Fabien)
D --> I(Sandra)
D --> J(Marion)
Arborescence d’un système de fichier
graph TD
A(/) --> B(bin)
A --> C(root)
A --> D(home)
A --> F(etc)
A --> G(var)
A --> H(usr)
A --> I(tmp)
D --> J(mats)
J --> K(Documents)
J --> L(Images)
J --> M(Vidéos)
K --> N(Terminale)
N --> O(NSI)
N --> P(PC)
Expression mathématique
graph TD
A(+) --> B(*)
B --> C(3)
B --> D(8)
A --> E(6)
Exercice
écrire l’expression mathématique représentée par l’arbre ci-dessus.
Un arbre lexicographique, ou arbre en parties communes, ou dictionnaire, représente un ensemble de mots. Les préfixes communs à plusieurs mots n’apparaissent qu’une seule fois dans l’arbre.
graph TD
A(.) --> B(m)
B --> C(a)
C --> D(i)
D --> E(s)
E --> F(o)
F --> G(n)
D --> H(t)
H --> I(r)
I --> J(i)
J --> K(s)
K --> L(e)
L --> M(r)
C --> N(t)
N --> O(e)
O --> P(l)
P --> Q(a)
Q --> R(t)
P --> S(o)
S --> T(t)
A --> U(v)
U --> V(a)
V --> W(l)
W --> X(i)
X --> Y(s)
Y --> Z(e)
Exercice
Quels sont les mots représentés dans l’arbre ?
Exercice
Ajouter les mots « matériel » et « vallon ».
Remarque : ne pas différencier les lettres é et e.
Réponse
Définitions et vocabulaire
Arbre (enraciné)
À retenir
Un arbre (nom complet arbre enraciné) est une structure de données abstraite arborescente dans laquelle les données sont hiérarchisées depuis un nœud racine.
Un arbre dont tous les nœuds sont nommés est dit étiqueté. L’étiquette (ou nom du sommet) représente la « valeur » du nœud ou bien l’information associée au nœud.
Racine, noeud, branche, feuille
À retenir
Un arbre est un ensemble organisé de nœuds dans lequel chaque nœud a un père, sauf un nœud que l’on appelle le nœud racine.
Si le nœud n’a pas de fils, on dit que c’est une feuille.
Les nœuds sont reliés par des branches.
Exercice
Nommer les nœuds puis les feuilles dans l’arbre représenté ci-dessous.
Compter le nombre de branches.
graph TD
A(a) --> B(b)
A --> C(c)
B --> D(d)
B --> E(e)
E --> F(f)
E --> G(g)
B --> H(h)
H --> I(i)
Réponses
Nœuds internes: a (racine), b, e, h et feuilles : c, d, f, g, i.
8 branches.
Profondeur d’un nœud, hauteur d’un nœud
À retenir
La profondeur d’un nœud est sa distance à la racine.
La profondeur d’un nœud dans un arbre est donc le nombre d’arrêtes qu’il faut parcourir, depuis la racine, pour parvenir au nœud.
À retenir
La hauteur d’un nœud est sa distance à la feuille la plus profonde ayant une relation de descendance avec lui.
La hauteur d’un nœud dans un arbre est donc le nombre d’arrêtes qu’il faut parcourir, depuis ce nœud jusqu’à la feuille la plus profonde ayant une relation de descendance avec lui.
Profondeur d’un arbre
À retenir
La hauteur (ou profondeur) d’un arbre est égale à la profondeur du nœud le plus profond.
Info
La hauteur d’un arbre est très importante. En effet, la plupart des algorithmes que nous verrons dans la suite ont une complexité qui dépend de la hauteur de l’arbre. Ainsi plus l’arbre aura une hauteur élevée, plus l’algorithme mettra de temps à s’exécuter.
Avertissement
Tous les auteurs n’utilisent pas la convention choisie dans ce cours !
Pour certains, la profondeur d’un nœud est égale au nombre de nœuds qu’il faut parcourir à partir de la racine (incluse) pour parvenir au nœud ; la hauteur de la racine est alors de 1.
Exercice
Donner la profondeur du nœud e dans l’arbre représenté ci-dessus.
Donner la hauteur du nœud e dans l’arbre représenté ci-dessus.
Quelle est la profondeur de cet arbre ?
Réponses
Profondeur de e : 2.
Hauteur de e : 1.
Profondeur de l’arbre : 3.
Taille d’un arbre
À retenir
La taille d’un arbre est égale au nombre de nœuds de l’arbre (nœuds internes et feuilles).
Exercice
Indiquer la taille de l’arbre représenté ci-dessus.
Réponses
Taille de l’arbre : 9.
Degré d’un noeud, degré d’un arbre
À retenir
Le degré d’un nœud est égal au nombre de ses descendants (fils).
Le degré d’un arbre est égal au plus grand des degrés de ses nœuds.
Exercice
Quel est le degré du nœud b dans l’arbre représenté ci-dessus ?
Quel est le degré du nœud a ?
Quel est le degré de l’arbre ?
Réponses
Degré de b : 3.
Degré de a : 2.
Degré de l’arbre : 3.
Relation entre les liste et les arbres
À retenir
Un arbre dont tous les nœuds n’ont qu’un seul fils est en fait une liste.
Physique, Chimie et Informatique > Terminales Spé. NSI > Structures hiérarchiques : les arbres
Un arbre binaire est une structure de données abstraite formée d’un ensemble de nœuds organisés hiérarchiquement selon la définition par récurrence suivante :
Un arbre binaire est :
soit un arbre vide, noté E, ne contenant aucun nœud ;
soit un nœud, appelé racine, relié à exactement deux arbres binaires g et d, respectivement appelés sous-arbres gauche et sous-arbre droit.
On note T(r,g,d) l’arbre non vide dont la racine r (on peut aussi indiquer l’étiquette de cette racine).
Vocabulaire et remarques
Un nœud dont les deux sous-arbres sont vides est appelé une feuille.
Un nœud qui n’est pas une feuille est un nœud interne.
Un arbre binaire est dit parfait si toutes les feuilles sont à la même profondeur.
La racine d’un arbre T est le seul nœud de T sans parent.
Propriétés
Position des sous-arbres
La position des sous-arbres gauche et droite est fondamentale :
T(r,g,d)=T(r,d,g)
Taille d’un arbre
La taille d’un arbre est égale au nombre de nœuds qu’il comporte.
Le nombre de nœuds d’un arbre binaire T, noté n(T), se calcule récursivement :
n(E)=0
n(T)=1+n(g)+n(d)
Profondeur d’un nœud
La profondeur d’un nœud n, notée h(n), est sa distance à la racine.
La profondeur d’un nœud n, notée h(n), est définie récursivement par :
h(racine)=0
h(n)=1+h(parent de n)
La profondeur d’un nœud dans un arbre est donc le nombre d’arrêtes qu’il faut parcourir, depuis la racine, pour parvenir au nœud.
Avertissement
La définition de la profondeur d’un nœud peut varier ! Il est impératif de vérifier celle choisie avant tout travail.
Hauteur d’un arbre
La hauteur d’un arbre est la profondeur du nœud le plus éloigné de la racine.
La hauteur d’un arbre est aussi sa profondeur.
La hauteur d’un arbre binaire T, notée h(T) est définie récursivement par :
h(E)=−1 si l’arbre est vide ;
h(T)=1+max(h(g),h(d))
Remarque
On peut aussi définir la hauteur d’un nœud : la hauteur d’un nœud est la distance entre ce nœud et la feuille la plus profonde ayant une relation de descendance avec ce nœud.
Avertissement
La définition de la hauteur d’un arbre peut varier ! Il est impératif de vérifier celle choisie avant tout travail.
Relation entre le nombre de nœuds n et la hauteur d’un arbre
Soit T un arbre binaire, n son nombre de nœuds et h sa hauteur. Ces grandeurs sont liées par les relations suivantes :
h+1≤n≤2h+1−1
le nombre de sous-arbres vides de T est n+1.
Dans quel cas a-t-on N=h+1 ?
Réponse
On a N=h+1 lorsque chaque nœud ne possède qu’un seul nœud fils. Il s’agit donc d’une structure linéaire (liste).
Dans quel cas a-t-on N=2h+1−1 ?
Réponse
On a N=2h+1−1 lorsque l’arbre binaire est parfait, c’est à dire lorsque toutes les feuilles ont la même profondeur.
Spécification d’un arbre binaire
À retenir
Créer un nœud (type) :
fonction : creer_nœud()⟶ retourne un nœud ;
fils_gauche et fils_droit sont automatiquement initialisés à None ;;
complexité : O(0) (pas tout à fait vrai mais suffisant pour comprendre la suite).
Lire dans le champ valeur :
fonction : lire_valeur(n: Noeud[T])⟶T ;
complexité : 1 opération élémentaire.
Écrire dans le champ valeur :
fonction : modifier_valeur(n: Noeud[T], valeur: T)⟶None ;
complexité : 1 opération élémentaire.
Lire dans le champ fils_gauche :
fonction : lire_filsG(n: Noeud[T])⟶Noeud[T] ;
complexité : 1 opération élémentaire.
Écrire dans le champ fils_gauche :
fonction : modifier_filsG(n: Noeud[T], m: Noeud[T])⟶None ;
complexité : 1 opération élémentaire.
Lire dans le champ fils_droit :
fonction : lire_filsD(n: Noeud[T])⟶Noeud[T] ;
complexité : 1 opération élémentaire.
Écrire dans le champ fils_droit :
fonction : modifier_filsD(n: Noeud[T], m: Noeud[T])⟶None ;
complexité : 1 opération élémentaire.
Avertissement
Tout comme on a désigné les listes chaînées par leur première cellule, on va désigner les arbres par leur nœud racine.
Implémentation de la spécification en Python à l’aide d’une classe
Il existe de nombreuses façons de d’implémenter la structure d’arbre en Python. Dans cette partie on va utiliser une classe.
Avertissement
Le paradigme de programmation utilisé ci-dessous est le paradigme impératif : on crée dans un premier temps une structure élémentaire qui ne sert qu’à stocker les différentes valeurs et on définit ensuite des fonctions qui manipulent cette structure.
La structure utilisée peut être :
Une classe qui définit trois attributs valeur, gauche et droit et aucune méthode ;
Une liste Python de trois éléments ;
Un dictionnaire comportant trois clés : valeur, gauche et droit.
On peut même imaginer utiliser un tableau ou une liste chaînée !
On ne créera pas de structure « arbre binaire » (accompagnée de méthodes) dans ce document.
Écrire le code de la classe Noeud respectant la spécification. Les trois attributs seront nommés valeur, gauche, droit.
Réponse
from__future__importannotationsclassNoeud:"""
Structure de stockage pour créer des arbres binaires.
"""def__init__(self:Noeud,val:str,g:Noeud=None,d:Noeud=None)->None:"""Initialisation de l'objet."""self.valeur=valself.gauche=gself.droit=d
Écrire le code permettant de construire l’arbre :
graph TD
A("A") --- B("B")
B --- G(None)
B --- C("C")
C --- H(None)
C --- I(None)
A --- D("D")
D --- E(None)
D --- F(None)
Écrire le code de la fonction est_vide dont la spécification est :
defest_vide(n:Noeud)->bool:"""
Teste si un arbre est vide.
"""
Réponse
defest_vide(n:Noeud)->bool:"""
Teste si un arbre est vide.
"""returnn==None
Écrire le code de la fonction ajoute_filsG dont la spécification est :
defajoute_filsG(n:Noeud,valeur:str)->None:"""
Ajoute un noeud d'étiquette valeur comme fils gauche.
"""
Réponse
defajoute_filsG(n:Noeud,valeur:str)->None:"""
Ajoute un noeud d'étiquette valeur comme fils gauche.
"""ifest_vide(n.gauche):n.gauche=Noeud(valeur)else:raiseException("Le nœud possède déjà un fils gauche !")
Écrire le code de la fonction ajoute_filsD dont la spécification est :
defajoute_filsD(n:Noeud,valeur:str)->None:"""
Ajoute un noeud d'étiquette valeur comme fils droit.
"""
Réponse
defajoute_filsD(n:Noeud,valeur:str)->None:"""
Ajoute un noeud d'étiquette valeur comme fils droit.
"""ifest_vide(n.droit):n.droit=Noeud(valeur)else:raiseException("Le nœud possède déjà un fils droit !")
Écrire le code de la fonction est_feuille dont la spécification est :
defest_feuille(n:Noeud)->bool:"""
Teste si un noeud est une feuille.
"""
Réponse
defest_feuille(n:Noeud)->bool:"""
Teste si un noeud est une feuille.
"""returnest_vide(n.gauche)andest_vide(n.droit)
Écrire le code de la fonction degre_noeud dont la spécification est :
defdegre_noeud(n:Noeud)->int:"""
Détermine le degré du noeud passé en argument.
"""
Quelques algorithmes de manipulation des arbres binaires
Tous les algorithmes qui suivent sont récursifs.
Écrire le code de la fonction taille dont la spécification est :
deftaille(n:Noeud)->int:"""
Retourne le nombre de noeud dans l'arbre.
"""
Réponse
deftaille(n:Noeud)->int:"""
Retourne le nombre de noeud dans l'arbre.
"""ifest_vide(n):# Cas de base : un arbre vide ne contient aucun noeud.return0else:# Recherche récursive dans les sous-arbres gauche et droit.taille_gauche=taille(n.gauche)taille_droit=taille(n.droit)# Calcul de la taillereturn1+taille_gauche+taille_droit
Écrire le code de la fonction profondeur dont la spécification est :
defprofondeur(n:Noeud)->int:"""
Retourne la profondeur de l'arbre.
"""
Réponse
defprofondeur(n:Noeud)->int:"""
Retourne la profondeur de l'arbre.
"""ifest_vide(n):# Cas de base : si le nœud est vide, il n'est pas dans l'arbre.return-1else:# Recherche récursive dans les sous-arbres gauche et droit.arbre_gauche=profondeur(n.gauche)arbre_droit=profondeur(n.droit)# Détermine la profondeurreturn1+max(arbre_gauche,arbre_droit)
Écrire le code de la fonction nbre_feuilles dont la spécification est :
defnbre_feuilles(n:Noeud)->int:"""
Détermine le nombre de feuilles dans l'arbre.
"""
Réponse
defnbre_feuilles(n:Noeud)->int:"""
Détermine le nombre de feuilles dans l'arbre.
"""ifest_vide(n):# Cas de base : un arbre vide ne contient aucune feuillereturn0elifest_feuille(n):# Cas de base : on ajoute 1 au total dès qu'on rencontre une feuillereturn1else:# Recherche récursive dans les sous-arbres gauche et droit.nbre_feuilles_gauche=nbre_feuilles(n.gauche)nbre_feuilles_droit=nbre_feuilles(n.droit)# Calcul du nombre de feuillesreturnnbre_feuilles_gauche+nbre_feuilles_droit
Écrire le code de la fonction profondeur_noeud dont la spécification est :
defprofondeur_noeud(n:Noeud,val:str,prof:int=0)->int:"""
Détermine la profondeur du noeud de valeur val.
"""
Réponse
defprofondeur_noeud(n:Noeud,val:str,prof:int=0)->int:"""
Détermine la profondeur du noeud de valeur val.
Retourne -1 si le noeud n'est pas dans l'arbre.
prof est la profondeur.
"""ifest_vide(n):# Cas de base : si le nœud est vide, il n'est pas dans l'arbre.return-1elifn.valeur==val:# On a trouvé le noeudreturnprofelse:# Recherche récursive dans les sous-arbres gauche et droit.# Incrémente la profondeurprof_gauche=profondeur_noeud(n.gauche,val,prof+1)prof_droite=profondeur_noeud(n.droit,val,prof+1)# Valeur retournéereturnmax(prof_gauche,prof_droite)
Exemple : recherche de la profondeur du nœud de valeur 3
Les nœuds passés en argument sont repérés par la notation 1n, 2n, …
Écrire le code de la fonction remplace dont la spécification est :
defremplace(n:Noeud,val_ini:str,val_fin:str)->None:"""
Cherche tous les noeuds de valeur val_ini et remplace ces
dernières par val_fin.
"""
Réponse
defremplace(n:Noeud,val_ini:str,val_fin:str)->None:"""
Cherche tous les noeuds de valeur val_ini et remplace ces
dernières par val_fin.
"""ifest_vide(n):returnNoneelifn.valeur==val_ini:n.valeur=val_finelse:remplace(n.gauche,val_ini,val_fin)remplace(n.droit,val_ini,val_fin)
Écrire le code de la fonction ajoute dont la spécification est :
defajoute(n:Noeud,parent:str,enfant:str,gauche:bool)->None:"""
Ajoute un noeud de valeur enfant comme enfant du noeud de valeur
parent.
Le noeud enfant est placé par défaut à gauche.
HYPOTHÈSE : Le noeud de valeur parent existe.
"""
Réponse
defajoute(n:Noeud,parent:str,enfant:str,gauche:bool)->None:"""
Ajoute un noeud de valeur enfant comme enfant du noeud de valeur
parent.
Le noeud enfant est placé par défaut à gauche.
HYPOTHÈSE : Le noeud de valeur parent existe.
"""ifest_vide(n):returnNoneelifn.valeur==parent:ifgaucheandnotest_vide(n.gauche):raiseException("Le noeud enfant gauche existe déjà !")ifnotgaucheandnotest_vide(n.droit):raiseException("Le noeud enfant droit existe déjà !")ifgauche:n.gauche=Noeud(enfant)else:n.droit=Noeud(enfant)else:ajoute(n.gauche,parent,enfant,gauche)ajoute(n.droit,parent,enfant,gauche)
Écrire le code de la fonction supprime dont la spécification est :
defsupprime(n:Noeud,val:str)->None:"""
Supprime le noeud de valeur val ainsi que tous ses descendants.
"""
Réponse
defsupprime(n:Noeud,val:str)->None:"""
Supprime le noeud de valeur val ainsi que tous ses descendants.
"""ifest_vide(n):returnNoneelifest_feuille(n):returnNoneelifn.gauche.valeur==val:n.gauche=Noneelifn.droit.valeur==val:n.droit=Noneelse:supprime(n.gauche,val)supprime(n.droit,val)
Quelles sont les complexités des algorithmes implémentés dans cette section ?
Réponse
Les algorithmes parcourent une fois chaque nœud de l’arbre. La complexité est donc proportionnelle au nombre de nœuds.
Parcours en profondeur d’un arbre
Les fonction écrites jusqu’à présent parcourent en profondeur tous les nœuds des arbres sans que l’ordre dans lequel ce parcourt est effectué ait la moindre importance.
À retenir
Si on souhaite donner un affichage de l’arbre, la façon dont on le parcourt prend alors une grande importance. On peut :
Parcourir le sous-arbre gauche, afficher la valeur du nœud racine puis enfin parcourir le sous-arbre droit. On parle d’un parcours infixe.
Afficher la valeur du nœud racine avant de parcourir le sous-arbre gauche puis le sous-arbre droit. On parle d’un parcours préfixe.
Parcourir le sous-arbre gauche, le sous-arbre droit puis afficher les valeurs. On parle d’un parcours suffixe.
Pour l’arbre ci-dessous, donner les parcours préfixe, infixe et suffixe.
Écrire le code des fonctions parcours_infixe, parcours_prefixe et parcours_suffixe dont les spécifications sont :
defparcours_infixe(n:Noeud)->str:"""
Parcourt le sous-arbre gauche, affiche la valeur du nœud puis parcourt le sous-arbre droit.
Retourne le parcours sous forme d'une chaîne de caractères.
"""
Réponse
defparcours_infixe(n:Noeud)->str:"""
Parcourt le sous-arbre gauche, affiche la valeur du nœud puis parcourt le sous-arbre droit.
Retourne le parcours sous forme d'une chaîne de caractères.
"""ifest_vide(n):return""else:chaine=parcours_infixe(n.gauche)chaine+=str(n.valeur)chaine+=parcours_infixe(n.droit)returnchaine
defparcours_prefixe(n:Noeud)->None:"""
Parcourt le sous-arbre gauche, affiche la valeur du nœud puis parcourt le sous-arbre droit.
Retourne le parcours sous forme d'une chaîne de caractères.
"""
Réponse
defparcours_prefixe(n:Noeud)->None:"""
Parcourt le sous-arbre gauche, affiche la valeur du nœud puis parcourt le sous-arbre droit.
Retourne le parcours sous forme d'une chaîne de caractères.
"""ifest_vide(n):return""else:chaine=str(n.valeur)chaine+=parcours_prefixe(n.gauche)chaine+=parcours_prefixe(n.droit)returnchaine
defparcours_suffixe(n:Noeud)->None:"""
Parcourt le sous-arbre gauche, affiche la valeur du nœud puis parcourt le sous-arbre droit.
Retourne le parcours sous forme d'une chaîne de caractères.
"""
Réponse
defparcours_suffixe(n:Noeud)->None:"""
Parcourt le sous-arbre gauche, affiche la valeur du nœud puis parcourt le sous-arbre droit.
Retourne le parcours sous forme d'une chaîne de caractères.
"""ifest_vide(n):return""else:chaine=parcours_suffixe(n.gauche)chaine+=parcours_suffixe(n.droit)chaine+=str(n.valeur)returnchaine
Algorithmes itératifs — Parcours d’un arbre à l’aide d’une file ou d’une pile
Parcours en largeur d’un arbre
Décrire le fonctionnement de l’algorithme suivant et montrer qu’il réalise un parcours en largeur d’un arbre.
Fonction parcours_largeur(racine: Noeud):
File f= File() f.enfiler(racine) TantQue non f.est_vide():
n= f.defiler() print(n.valeur) Si non est_vide(n.filsG):
f.enfiler(n.filsG) FinSi
Si non est_vide(n.filsD):
f.enfiler(n.filsD) FinSi
FinTantQue
FinFonction
Implémenter en Python cet algorithme.
Réponse
defparcours_largeur(n:Noeud)->str:"""Réalise le parcours en largeur d'un arbre binaire."""message=""f=File()f.enfiler(n)whilenotf.est_vide():n=f.defiler()message+=str(n.valeur)ifnotest_vide(n.gauche):f.enfiler(n.gauche)ifnotest_vide(n.droit):f.enfiler(n.droit)returnmessage
Parcours en profondeur d’un arbre
Décrire le fonctionnement de l’algorithme suivant et montrer qu’il réalise un parcours en profondeur d’un arbre.
De quel type de parcours en profondeur s’agit-il ?
Fonction parcours_profondeur(racine: Noeud):
Pile p= Pile() p.empiler(racine) TantQue non p.est_vide():
n= p.depiler() print(n) Si non est_vide(n.filsG):
p.empiler(n.filsG) FinSi
Si non est_vide(n.filsD):
p.empiler(n.filsD) FinSi
FinTantQue
FinFonction
Réponse
L’algorithme semble realiser un parcours préfixe mais en explorant d’abord le sous-arbre droit au lieu d’explorer le sous-arbre gauche.
Modifier l’algorithme de telle sorte qu’il réalise le parcours préfixe.
Réponse
Fonction parcours_profondeur(racine: Noeud):
Pile p= Pile() p.empiler(racine) TantQue non p.est_vide():
n= p.depiler() print(n) Si non est_vide(n.filsD):
p.empiler(n.filsD) FinSi
Si non est_vide(n.filsG):
p.empiler(n.filsG) FinSi
FinTantQue
FinFonction
Implémenter en Python cet algorithme.
Réponse
defparcours_prefixe_iter(n:Noeud)->str:"""
Réalise un parcours préfixe à l'aide d'une pile.
"""message=""p=Pile()p.empiler(n)whilenotp.est_vide():n=p.depiler()message+=str(n.valeur)ifnotest_vide(n.gauche):p.empiler(n.gauche)ifnotest_vide(n.droit):p.empiler(n.droit)returnmessage
Implémentation de la spécification en Python à l’aide d’une liste Python
Reprendre toutes les fonctions de ce document en n’utilisant pas la classe Noeud mais une liste à trois éléments. Le premier est la « valeur » du noeud, le second l’adresse du fils gauche, le troisième l’adresse du fils droit.
Réponse
"""
Implémentation d'un arbre binaire en utilisant le
paradigme impératif et des listes.
Structure d'un noeud : [valeur, gauche, droit]
"""defest_vide(n:list[str,list,list])->bool:"""
Teste si un arbre est vide.
"""returnnisNonedefajoute_filsG(n:list[str,list,list],valeur:str)->None:"""
Ajoute un noeud d'étiquette valeur comme fils gauche.
"""ifest_vide(n[1]):n[1]=[valeur,None,None]else:raiseException("Le nœud possède déjà un fils gauche !")defajoute_filsD(n:list[str,list,list],valeur:str)->None:"""
Ajoute un noeud d'étiquette valeur comme fils droit.
"""ifest_vide(n[2]):n[2]=[valeur,None,None]else:raiseException("Le nœud possède déjà un fils droit !")defest_feuille(n:list[str,list,list])->bool:"""
Teste si un noeud est une feuille.
"""returnest_vide(n[1])andest_vide(n[2])defdegre_noeud(n:list[str,list,list])->int:"""
Détermine le degré du noeud passé en argument.
"""ifest_vide(n):raiseException("Le nœud est vide !")nbre=0ifnotest_vide(n[1]):nbre+=1ifnotest_vide(n[2]):nbre+=1returnnbredeftaille(n:list[str,list,list])->int:"""
Retourne le nombre de noeud dans l'arbre.
"""ifest_vide(n):return0else:return1+taille(n[1])+taille(n[2])defprofondeur(n:list[str,list,list])->int:"""
Retourne la profondeur de l'arbre.
"""ifest_vide(n):return-1else:return1+max(profondeur(n[1]),profondeur(n[2]))defnbre_feuilles(n:list[str,list,list])->int:"""
Détermine le nombre de feuilles dans l'arbre.
"""ifest_vide(n):return0elifest_feuille(n):return1else:returnnbre_feuilles(n[1])+nbre_feuilles(n[2])defparcours_pref(n:list[str,list,list])->str:"""Parcours en profondeur préfixe d'un arbre binaire."""ifest_vide(n):return""else:chaine=str(n[0])chaine+=parcours_pref(n[1])chaine+=parcours_pref(n[2])returnchainedefparcours_inf(n:list[str,list,list])->str:"""Parcours en profondeur infixe d'un arbre binaire."""ifest_vide(n):return""else:chaine=parcours_inf(n[1])chaine+=str(n[0])chaine+=parcours_inf(n[2])returnchainedefparcours_suf(n:list[str,list,list])->str:"""Parcours en profondeur infixe d'un arbre binaire."""ifest_vide(n):return""else:chaine=parcours_suf(n[1])chaine+=parcours_suf(n[2])chaine+=str(n[0])returnchaineif__name__=="__main__":arb=["A",["B",["C",None,None],["D",None,None]],["E",["F",None,None],["G",["H",None,None],None]],]print(est_vide(arb))print(f"Taille de l'arbre : {taille(arb)}")print(f"Profondeur (hauteur) de l'arbre : {profondeur(arb)}")print(f"Préfixe : {parcours_pref(arb)}")print(f"Infixe : {parcours_inf(arb)}")print(f"Suffixe : {parcours_suf(arb)}")
Implémentation de la spécification en Python à l’aide d’un dictionnaire
Reprendre toutes les fonctions de ce document en n’utilisant pas la classe Noeud mais un dictionnaire à trois clés : valeur, gauche et droit pour stocker la « valeur » du noeud, l’adresse du fils gauche et l’adresse du fils droit.
Réponse
"""
Implémentation du type arbre binaire en utilisant
le paradigme impératif et des dictionnaires.
"""defest_vide(n:dict[str,dict,dict])->bool:"""
Teste si un arbre est vide.
"""returnn==Nonedefajoute_filsG(n:dict[str,dict,dict],val:str)->None:"""
Ajoute un noeud d'étiquette val comme fils gauche.
"""ifest_vide(n["gauche"]):n["gauche"]={"valeur":val,"gauche":None,"droit":None}else:raiseException("Le nœud possède déjà un fils gauche !")defajoute_filsD(n:dict[str,dict,dict],val:str)->None:"""
Ajoute un noeud d'étiquette valeur comme fils droit.
"""ifest_vide(n["droit"]):n["droit"]={"valeur":val,"gauche":None,"droit":None}else:raiseException("Le nœud possède déjà un fils droit !")defest_feuille(n:dict[str,dict,dict])->bool:"""
Teste si un noeud est une feuille.
"""returnest_vide(n["gauche"])andest_vide(n["droit"])defdegre_noeud(n:dict[str,dict,dict])->int:"""
Détermine le degré du noeud passé en argument.
"""ifest_vide(n):raiseException("Le nœud est vide !")nbre=0ifnotest_vide(n["gauche"]):nbre+=1ifnotest_vide(n["droit"]):nbre+=1returnnbredeftaille(n:dict[str,dict,dict])->int:"""
Retourne le nombre de noeud dans l'arbre.
"""ifest_vide(n):return0else:return1+taille(n["gauche"])+taille(n["droit"])defprofondeur(n:dict[str,dict,dict])->int:"""
Retourne la profondeur de l'arbre.
"""ifest_vide(n):return-1else:return1+max(profondeur(n["gauche"]),profondeur(n["droit"]))defnbre_feuilles(n:dict[str,dict,dict])->int:"""
Détermine le nombre de feuilles dans l'arbre.
"""ifest_vide(n):return0elifest_feuille(n):return1else:returnnbre_feuilles(n["gauche"])+nbre_feuilles(n["droit"])defparcours_pref(n:dict[str,dict,dict])->str:"""Parcours en profondeur préfixe d'un arbre binaire."""ifest_vide(n):return""else:returnstr(n["valeur"])+parcours_pref(n["gauche"])+parcours_pref(n["droit"])defparcours_inf(n:dict[str,dict,dict])->str:"""Parcours en profondeur infixe d'un arbre binaire."""ifest_vide(n):return""else:returnparcours_inf(n["gauche"])+str(n["valeur"])+parcours_inf(n["droit"])defparcours_suf(n:dict[str,dict,dict])->str:"""Parcours en profondeur infixe d'un arbre binaire."""ifest_vide(n):return""else:returnparcours_suf(n["gauche"])+parcours_suf(n["droit"])+str(n["valeur"])if__name__=="__main__":arb={"valeur":"A","gauche":None,"droit":{"valeur":"B","gauche":{"valeur":"C","gauche":None,"droit":None},"droit":{"valeur":"D","gauche":None,"droit":None},},}print(est_vide(arb))print(parcours_inf(arb))arb2={"valeur":"A","droit":None,"gauche":None}ajoute_filsG(arb2,"B")ajoute_filsD(arb2,"C")noeud_C=arb2["droit"]ajoute_filsD(noeud_C,"D")ajoute_filsG(noeud_C,"E")print(f"Taille de l'arbre : {taille(arb2)}")print(f"Profondeur (hauteur) de l'arbre : {profondeur(arb2)}")print(parcours_pref(arb2))print(parcours_inf(arb2))print(parcours_suf(arb2))
À retenir
À retenir
Un arbre binaire est un ensemble fini de nœuds, qui est soit vide (la valeur None est utilisée pour représenter l’arbre vide), soit structuré à partir d’un nœud particulier, appelé racine de l’arbre, et de deux sous-ensembles de nœuds formant récursivement un sous-arbre gauche et un sous-arbre droit.
Un arbre peut-être implémenté en Python avec un objet par nœud, d’une classe qui possède trois attributs : la valeur (ou étiquette) du nœud, le sous-arbre gauche et le sous-arbre droit. Il peut aussi être implémenté en utilisant une liste à trois éléments ou un dictionnaire à trois éléments.
Physique, Chimie et Informatique > Terminales Spé. NSI > Structures hiérarchiques : les arbres
d’organiser les données selon un ordre donné (numérique, lexicographique, etc.) ;
d’effectuer des recherches le plus efficacement possible ;
d’accéder à, d’insérer ou de supprimer les données le plus efficacement possible.
Tableaux
Propriétés
On peut ordonner des données dans un tableau mais l’algorithme de tri le plus rapide, pour un jeu de données aléatoires, est en O(nlogn) ;
On peut accéder à une donnée en O(1) ;
On peut rechercher une valeur efficacement en utilisant la dichotomie (si le tableau est trié !) : O(logn) ;
Supprimer ou insérer une valeur n’est pas très efficace : O(n) (sauf à la fin du tableau).
Dictionnaires
Propriétés
Accéder à, supprimer et insérer une valeur se fait très efficacement : O(1) ;
Les données ne sont pas ordonnées.
Remarque
Dans la suite de ce document, on considérera que les valeurs des nœuds sont des entiers.
À retenir
Un arbre binaire de recherche, ou ABR, est un arbre binaire avec la propriété suivante : quel que soit le nœud x, tous les nœuds situés dans le sous-arbre gauche de x ont une valeur inférieure à la valeur du nœud x, et tous ceux situés dans son sous-arbre droit ont une valeur supérieure à la valeur du nœud x.
Remarque
La définition précédente est récursive.
Cet arbre binaire est-il un arbre binaire de recherche ?
graph TD
A(3) --- B(1)
B --- C(None)
B --- D(2)
D --- E(None)
D --- F(None)
A --- G(4)
G --- H(None)
G --- I(None)
Réponse
oui
Cet arbre binaire est-il un arbre binaire de recherche ?
graph TD
A(3) --- B(2)
B --- C(1)
C --- D(None)
C --- E(None)
B --- F(None)
A --- G(4)
G --- H(None)
G --- I(None)
Réponse
oui
Cet arbre binaire est-il un arbre binaire de recherche ?
graph TD
A(3) --- B(2)
B --- C(None)
B --- D(1)
D --- E(None)
D --- F(None)
A --- G(4)
G --- H(None)
G --- I(None)
Réponse
Non ! La propriété est bien vérifiée pour la racine mais pas pour le sous-arbre gauche.
La définition est récursive !
Info
Les ABR servent à maintenir un ensemble de valeurs ordonnées, avec une meilleure complexité qu’une liste chaînée par exemple. On commence par la recherche d’un élément. La structure de l’ABR permet d’éviter de le parcourir en entier.
Un ABR est un arbre binaire
Avertissement
Le paradigme de programmation utilisé ci-dessous est le paradigme impératif : on crée dans un premier temps une structure élémentaire à l’aide d’une classe et on définit ensuite des fonctions qui manipulent cette structure.
On ne crée pas de structure arbre binaire (accompagnée de méthodes).
Pour représenter un ABR, on va à nouveau utiliser la classe Noeud. Écrire à nouveau le code de cette classe. Les contraintes sur les valeurs des nœuds ne sont pas codées dans la classe.
À quel arbre binaire de recherche ce code correspond-il ?
# Création d'un arbre binaire de recherchearbre= Noeud(10)arbre.gauche = Noeud(5)arbre.droit = Noeud(15)arbre.gauche.gauche = Noeud(3)arbre.gauche.droit = Noeud(8)arbre.droit.gauche = Noeud(12)arbre.droit.droit = Noeud(18)
Réponse
graph TD
A(10) --- B(5)
A --- C(15)
B --- D(3)
B --- E(8)
C --- F(12)
C --- I(18)
Écrire à nouveau les spécifications des fonctions taille, hauteur et parcours (parcours infixe).
defest_vide(n:Noeud)->bool:"""
Teste si le noeud passé en argument est vide ou pas.
"""
Réponse
defest_vide(n:Noeud)->bool:"""
Teste si un arbre est vide.
"""returnn==None
defhauteur(a:Noeud)->int:"""
Retourne la hauteur de l'arbre binaire de recherche a.
"""
Réponse
defhauteur(n:Noeud)->int:"""
Retourne la profondeur de l'arbre.
"""ifest_vide(n):# Cas de base : si le nœud est vide, il n'est pas dans l'arbre.return-1else:# Recherche récursive dans les sous-arbres gauche et droit.arbre_gauche=hauteur(n.gauche)arbre_droit=hauteur(n.droit)# Détermine la profondeurreturn1+max(arbre_gauche,arbre_droit)
deftaille(a:Noeud)->int:"""
Retourne le nombre de noeuds dans l'arbre binaire de recherche.
"""
Réponse
deftaille(n:Noeud)->int:"""
Retourne le nombre de noeud dans l'arbre.
"""ifest_vide(n):# Cas de base : un arbre vide ne contient aucun noeud.return0else:# Recherche récursive dans les sous-arbres gauche et droit.taille_gauche=taille(n.gauche)taille_droit=taille(n.droit)# Calcul de la taillereturn1+taille_gauche+taille_droit
defparcours(n:Noeud)->None:"""
Parcours infixe de l'arbre
"""
Réponse
defparcours_inf(n:Noeud)->str:"""Parcours en profondeur infixe d'un arbre binaire."""ifest_vide(n):# Cas de base : On atteint un noeud videreturn""else:# Appel récursif à gauche, valeur du nœud, appel récursif à droitechaine=parcours_inf(n.gauche)chaine+=str(n.valeur)chaine+=parcours_inf(n.droit)returnchaine
Vérifier que la fonction parcours affiche les valeurs dans l’ordre croissant.
Avertissement
Rappel
On peut voir le parcours infixe comme la projection de l’arbre sur une droite.
Recherche dans un ABR
Écrire le code de la fonction appartient dont la spécification est
defappartient(a:Noeud,x:int)->bool:"""
Détermine si la valeur x apparaît dans l'arbre a.
"""
Réponse
defappartient(a:Noeud,x:int)->bool:"""
Détermine si la valeur x apparaît dans l'abr a.
"""ifest_vide(a):# Cas de base : on parvient à un noeud vide,# la valeur n'est pas présentereturnFalseelifa.valeur==x:# Cas de base : on parvient au noeud recherchéreturnTrue# Appels récursifselifa.valeur>x:returnappartient(a.gauche,x)else:returnappartient(a.droit,x)
Quelle est la complexité de cette recherche ?
Réponse
La complexité du pire cas de la fonction appartient dépend de la hauteur de l’arbre binaire de recherche (ABR).
Dans le pire des cas, l’arbre peut être déséquilibré au point de ressembler à une liste chaînée. Dans un tel scénario, la complexité de la recherche est linéaire par rapport au nombre total de nœuds dans l’arbre.
Complexité : O(n).
Si on écarte ce cas extrême, l’arbre binaire de recherche (ABR) est plus ou moins équilibré et la hauteur est de l’ordre du logrithme du nombre de nœuds.
Complexité : O(logn).
Ajout d’une valeur dans un ABR
Envisager un ABR et, à la main, ajouter un élément.
Quel peut-être le code de la fonction ajoute dont la spécification est
defajoute(a:Noeud,x:int)->None:"""
Ajoute x à l'arbre a (en place).
HYPOTHÈSE : a n'est pas l'arbre vide.
"""
Quelle est la complexité de cette fonction ?
Pour résoudre le problème de l’ajout d’une valeur à un arbre initialement vide et/ou pour ne pas modifier un arbre déjà constitué, il est possible de programmer la fonction ajoute_copie dont la spécification est
defajoute_copie(n:Noeud,x:int)->Noeud:"""
Ajoute la valeur x à l'ABR n. Un nouvel arbre est créé.
"""
Écrire le code de cette fonction.
Utilisation d’un arbre binaire de recherche
Créer la fonction plus_petit_element dont la spécification est
defplus_petit_element(a:Noeud)->int:"""
Retourne le plus petit élément de l'arbre binaire de recherche a.
Lève une exception si l'arbre est vide.
"""
Créer la fonction plus_grand_element dont la spécification est
defplus_grand_element(a:Noeud)->int:"""
Retourne le plus grand élément de l'arbre binaire de recherche a.
Lève une exception si l'arbre est vide.
"""
Créer la fonction est_abr dont la spécification est
defest_abr(a:Noeud)->bool:"""
Détermine si l'arbre a est un arbre binaire de recherche.
"""
Un arbre binaire de recherche est un arbre binaire contenant des valeurs ordonnées, tel que tout nœud contient une valeur plus grande (respectivement plus grande ou égale) que les valeurs de tous les nœuds situés dans son sous-arbre gauche. Cette organisation permet de procéder par dichotomie, en n’ayant à considérer qu’un seul sous-arbre pendant une opération.
Lorsqu’ils sont équilibrés, les arbres binaires de recherche constituent une méthode très efficace pour stocker et rechercher de l’information.
Physique, Chimie et Informatique > Terminales Spé. NSI > Structures hiérarchiques : les arbres
Cette séance a pour objet l’étude d’une méthode de compression de données inventée par David Albert Huffman en 1952. Cette méthode permet de réduire la longueur du codage d’un alphabet et repose sur la création d’un arbre binaire.
Différents types de codages
Info
On appelle alphabet l’ensemble des symboles (caractères) composant la donnée de départ à compresser.
Dans la suite, nous utiliserons un alphabet composé seulement des 8 lettres A, B, C, D, E, F, G et H.
On cherche à coder chaque lettre de cet alphabet par une séquence de chiffres binaires.
Combien de bits sont nécessaires pour coder chacune des 8 lettres de l’alphabet ?
Réponse
Il faut coder 8 caractères, on a donc besoin de 3 bits, puisque 23=8.
Quelle est la longueur en octets d’un message de 1 000 caractères construit sur cet alphabet ?
Réponse
1000×3=3000 bits sont nécessaires.
83000=375 octets sont nécessaires.
Proposer un code de taille fixe pour chaque caractère de l’alphabet de 8 lettres.
Réponse
A : 000 ; B : 001 ; C : 010 ; D : 011 ; E : 100 ; F : 101 ; G : 110 et H : 111.
On considère maintenant le codage suivant, la longueur du code de chaque caractère étant variable.
Lettre
A
B
C
D
E
F
G
H
Code
10
001
000
1100
01
1101
1110
1111
Info
Ce type de code est dit préfixe, ce qui signifie qu’aucun code n’est le préfixe d’un autre (le code de A est 10 et aucun autre code ne commence par 10, le code de B est 001 et aucun autre code ne commence par 001). Cette propriété permet de séparer les caractères de manière non ambiguë.
En utilisant la table précédente, donner le code du message : CACHE.
Réponse
CACHE : 00010000111101
Quel est le message correspondant au code 001101100111001.
Réponse
001101100111001 : BADGE
Dans un texte, chacun des 8 caractères a un nombre d’apparitions différent. Cela est résumé dans le tableau suivant, construit à partir d’un texte de 1 000 caractères.
Lettre
A
B
C
D
E
F
G
H
Nombre
240
140
160
51
280
49
45
35
En utilisant le code de taille fixe proposé à la question 3., quelle est la longueur en bits du message contenant les 1 000 caractères énumérés dans le tableau précédent ?
Réponse
Si on utilise 3 bits pour chaque caractère, il faut 1000×3=3000 bits pour coder le message.
En utilisant le code de la question 4., quelle est la longueur du même message en bits ?
Réponse
N=f(A)⋅l(A)+f(B)⋅l(B)+f(C)⋅l(C)+f(D)⋅l(D)+f(E)⋅l(E)+f(F)⋅l(F)+f(G)⋅l(G)+f(H)⋅l(H) où f(xi) est la fréquence du caractère xi et l(xi) la longueur (en bits) du codage du caractère xi.
A.N.N=240×2+140×3+160×3+51×4+280×2+49×4+45×4+35×4=2660
Info
Ce type de codage réserve le codage le plus court aux caractères les plus fréquents.
Codage de Huffman
L’objectif du codage de Huffman est de trouver le codage proposé à la question 4.
Info
Le codage de Huffman minimise la taille en nombre de bits du message codé en se basant sur le nombre d’apparition de chaque caractère (un caractère qui apparaît souvent aura un code plutôt court).
Pour déterminer le code optimal, on considère 8 arbres, chacun réduit à une racine, contenant le symbole et son nombre d’apparitions.
On fusionne ensuite les deux arbres contenant les plus petits nombres d’apparitions (valeur inscrite sur la racine), et on affecte à ce nouvel arbre la somme des nombres d’apparitions de ses deux sous-arbres. Lors de la fusion des deux arbres, le choix de mettre l’un ou l’autre à gauche n’a pas d’importance. Nous choisissons ici de mettre le plus fréquent à gauche (s’il y a un cas d’égalité, nous faisons un choix arbitraire).
On recommence jusqu’à ce qu’il n’y ait plus qu’un seul arbre.
Combien d’étapes (combien de fusions d’arbres) sont nécessaires pour que cet algorithme se termine ?
En suivant l’algorithme précédent, construire l’arbre de Huffman.
Info
Le code à affecter à chaque lettre est déterminé par sa position dans l’arbre. Précisément, le code d’un symbole de l’alphabet décrit le chemin de la racine à la feuille qui le contient : un 0 indique qu’on descend par le fils gauche et un 1 indique qu’on descend par le fils droit.
graph TD
A(" ") --> B(" ")
B --> X("X")
B --> Y("Y")
A --> Z("Z")
Dans le cas de l’arbre ci-dessus le code de X est 00 (deux fois à gauche), le code de Y est 01, et celui de Z est 1.
Sur chaque arête de l’arbre construit à la question 10., inscrire 0 ou 1 selon que l’arête joint un fils gauche ou un fils droit.
Quel est le code de F ?
Le code suivant permet, à partir d’un fichier nommé texte.txt, de construire l’arbre de Huffman puis un dictionnaire qui associe à chaque caractère du fichier d’entrée son code sous forme d’une séquence de bits (liste de 0 et de 1).
Implémentation en Python de l’algorithme
Écrire le code (et la spécification !) de la classe Noeud, nœud d’un arbre binaire.
Par rapport à l’implémentation réalisée lors des TP précédenrs, ajouter le champ lettre initialisé à la chaîne de caractères vide et la méthode suivante :
def__lt__(self,n:Noeud):"""
Comparaison de deux noeuds = comparaison des valeurs
"""returnself.valeur<n.valeur
Réponse
classNoeud:def__init__(self:Noeud,val:int,let:str="")->None:"""
Initialisation de l'objet.
"""self.valeur=valself.lettre=letself.gauche=Noneself.droit=Nonedef__lt__(self:Noeud,n:Noeud)->bool:"""
Comparaison de deux noeuds = comparaison des valeurs
"""returnself.valeur<n.valeur
Écrire les codes (et la spécification !) des fonctions est_vide, est_feuille, parcours_prefixe qui, respectivement teste si un nœud est vide, teste si un nœud est une feuille et finalement affiche l’arbre.
Réponse
defest_vide(n:Noeud)->bool:"""
Détermine si l'arbre est vide.
"""returnnisNonedefest_feuille(n:Noeud)->bool:"""
Détermine si le noeud est une feuille.
"""return(n.gaucheisNone)and(n.droitisNone)defparcours(n:Noeud)->str:"""
Parcours en profondeur préfixe de l'arbre.
"""ifnisNone:return""else:chaine=str(n.valeur)chaine+=parcours(n.gauche)chaine+=parcours(n.droit)returnchaine
15. Écrire le code de la fonction creation_table_frequences dont la spécification est
defcreation_table_frequences(message:str)->dict[str,int]:"""
Établit la table des fréquences des caractères dans message.
"""
defcreation_table_frequences(message:str)->dict[str,int]:"""
Établit la table des fréquences des caractères dans message.
"""dic={}forcarinmessage:ifcarindic.keys():dic[car]+=1else:dic[car]=1returndic
Lire le document sur les files de priorité.
Écrire le code de la fonction construction_arbre_huffman dont la spécification est
defconstruction_arbre_huffman(dic_frequences:dict[str,int])->Noeud:"""
Construction de l'arbre de Huffman.
"""
et l’algorithme (cf. Cormen, Algorithmes)
Avertissement
Cet algorithme est un exemple d’algorithme glouton dans lequel on prend la décision qui semble la meilleure à un instant donné.
Réponse
defconstruction_arbre_huffman(dic_frequences:dict[str,int])->Noeud:"""
Construction de l'arbre de Huffman.
"""file=[]# Création de tous les noeuds et insertion dans la fileforlettre,frequenceindic_frequences.items():noeud=Noeud(frequence,lettre)heappush(file,noeud)# Construction de l'arbreforiinrange(len(dic_frequences)-1):noeud_droit=heappop(file)noeud_gauche=heappop(file)# Nouvel arbrenouvelle_valeur=noeud_droit.valeur+noeud_gauche.valeurnoeud=Noeud(nouvelle_valeur)noeud.droit=noeud_droitnoeud.gauche=noeud_gauche# Intégration à la fileheappush(file,noeud)# Retour de l'arbrereturnheappop(file)
Écrire une fonction nommée codes_huffman_parcours dont la spécification est :
defcodes_huffman_parcours(a:Noeud,dic:dict[str,str],code:str)->None:"""
Parcours de l'arbre et construction des codes et du dictionnaire passé en argument.
Les lettres constituent les clés et les codes les valeurs.
Algorithme récursif.
"""
Réponse
defcodes_huffman_parcours(a:Noeud,dic:dict[str,str],code:str)->None:"""
Parcours de l'arbre et construction des codes et du dictionnaire passé en argument.
Les lettres constituent les clés et les codes les valeurs.
Algorithme récursif.
"""ifest_feuille(a):# Cas de base : on modifie le dictionnairedic[a.lettre]=codereturnNoneelse:codes_huffman_parcours(a.gauche,dic,code+"0")codes_huffman_parcours(a.droit,dic,code+"1")
Écrire une fonction nommée encodage dont la spécification est :
defencodage(message:str,codes:dict[str,str])->str:"""
Retourne la chaîne de bits produite par le codage de Huffman pour la chaîne message.
"""
Réponse
defencodage(message:str,codes:dict[str,str])->str:"""
Retourne la chaîne de bits produite par le codage de Huffman pour la chaîne message.
"""message_code=""forcarinmessage:message_code+=codes[car]returnmessage_code
Avertissement
Il est impératif de savoir écrire le code de cette fonction !
Écrire une fonction nommée decodage dont la spécification est :
defdecodage(message_compresse:str,codes:dict[str,str])->str:"""
Retourne le message non compressé à partir du codage de Huffman.
"""
Réponse
defdecodage(message_compresse:str,codes:dict[str,str])->str:"""
Retourne le message non compressé à partir du codage de Huffman.
Étape intermédiaire : passer d'un dictionnaire 'A': '001' à
'001' : 'A'
"""# Inversion clés - valeursdic_inverse={}forcle,valeurincodes.items():dic_inverse[valeur]=cle# Décodageresultat=""code=""forcarinmessage_compresse:code+=carifcodeindic_inverse.keys():resultat+=dic_inverse[code]code=""returnresultat
Avertissement
Il est impératif de savoir écrire le code de cette fonction !
Appels de toutes les fonctions dans la partie principale du programme
if__name__=="__main__":arb=Noeud(12,"A")arb.gauche=Noeud(23,"B")arb.droit=Noeud(48,"C")arb.gauche.gauche=Noeud(49,"K")arb.droit.gauche=Noeud(9,"H")arb.droit.droit=Noeud(78,"X")print(parcours(arb))print(arb<Noeud(67,"E"))assertcreation_table_frequences("ABRACADABRA")=={"A":5,"B":2,"R":2,"C":1,"D":1,}message="ABRACADABRA"# nom_fichier = "livre.txt"# with open(nom_fichier, 'r') as f:# message = f.read()table_frequences=creation_table_frequences(message)arbre=construction_arbre_huffman(table_frequences)print(parcours(arbre))dic_codes={}codes_huffman_parcours(arbre,dic_codes,"")print(dic_codes)message_code=encodage(message,dic_codes)print(message_code)message_decode=decodage(message_code,dic_codes)print(message_decode)
Physique, Chimie et Informatique > Terminales Spé. NSI
Au programme de la partie « Structures de données »
Contenus
Capacités attendues
Commentaires
Graphes : structures relationnelles. Sommets, arcs, arêtes, graphes orientés ou non orientés.
- Modéliser des situations sous forme de graphes. - Écrire les implémentations correspondantes d’un graphe : matrice d’adjacence, liste de successeurs/de prédécesseurs. - Passer d’une représentation à une autre.
On s’appuie sur des exemples comme le réseau routier, le réseau électrique, internet, les réseaux sociaux. - Le choix de la représentation dépend du traitement qu’on veut mettre en place : on fait le lien avec la rubrique « algorithmique ».
Au programme de la partie « Algorithmique »
Contenus
Capacités attendues
Commentaires
Algorithmes sur les graphes.
- Parcourir un graphe en profondeur d’abord, en largeur d’abord. - Repérer la présence d’un cycle dans un graphe. - Chercher un chemin dans un graphe.
- Le parcours d’un labyrinthe et le routage dans internet sont des exemples d’algorithme sur les graphes. - L’exemple des graphes permet d’illustrer l’utilisation des classes en programmation.
Plusieurs modes de représentation peuvent être implémentés pour stocker des graphes : matrices d’adjacence (ou sommet-sommet), listes des voisins, des successeurs ou des prédécesseurs. Lors de cette séance nous allons écrire les classes réalisant ces implémentations.
Structure de graphe basée sur une liste d’adjacence
Écrire le code de la méthode __init__ de la classe Sommet dont la spécification est :
def__init__(self:Sommet,val:str)->None:"""
Initialisation d'un sommet.
"""
Remarque : La classe Sommet possède deux attributs :
val représente la valeur du sommet ou son étiquette. Cet attribut est de type chaîne de caractères (str) ;
adj représente la liste des sommets adjacents au sommet, instance de la classe. Cet attribut référence une liste de sommets ; lors de l’initialisation d’un sommet il doit référencer une liste vide.
Réponse
classSommet:"""
Représentation d'un sommet.
"""def__init__(self:Sommet,val:str)->None:"""
Initialisation du sommet.
"""self.val=valself.adj=[]# Sommets adjacents
Ajouter au code de la classe Sommet la re-définition de la méthode __repr__ donnée ci-dessous :
Écrire le code de la méthode __init__ de la classe Graphe dont la spécification est :
def__init__(self:Graphe,valeurs:str="")->None:"""
La liste des sommets peut être passée dans une
chaîne de caractères. Chaque sommet doit alors être
séparé du précédent par une virgule.
Hypothèse : chaque sommet n'est présent qu'une seule
fois dans valeurs.
"""
Remarque : La classe Sommet possède un seul attribut, sommets. Ce dernier référence une liste d’objets de type Sommet. Cette liste est initialement :
Soit vide,
Soit constituée des sommets passés en argument lors de l’initialisation d’un objet de type Graphe.
Réponse
classGraphe:"""
Représentation du graphe.
"""def__init__(self:Graphe,valeurs:str="")->None:"""
La liste des sommets peut être passée dans une
chaîne de caractères. Chaque sommet doit être
séparé du précédent par une virgule.
Hypothèse : chaque sommet n'est présent qu'une seule
fois dans valeurs.
"""self.sommets=[]# liste des sommetsifvaleurs!="":forsommetinvaleurs.split(","):self.sommets.append(Sommet(sommet))
Ajouter au code de la classe Graphe la re-définition de la méthode __repr__ donnée ci-dessous :
def__repr__(self:Graphe)->str:"""
Représentation du graphe sous forme d'une chaîne de
caractères.
"""rep="{"fori,sommetinenumerate(self.sommets):rep+=repr(sommet)ifi<len(self.sommets)-1:# Ajout de la virgule sauf dernier tourrep+=", "rep+="}"returnrep
Cette méthode permet de représenter un graphe sous la forme d’une chaîne de caractères.
Tester la définition de la classe Graphe à l’aide du code suivant, sous les lignes de code de la question 3 :
g1=Graphe("a,b,c,d")print(g1)
Écrire le code de la méthode existe_sommet dont la spécification est :
defexiste_sommet(self:Graphe,s:str)->bool:"""
Vérifie que le sommet s existe bien dans le graphe.
"""
Réponse
defexiste_sommet(self:Graphe,s:str)->bool:"""
Vérifie que le sommet s existe bien dans le graphe.
"""sommet_present=False# Sommet pas présentforsommetinself.sommets:# sommet référence un objetifsommet.val==s:sommet_present=Truereturnsommet_present
Tester le code précédent en ajoutant les instructions suivantes, à la fin du fichier :
print(f"Sommet g présent dans le graphe : {g1.existe_sommet('g')}")print(f"Sommet a présent dans le graphe : {g1.existe_sommet('a')}")
Écrire le code de la méthode ajout_sommet dont la spécification est :
defajout_sommet(self:Graphe,val:str)->None:"""
Ajout du sommet de valeur val au graphe.
Si le sommet est déjà présent dans le graphe une exception
est levée.
"""
Réponse
defajout_sommet(self:Graphe,val:str)->None:"""
Ajout du sommet de valeur val.
Si le sommet est déjà présent dans le graphe une exception
est levée.
"""ifself.existe_sommet(val):raiseException("Sommet déjà présent dans le graphe !")self.sommets.append(Sommet(val))
Tester le code précédent en ajoutant les instructions suivantes, à la fin du fichier :
g1.ajout_sommet("e")print(g1)
Écrire le code de la méthode recuperation_sommet dont la spécification est :
defrecuperation_sommet(self:Graphe,s:str)->Sommet:"""
Récupère l'objet de type sommet, présent dans la liste
sommets, dont la valeur/étiquette est s.
Lève une exception si le sommet n'existe pas.
"""
Remarque : Cette méthode simplifie l’écriture des méthodes suivantes.
Réponse
defrecuperation_sommet(self:Graphe,s:str)->Sommet:"""
Récupère le sommet de valeur s.
Lève une exception si le sommet n'existe pas.
"""ifnotself.existe_sommet(s):raiseException(f"Le sommet {s} n'existe pas.")forobjet_sommetinself.sommets:ifobjet_sommet.val==s:returnobjet_sommet
Écrire le code de la fonction existe_arete dont la spécification est :
defexiste_arête(self,s1:str,s2:str)->bool:"""
Détermine si l'arête {s1, s2} existe dans le graphe.
Ne vérifie pas l'existence de l'arête {s2, s1}.
Lève une exception si l'un des sommets n'existe pas.
"""
Réponse
defexiste_arête(self,s1:str,s2:str)->bool:"""
Détermine si l'arête {s1, s2} existe dans le graphe.
Ne vérifie pas l'existence de l'arête {s2, s1}.
Lève une exception si l'un des sommets n'existe pas.
"""objet_sommet_depart=self.recuperation_sommet(s1)objet_sommet_arrivee=self.recuperation_sommet(s2)returnobjet_sommet_arriveeinobjet_sommet_depart.adj
Écrire le code de la fonction ajout_arete dont la spécification est :
defajout_arete(self:Graphe,s1:str,s2:str)->None:"""
Ajoute l'arête (ou l'arc) {s1, s2} au graphe.
Si les sommets n'existent pas, on lève une exception.
Si l'arête existe déjà, on lève une exception.
Ne crée pas l'arête {s2, s1}.
"""
Réponse
defajout_arete(self:Graphe,s1:str,s2:str)->None:"""
Ajoute l'arête (ou l'arc) {s1, s2} au graphe.
Si les sommets n'existent pas, on lève une exception.
Si l'arête existe déjà, on lève une exception.
Ne crée pas l'arête {s2, s1}.
"""# L'arête existe-t-elle déjà ?ifself.existe_arête(s1,s2):raiseException("Arête existe déjà !")# Récupération des sommetssommet_depart=self.recuperation_sommet(s1)sommet_destination=self.recuperation_sommet(s2)# Ajout du sommet s2 à la liste des adjacents de s1sommet_depart.adj.append(sommet_destination)
Tester le code précédent en ajoutant les instructions suivantes, à la fin du fichier :
Écrire le code de la fonction est_non_oriente dont la spécification est :
defest_non_oriente(self:Graphe)->bool:"""
Détermine si le graphe est non orienté.
"""
Réponse
defest_non_oriente(self:Graphe)->bool:"""
Détermine si le graphe est non orienté.
"""forsommet1inself.sommets:forsommet2insommet1.adj:ifnotself.existe_arête(sommet2.val,sommet1.val):returnFalsereturnTrue
Tester le code précédent en ajoutant les instructions suivantes, à la fin du fichier :
print(f"Le graphe est non orienté : {g1.est_non_oriente()}")g1.ajout_arete("e","a")print(f"Le graphe est non orienté : {g1.est_non_oriente()}")
On souhaite maintenant écrire le code de la fonction construction_matrice dont la spécification est :
defconstruction_matrice(self:Graphe)->list[list[int]]:"""
Construction de la matrice sommet - sommet du graphe.
"""
Compléter le code suivant :
defconstruction_matrice(self:Graphe)->list[list[int]]:"""
Construction de la matrice sommet - sommet du graphe.
"""val_sommets_ordonnees=sorted([sommet.valforsommetinself.sommets])matrice=.....# Initialisation de la matricefornom_sommetinval_sommets_ordonnees:# Récupération de l'objet de type sommet associé au nomsommet=.....# Récupération des noms des sommets adjacentsnom_sommets_adjacents=[sommet_adj.valforsommet_adjinsommet.adj]ligne_matrice=.....# Initialisation de la ligne de la matriceforiinrange(len(val_sommets_ordonnees)):ifval_sommets_ordonnees[i]innom_sommets_adjacents:......else:...........# Ajout de la ligne à la matricereturnmatrice
Réponse
defconstruction_matrice(self:Graphe)->list[list[int]]:"""
Construction de la matrice sommet - sommet du graphe.
"""val_sommets_ordonnees=sorted([sommet.valforsommetinself.sommets])matrice=[]# Initialisation de la matricefornom_sommetinval_sommets_ordonnees:# Récupération de l'objet de type sommet associé au nomsommet=self.recuperation_sommet(nom_sommet)# Récupération des noms des sommets adjacentsnom_sommets_adjacents=[sommet_adj.valforsommet_adjinsommet.adj]ligne_matrice=[]# Initialisation de la ligne de la matriceforiinrange(len(val_sommets_ordonnees)):ifval_sommets_ordonnees[i]innom_sommets_adjacents:ligne_matrice.append(1)else:ligne_matrice.append(0)matrice.append(ligne_matrice)# Ajout de la ligne à la matricereturnmatrice
Tester le code précédent en ajoutant les instructions suivantes, à la fin du fichier :
print(f"Matrice : {g1.construction_matrice()}")
Écrire le code de la méthode representation_matrice dont la spécification est :
defrepresentation_matrice(self:Graphe)->str:"""
Retourne une chaîne de caractères qui permet un
affichage classique de la matrice (lignes x colonnes).
"""
Tester le code.
Réponse
defrepresentation_matrice(self:Graphe)->str:"""
Retourne une chaîne de caractères qui permet un
affichage classique de la matrice (lignes x colonnes).
"""matrice=self.construction_matrice()rep=""nbre=len(matrice)# nombre de lignes et de colonnesforiinrange(nbre):forjinrange(nbre):rep+=str(matrice[i][j])+"\t"rep+="\n"returnrep
Extensions possibles
Il est possible de compléter la classe en définissant les méthodes suivantes :
taille, de spécification :
deftaille(self:Graphe)->int:"""
Retourne le nombre de sommets dans le graphe.
"""
rend_non_oriente, de spécification :
defrend_non_oriente(self:Graphe)->None:"""
Assure que pour toute arête {s1, s2} il existe une
arête {s2, s1}. Si ce n'est pas le cas, cette arête
est créée.
"""
suppression_arete, de spécification :
defsuppression_arete(self:Graphe,s1:str,s2:str)->None:"""
Supprime l'arête {s1, s2} si elle existe, lève une exception
dans le cas contraire.
"""
suppression_sommet, de spécification :
defsuppression_sommet(self:Graphe,s:str)->None:"""
Supprime le sommet s s'il existe, lève une exception dans
le cas contraire.
S'assure avant la suppression du sommet que toute arrête
dans laquelle il intervient est supprimée.
"""
Physique, Chimie et Informatique > Terminales Spé. NSI > Les graphes
Plusieurs modes de représentation peuvent être implémentés pour stocker des graphes : matrices d’adjacence (ou sommet-sommet), listes des voisins, des successeurs ou des prédécesseurs. Lors de cette séance nous allons écrire les classes réalisant ces implémentations.
Matrice sommet-sommet
Écrire le code de la classe GrapheM qui implémente une matrice sommet-sommet.
La spécification du constructeur de la classe est :
def__init__(self:GrapheM,mat:List[List[int]])->None:"""
Constructeur de la classe.
"""
Remarque : cette classe possède l’attribut mat qui référence la matrice d’adjacence.
Solution
classGrapheM:"""
Implémentation de la représentation
matricielle d'un graphe.
"""def__init__(self:GrapheM,mat:List[List[int]])->None:"""
Constructeur de la classe.
"""self.mat=mat
Ajouter à la classe GrapheM une redéfinition de la méthode spéciale __str__ de façon à ce qu’un appel à la fonction print avec comme argument un objet représentant un graphe donne un affichage qui rappelle celui d’une matrice (lignes et colonnes).
Solution
def__str__(self:GrapheM)->str:rep=""foriinrange(len(self.mat)):rep=rep+str(self.mat[i][0])# Premier élement de la ligneforjinrange(1,len(self.mat[0])):rep=rep+" "+str(self.mat[i][j])rep=rep+"\n"returnrep
Écrire le code d’une fonction main qui permet de tester l’implémentation de la classe et la représentation du graphe à l’écran.
Choisir comme matrices tests
$$
M_1 =
\begin{pmatrix}
1 & 1 & 0 \cr
0 & 1 & 1 \cr
0 & 0 & 1 \cr
\end{pmatrix}
\text{ et }
M_2 =
\begin{pmatrix}
0 & 1 & 1 & 0 \cr
1 & 0 & 1 & 1 \cr
1 & 1 & 0 & 1 \cr
0 & 1 & 1 & 0 \cr
\end{pmatrix}
$$
Remarque
Les sommets du graphe sont représentés par des entiers naturels.
defest_lie(self:GrapheM,i:int,j:int)->bool:"""
Retourne True s'il existe une relation (arête ou arc)
entre les sommets i et j, False sinon.
"""returnself.mat[i][j]!=0
Quelle est la particularité de la matrice sommet-sommet d’un graphe non orienté ?
Solution
La matrice est symétrique par rapport à la diagonale.
Écrire le code de la fonction est_non_oriente dont la spécification est
defest_non_oriente(self:GrapheM)->bool:"""
Retourne True si le graphe est non orienté
(si la matrice est symétrique) et False si le
graphe est orienté.
"""
defest_non_oriente(self:GrapheM)->bool:"""
Retourne True si le graphe est non orienté
(si la matrice est symétrique) et False si le
graphe est orienté.
"""n=len(self.mat)foriinrange(n):forjinrange(i+1,n):ifself.mat[i][j]!=self.mat[j][i]:returnFalsereturnTrue
Liste d’adjacence
Dans cette partie, on implémente la liste d’adjacence (liste des voisins) d’un graphe non orienté ou la liste des successeurs d’un graphe orienté.
Écrire le code de la classe GrapheL qui implémente une liste des voisins.
La spécification du constructeur de la classe est :
def__init__(self:GrapheL,lst:List[List[int]])->None:"""
Constructeur de la classe.
"""
Remarque : cette classe possède l’attribut lst qui référence une liste d’adjacence.
Solution
classGrapheL:"""
Implémentation de la liste des voisins d'un graphe non orienté.
"""def__init__(self,lst:List[List[int]])->None:self.lst=lst
Ajouter à la classe GrapheL une redéfinition de la méthode spéciale __str__ de façon à ce qu’un appel à la fonction print avec comme argument un objet représentant un graphe donne un affichage qui rappelle celui d’une liste de listes.
Solution
def__str__(self:GrapheLV)->str:"""
Représentation sous forme d'une chaîne de caractères de l'objet.
"""rep=""foriinrange(len(self.lst)):rep+="{} :".format(i)forjinrange(len(self.lst[i])):rep+=" "+str((self.lst[i][j]))rep+="\n"returnrep
Tester le code précédent à l’aide des listes des voisins/successeurs des graphes dont les matrices sommet-sommet sont données dans la première section.
defest_lie(self:GrapheL,i:int,j:int)->bool:"""
Retourne True s'il existe une relation (arête ou arc) entre les sommets i et j, False sinon.
"""returnjinself.lst[i]
Écrire le code de la fonction est_non_oriente dont la spécification est
defest_non_oriente(self:GrapheL)->bool:"""
Retourne True si le graphe est non orienté, False sinon.
"""
defest_non_oriente(self:GrapheL)->bool:"""
Retourne True si le graphe est non orienté (si la matrice est symétrique) et False si le graphe est orienté.
"""foriinrange(len(self.lst)):forjinrange(len(self.lst[i])):s=self.lst[i][j]# sommetifinotinself.lst[s]:returnFalsereturnTrue
Passage d’une représentation à l’autre
Ajouter à la classe GrapheL la méthode lst_to_mat dont la spécification est :
deflst_to_mat(self:GrapheL)->GrapheM:"""
Génère la matrice sommet-sommet à partir de la liste des voisins/successeurs.
"""
deflst_to_mat(self:GrapheL)->GrapheM:"""
Génère la matrice sommet-sommet à partir de la liste des
voisins/successeurs.
"""mat=[]n=len(self.lst)foriinrange(n):ligne=[]forjinrange(n):ifjinself.lst[i]:ligne.append(1)else:ligne.append(0)mat.append(ligne)returnGrapheM(mat)
Ajouter à la classe GrapheM la méthode mat_to_lst dont la spécification est :
defmat_to_lst(self:GrapheM)->GrapheL:"""
Génère la liste des voisins/successeurs à partir de la matrice sommet-sommet.
"""
defmat_to_lst(self:GrapheM)->GrapheL:"""
Génère la liste des voisins/successeurs à partir de la matrice sommet-sommet.
"""liste=[]# liste des listes pour tous les sommetsforiinrange(len(self.mat)):rel=[]# relation pour le sommet iforjinrange(len(self.mat)):ifself.mat[i][j]!=0:rel.append(j)liste.append(rel)returnGrapheL(liste)
Parcours en profondeur : écriture du code en Python
Écriture d’une classe Graphe
L’objectif de cette partie est l’écriture du code modélisant un graphe orienté. La représentation choisie est celle d’un dictionnaire de successeurs (en cours et dans le document 15,2 on a étudié les représentations par des matrice et liste de successeurs).
La représentation par un dictionnaire de successeurs présente de nombreux avantages. Par exemple,
les sommets peuvent être des entiers ou des chaînes de caractères quelconques ;
La complexité de la liste des successeurs est directement proportionnelle au nombre de successeurs pour un sommet donné. L’occupation mémoire est donc faible si les sommets possèdent peu de successeurs. Remarque : dans le cas d’une matrice d’adjacence, la taille est fixe et comporte N2 éléments si le nombre de sommets est égal à N.
Remarque
Contrairement à ce qui a été fait dans le document 15,2, la classe qui va être implémentée ici permettra d’initialiser un graphe vide, puis de le constituer progressivement.
Initialiser la classe Graphe. La méthode __init__ a pour seule fonction l’affectation d’un dictionnaire vide à l’attribut succ.
Solution
Créer la méthode ajouter_sommet dont la spécification est :
defajouter_sommet(self:Graphe,s:Union[int,str])->None:"""
Ajoute le sommet s (entier ou chaîne de caractères) au graphe
s'il n'est pas déjà présent.
s est une clé du dictionnaire succ. Sa valeur associée par défaut
est une liste vide.
"""
Solution
defajouter_sommet(self:Graphe,s:Union[int,str])->None:"""
Ajoute le sommet s (entier ou chaîne de caractères) au graphe
s'il n'est pas déjà présent.
s est une clé du dictionnaire succ. Sa valeur associée par défaut
est une liste vide.
"""ifsnotinself.succ.keys():self.succ[s]=[]
Créer la méthode ajouter_arc dont la spécification est :
defajouter_arc(self:Graphe,s1:Union[int,str],s2:Union[int,str])->None:"""
Ajoute s2 à la liste des successeurs de s1. Si s1 et s2 n'existent pas, ils sont
créés en utilisant la méthode ajouter_sommet.
"""
Solution
defajouter_arc(self:Graphe,s1:Union[int,str],s2:Union[int,str])->None:"""
Ajoute s2 à la liste des successeurs de s1. Si s1 et s2 n'existent pas, ils sont
créés en utilisant la méthode ajouter_sommet.
"""self.ajouter_sommet(self,s1)self.ajouter_sommet(self,s2)ifs2notinself.succ[s1]:self.succ[s1].append(s2)
Créer la méthode existe_arc dont la spécification est :
defexiste_arc(self:Graphe,s1:Union[int,str],s2:Union[int,str])->bool:"""
Retourne True si l'arc s1 -> s2 existe.
"""
Solution
defexiste_arc(self:Graphe,s1:Union[int,str],s2:Union[int,str])->bool:"""
Retourne True si l'arc s1 -> s2 existe.
"""returns2inself.succ[s1]
Créer la méthode liste_sommets dont la spécification est :
defliste_sommets(self:Graphe)->List[Union[int,str]]:"""
Retourne la liste des sommets du graphe.
"""
Solution
defliste_sommets(self:Graphe)->List[Union[int,str]]:"""
Retourne la liste des sommets du graphe.
"""returnlist(self.succ.keys())
Créer la méthode nbre_sommets dont la spécification est :
defnbre_sommets(self:Graphe)->int:"""
Retourne le nombre de sommets du graphe.
Utilise la méthode liste_sommets.
"""
Solution
defnbre_sommets(self:Graphe)->int:"""
Retourne le nombre de sommets du graphe.
Utilise la méthode liste_sommets.
"""returnlen(self.liste_sommets())
Créer la méthode liste_successeurs dont la spécification est :
defliste_successeurs(self:Graphe,s:Union[int,str])->List[Union[int,str]]:"""
Retourne la liste des successeurs du sommet s1.
"""
Solution
defliste_successeurs(self:Graphe,s:Union[int,str])->List[Union[int,str]]:"""
Retourne la liste des successeurs du sommet s1.
"""returnself.succ[s1]
Dans la partie principale du programme, entrer les instructions qui permettent de coder le graphe suivant :
graph TD
A(0) --> B(1)
B --> C(2)
A --> D(3)
D --> B
Reprendre la fonction parcours_profondeur proposée dans le document 15,3 et la transformer en méthode de la classe Graphe. Sa nouvelle spécification est alors :
defparcours_profondeur(self:Graphe,vus:List[Union[int,str]],s:Union[int,str])->None:"""
Parcours en profondeur depuis le sommet s.
Cette méthode prend en argument la liste des sommets déjà visités. Lors du premier appel
cette liste doit être vide.
Le parcours est accessible par lecture de la liste vus.
"""
Remarque.
Attention, j’ai modifié le nom d’une méthode : voisins s’appelle désormais liste_successeurs.
Solution
defparcours_profondeur(self:Graphe,vus:List[Union[int,str]],s:Union[int,str])->None:"""
Parcours en profondeur depuis le sommet s.
Cette méthode prend en argument la liste des sommets déjà visités. Lors du premier appel
cette liste doit être vide.
Le parcours est accessible par lecture de la liste vus.
"""ifsnotinvus:vus.append(s)forvinself.liste_successeurs(s):parcours_profondeur(self,vus,v)
Créer la méthode existe_chemin dont la spécification est :
defexiste_chemin(self:Graphe,s1:Union[int,str],s2:Union[int,str])->bool:"""
Retourne True s'il existe un chemin depuis s1 jusqu'à s2.
"""
Solution
defexiste_chemin(self:Graphe,s1:Union[int,str],s2:Union[int,str])->bool:"""
Retourne True s'il existe un chemin depuis s1 jusqu'à s2.
"""vus=[]self.parcours_profondeur(self,vus,s1)returns2invus
Vérifier le code précédent en utilisant le graphe proposé à la question 8.
Comment construire le chemin entre s1 et s2 ?\
Remplacer, dans la méthode parcours_profondeur la liste vus par un dictionnaire dont les clés sont les sommets visités et les valeurs associées sont les sommets prédécesseurs.
Attribuer la valeur None au sommet de départ.
Une fois le parcours en profondeur achevé, on peut vérifier qu’il existe un chemin en vérifiant si les deux sommets sont dans la liste des valeurs du dictionnaire.
Une fois le parcours en profondeur achevé, on peut donner le parcours en remontant le dictionnaire depuis le sommet d’arrivée.
Modifier le code des méthodes parcours_profondeur et existe_chemin à partir des consignes ci-dessus.
Créer la méthode chemin_entre dont la spécification est :
defchemin_entre(self:Graphe,s1:Union[int,str],s2:Union[int,str])->List[Union[int,str]]:"""
Vérifie que le chemin entre s1 et s2 existe puis le retourne sous la forme d'une liste.
"""
Parcours en profondeur basé sur la structure pile
Écrire le code de la classe Pile. En plus de la méthode __init__ cette classe doit posséder les méthodes est_vide, empiler et depiler.
Adapter le code de la fonction proposée dans le document document 15,3 afin de la transformer en méthode de la classe Graphe.
Physique, Chimie et Informatique > Terminales Spé. NSI > Les graphes
L’objectif de cette séance est de découvrir comment colorier chaque sommet
d’un graphe à l’aide d’un algorithme glouton.
Info
Colorier un graphe signifie associer une couleur à chacun de ses sommets
de façon à ce que deux sommets liés par une arête n’aient pas la même couleur
(deux sommets non adjacents peuvent avoir la même couleur).
Colorier un graphe avec un nombre minimal de couleurs est un problème
difficile mais l’utilisation d’un algorithme glouton permet de résoudre
le problème, au prix d’un nombre de couleurs qui n’est pas toujours minimal.
Remarques
Les couleurs seront représentées par des nombres entiers
débutant à la valeur 0.
La classe Graphe du document
Représentation d’un graphe sera utilisée.
Son code est reproduit ci-dessous.
Code
"""
Représentation d’un graphe à l'aide d'une liste d'adjacence.
"""from__future__importannotationsclassSommet:"""
Représentation d'un sommet.
"""def__init__(self:Sommet,val:str)->None:"""
Initialisation du sommet.
"""self.val=valself.adj=[]# Sommets adjacentsdefliste_adjacents(self:Sommet)->list[Sommet]:"""
Retourne la liste des sommets adjacents.
"""returnself.adjdefajoute_adjacent(self:Sommet,som:Sommet)->None:"""Ajoute un sommet adjacent"""self.adj.append(som)def__repr__(self:Sommet)->str:rep=str(self.val)+" : ["fori,sommetinenumerate(self.adj):rep+=str(sommet.val)ifi<len(self.adj)-1:rep+=", "rep+="]"returnrepclassGraphe:"""
Représentation du graphe.
"""def__init__(self:Graphe,valeurs:str="")->None:"""
La liste des sommets peut être passée dans une
chaîne de caractères. Chaque sommet doit être
séparé du précédent par une virgule.
Hypothèse : chaque sommet n'est présent qu'une seule
fois dans valeurs.
"""self.sommets=[]# liste des sommetsifvaleurs!="":forsommetinvaleurs.split(","):self.sommets.append(Sommet(sommet))defliste_sommets(self:Graphe)->list[Sommet]:"""
Retourne la liste des sommets du graphe.
"""returnself.sommetsdefajout_sommet(self:Graphe,val:str)->None:"""
Ajout du sommet de valeur val.
Si le sommet est déjà présent dans le graphe une exception
est levée.
"""ifself.existe_sommet(val):raiseException("Sommet déjà présent dans le graphe !")self.sommets.append(Sommet(val))# Ajout de l'objet de type Sommetdefexiste_sommet(self:Graphe,s:str)->bool:"""
Vérifie que le sommet s existe bien dans le graphe.
"""sommet_present=False# Sommet pas présentforsommetinself.sommets:# sommet référence un objetifsommet.val==s:sommet_present=Truebreakreturnsommet_presentdefrecuperation_sommet(self:Graphe,s:str)->Sommet:"""
Récupère le sommet de valeur s.
Lève une exception si le sommet n'existe pas.
"""ifnotself.existe_sommet(s):raiseException(f"Le sommet {s} n'existe pas.")forobjet_sommetinself.sommets:ifobjet_sommet.val==s:returnobjet_sommetdefajout_arete(self:Graphe,s1:str,s2:str)->None:"""
Ajoute l'arête (ou l'arc) {s1, s2} au graphe.
Si les sommets n'existent pas, on lève une exception.
Si l'arête existe déjà, on lève une exception.
Ne crée pas l'arête {s2, s1}.
"""# L'arête existe-t-elle déjà ?ifself.existe_arête(s1,s2):raiseException("Arête existe déjà !")# Récupération des sommetssommet_depart=self.recuperation_sommet(s1)sommet_destination=self.recuperation_sommet(s2)# Ajout du sommet s2 à la liste des adjacents de s1sommet_depart.ajoute_adjacent(sommet_destination)defexiste_arête(self,s1:str,s2:str)->bool:"""
Détermine si l'arête {s1, s2} existe dans le graphe.
Ne vérifie pas l'existence de l'arête {s2, s1}.
Lève une exception si l'un des sommets n'existe pas.
"""objet_sommet_depart=self.recuperation_sommet(s1)objet_sommet_arrivee=self.recuperation_sommet(s2)returnobjet_sommet_arriveeinobjet_sommet_depart.liste_adjacents()defest_non_oriente(self:Graphe)->bool:"""
Détermine si le graphe est non orienté.
"""forsommet1inself.sommets:forsommet2insommet1.liste_adjacents():ifnotself.existe_arête(sommet2.val,sommet1.val):returnFalsereturnTruedefconstruction_matrice(self:Graphe)->list[list[int]]:"""
Construction de la matrice sommet - sommet du graphe.
"""val_sommets_ordonnees=sorted([sommet.valforsommetinself.sommets])matrice=[]# Initialisation de la matricefornom_sommetinval_sommets_ordonnees:# Récupération de l'objet de type sommet associé au nomsommet=self.recuperation_sommet(nom_sommet)# Récupération des noms des sommets adjacentsnom_sommets_adjacents=[sommet_adj.valforsommet_adjinsommet.adj]ligne_matrice=[]# Initialisation de la ligne de la matriceforiinrange(len(val_sommets_ordonnees)):ifval_sommets_ordonnees[i]innom_sommets_adjacents:ligne_matrice.append(1)else:ligne_matrice.append(0)matrice.append(ligne_matrice)# Ajout de la ligne à la matricereturnmatricedefrepresentation_matrice(self:Graphe)->str:"""
Retourne une chaîne de caractères qui permet un
affichage classique de la matrice (lignes x colonnes).
"""matrice=self.construction_matrice()rep=""nbre=len(matrice)# nombre de lignes et de colonnesforiinrange(nbre):forjinrange(nbre):rep+=str(matrice[i][j])+"\t"rep+="\n"returnrepdef__repr__(self:Graphe)->str:"""
Représentation du graphe sous forme d'une chaîne de caractères.
"""rep="{"fori,sommetinenumerate(self.sommets):rep+=repr(sommet)# Ajout de la virgule sauf dernier tour de boucleifi<len(self.sommets)-1:rep+=", "rep+="}"returnrepdefsuppression_arete(self:Graphe,s1:str,s2:str)->None:"""
Supprime l'arête {s1, s2} si elle existe, lève une exception
dans le cas contraire.
"""passdefsuppression_sommet(self:Graphe,s:str)->None:"""
Supprime le sommet s s'il existe, lève une exception dans
le cas contraire.
S'assure avant la suppression du sommet que toute arrête
dans laquelle il intervient est supprimée.
"""passdefrend_non_oriente(self:Graphe)->None:"""
Assure que pour toute arête {s1, s2} il existe une
arête {s2, s1}. Si ce n'est pas le cas, cette arête
est créée.
"""passdeftaille(self:Graphe)->int:"""
Retourne le nombre de sommets dans le graphe.
"""returnlen(self.sommets)if__name__=="__main__":s1=Sommet("a")s2=Sommet("b")s3=Sommet("c")s1.adj.append(s2)s1.adj.append(s3)print(s1)print(s2)g1=Graphe("a,b,c,d")print(g1)print(f"Sommet g présent dans le graphe : {g1.existe_sommet('g')}")print(f"Sommet a présent dans le graphe : {g1.existe_sommet('a')}")g1.ajout_sommet("e")print(g1)g1.ajout_arete("a","b")g1.ajout_arete("b","a")g1.ajout_arete("a","e")# g1.ajout_arete("a", "b")g1.ajout_arete("c","e")g1.ajout_arete("e","c")print(g1)print(f"Le graphe est non orienté : {g1.est_non_oriente()}")g1.ajout_arete("e","a")print(f"Le graphe est non orienté : {g1.est_non_oriente()}")print(f"Matrice : {g1.construction_matrice()}")print(g1.representation_matrice())print(f"Taille du graphe : {g1.taille()}")print("---------------------")g2=Graphe("a,b,c,d,e,f,g")print(f"Taille du graphe : {g2.taille()}")g2.ajout_arete("a","d")g2.ajout_arete("a","b")g2.ajout_arete("a","c")g2.ajout_arete("b","a")g2.ajout_arete("b","c")g2.ajout_arete("b","d")g2.ajout_arete("b","f")g2.ajout_arete("c","a")g2.ajout_arete("c","b")g2.ajout_arete("c","e")g2.ajout_arete("d","a")g2.ajout_arete("d","b")g2.ajout_arete("d","f")g2.ajout_arete("e","c")g2.ajout_arete("f","b")g2.ajout_arete("f","d")g2.ajout_arete("f","g")g2.ajout_arete("g","f")print(f"Le graphe est non orienté : {g2.est_non_oriente()}")print(g2.representation_matrice())print(g2.liste_sommets())
Le code du fichier fourni comporte les instructions suivantes :
Lancer le programme et vérifier la validité des vos réponses.
Principe de l’algorithme
On parcourt tous les sommets du graphe dans un ordre arbitraire, et pour chaque
sommet, on lui attribue la première couleur qui n’est pas déjà attribuée
à ses sommets adjacents.
Mettre en œuvre cet algorithme, à la main, sur le graphe proposé dans
le code fourni.
L’implémentation de l’algorithme en Python nécessite la définition de deux
fonctions : coloriage et choix_couleur dont les spécifications sont :
defcoloriage(g:Graphe)->tuple[dict[str,int],int]:"""
Colorie le graphe g passé en argument.
Retourne un tuple constitué du dictionnaire des couleurs pour chaque
sommet et du nombre de couleurs utilisées.
"""
et
defchoix_couleur(sommet:Sommet,couleurs:dict[str,int])->int:"""
Choisi la première couleur disponible en fonction de celles
déjà attribuées aux sommets adjacents.
"""
Remarque : la fonction coloriage appelle la fonction choix_couleur.
Écrire le code Python de ces deux fonctions.
Aide pour l’écriture de la fonction coloriage
La fonction doit :
Initialiser à 0 la variable nbre_couleurs. Elle comptabilise le nombre
de couleurs différentes utilisées lors du coloriage du graphe.
Initialiser au dictionnaire vide la variable couleurs. Ce dictionnaire a
pour clés les étiquettes des sommets visités et pour valeurs les couleurs
associées.
Parcourir tous les sommets du graphe.
Pour chacun d’eux lui attribuer une couleur à l’aide de la fonction
choix_couleur.
Incrémenter d’une unité le compteur de couleurs, si cette couleur n’a
pas déjà été utilisée.
Mettre à jour le dictionnaire des couleurs.
Retourner le tuple constitué du dictionnaire des couleurs et de la variable
qui comptabilise le nombre de couleurs utilisées.
Aide pour l’écriture de la fonction choix_couleur
La fonction doit :
Déterminer le nombre de sommets adjacents au sommet passé en argument.
Initialiser à False la liste de booléens couleurs_attribuees. Les indices
de cette liste sont les couleurs déjà attribuées aux sommets adjacents du sommet
étudié. La valeur True signifie que la couleur a été attribuée, False que
la couleur est libre.
Dans le pire des cas, tous les sommets adjacents ont déjà une couleur attribuée ;
la première couleur attribuable sera donc l’indice n. C’est la raison pour
laquelle la longueur de la liste doit être égale à n+1 si n est le nombre
de sommets adjacents.
Doit rechercher les couleurs des sommets adjacents.
Pour chaque sommet adjacent, elle doit vérifier dans le dictionnaire
couleurs si ce sommet a déjà été colorier.
Si c’est le cas et que cette couleur est inférieure à n, modifier
à True la valeur de la liste couleurs_attribuees pour la couleur
(indice) en question.
Doit rechercher la première couleur (indice) libre dans la liste
couleurs_attribuees et la retourner.
Solution
defcoloriage(g:Graphe)->tuple[dict[str,int],int]:"""
Colorie le graphe g passé en argument.
Retourne un tuple constitué du dictionnaire des couleurs pour chaque
sommet et du nombre de couleurs utilisées.
"""nbre_couleurs=0# Nombre de couleurs utiliséescouleurs={}# Dictionnaire des sommets colorésforsommeting.liste_sommets():# Choix d'une couleur pour le sommetcouleur=choix_couleur(sommet,couleurs)# Incrémentation du compteur de couleurs si nouvelle couleurifcouleurnotincouleurs.values():nbre_couleurs+=1# Ajout de ce sommet au dictionnaire des couleurscouleurs[sommet.val]=couleurreturncouleurs,nbre_couleursdefchoix_couleur(sommet:Sommet,couleurs:dict[str,int])->int:"""
Choisi la première couleur disponible en fonction de celles
déjà attribuées aux sommets adjacents.
"""# Nbre de sommets adjacentsn_adj=len(sommet.liste_adjacents())# Initialisation des couleurs déjà attribuées (indices de la liste)# + 1 assure d'avoir un choix possible pour le sommet étudié.couleurs_attribuees=[Falseforiinrange(n_adj+1)]# recherche des couleurs déjà attribuéesforadjinsommet.liste_adjacents():# Sommet adjacentifadj.valincouleurs.keys():# Sommet déjà coloriécouleur_attribuee=couleurs[adj.val]# avec une valeur <= nifcouleur_attribuee<=n_adj:couleurs_attribuees[couleur_attribuee]=True# Détermination de la couleurforiinrange(len(couleurs_attribuees)):ifnotcouleurs_attribuees[i]:returni
Physique, Chimie et Informatique > Terminales Spé. NSI
Résoudre un problème grâce à un algorithme glouton.
Exemples : problèmes du sac à dos ou du rendu de monnaie. Les algorithmes gloutons constituent une méthode algorithmique parmi d’autres qui seront vues en terminale.
Un client achète un objet qui coûte 53 euros. Il paye avec un billet de 200 euros. Il faut donc lui rendre 147 euros, par exemple un billet de 100, deux billets de 20, un billet de 5 et une pièce de 2.
Pour minimiser le nombre de pièces (on confond dans ce document les pièces et les billets) à rendre, on peut choisir la stratégie suivante :
On commence par rendre la pièce de plus grande valeur possible ;
On déduit cette valeur de la somme (encore) à rendre ;
On recommence, jusqu’à obtenir une somme nulle.
En procédant ainsi, on se rend compte que l’on résout le problème étape par étape et qu’un choix optimal est fait à chaque étape (la pièce de plus grande valeur). Cette stratégie entre donc bien dans la catégorie des algorithmes gloutons.
Préparer la partie de code suivante :
if__name__=="__main__":# valeurs des piècespieces=[1,2,5,10,20,50,100]prix=int(input("Quel est le prix ? "))client=int(input("Combien le client donne-t-il ? "))a_rendre=somme_a_rendre(prix,client)comment=pieces_a_rendre(a_rendre,pieces)reponse=[f"{comment[i]} piece(s) de {pieces[i]}"foriinrange(len(pieces))]print(f"Je dois rendre : {a_rendre}")print(f"Je donne donc : {reponse}")
Définir la fonction somme_a_rendre dont la spécification est :
defsomme_a_rendre(prix:int,client:int)->int:"""
Détermine la somme à rendre à partir du prix et du montant donné par
le client.
"""
Définir la fonction pieces_a_rendre dont la spécification est :
defpieces_a_rendre(somme:int,pieces:list[int])->list[int]:"""
Détermine les pièces (et leur nombre) à choisir pour rendre la somme
passée en argument.
Utilise la division euclidienne et le modulo de façon à pouvoir
traiter tous les cas.
"""
Dans ce document, on s'intéresse à une classe de problèmes d'optimisation connus sous le nom général de « problème du sac à dos ». On peut définir ce problème de la manière suivante : *« durant un cambriolage un voleur possède un sac dont la capacité (en poids par exemple) est limitée. Il se trouve face à un ensemble d'objets qu'il veut dérober. Chacun de ces objets est caractérisé par sa valeur et son poids. Le voleur souhaite optimiser la valeur totale des objets qu'il dérobe tout en ne dépassant pas le poids maximal supporté par son sac ».*
Ce problème est une abstraction pour un grand nombre d’autres problèmes d’optimisation. Il a été utilisé en cryptographie comme base pour différents schémas de chiffrement1. Il faut cependant noter que la plupart de ces schémas de chiffrement ne sont plus actuellement considérés comme sûrs. ^1, il est utilisé lors du chargement des bateaux ou d’avions, lors de la découpe de matériaux (minimisation des coupes « chutes » lors de la découpe), etc.
Problème étudié
On considère un sac à dos de masse maximale m=40kg dans lequel on souhaite ranger les objets dont les caractéristiques sont données ci-dessous :
Objet
A
B
C
D
E
F
Masse
13
12
8
10
14
18
Valeur
700
500
200
300
600
800
Quels objets faut-il sélectionner de façon à ce que la valeur totale, dans le sac à dos, soit maximale ?
Méthode de résolution approchée : stratégie gloutonne
Rappeler ce qu’est une stratégie gloutonne.
Réponse
À retenir
Les algorithmes gloutons forment une catégorie d’algorithmes permettant de parvenir à une solution pour un problème d’optimisation qui vise à maximiser/minimiser une quantité (plus court chemin (GPS), plus petite durée d’exécution, meilleure organisation d’un emploi du temps, etc.)
Le principe d’un algorithme glouton est le suivant :
Résoudre un problème étape par étape ;
À chaque étape, faire le choix optimal de moindre coût (de meilleur gain).
Le choix effectué à chaque étape n’est jamais remis en cause, ce qui fait que cette stratégie permet d’aboutir rapidement à une solution au problème de départ. C’est en ce sens que l’adjectif greedy (glouton/avare) caractérise cet algorithme : il se termine rapidement (glouton) sans fournir beaucoup d’efforts (avare).
Dans la partie principale du programme, définir la liste objets dont les membres sont des dictionnaires représentant les différents objets du problème.
Chacun de ces dictionnaires doit posséder les clés nom, masse, valeur associées aux valeurs.
Solution
Définir la variable masse_max et lui affecter la valeur 40.
Solution
masse_max=40
Le principe de la stratégie gloutonne consiste à ajouter en priorité les objets « les plus efficaces ». « Plus efficace » ne signifie pas « plus grande valeur » mais « plus grande valeur comparativement à la masse ».
Avant d’appliquer l’algorithme glouton, il est nécessaire de trier la liste objets. Définir la fonction suivante :
deftri_objets(objets:list[dict])->list[dict]:"""
Trie la liste de dictionnaires selon les rapports valeur/masse.
"""defrecupere_rapports(objet):returnobjet["valeur"]/objet["masse"]objets_tries=sorted(objets,key=recupere_rapports)returnobjets_tries
Quel concept propre à la programmation fonctionnelle la fonction sorted met-elle en œuvre ?
Solution
Une fonction en Python peut être passée comme argument à une autre fonction.
Décrire précisément la structure et le comportement de la fonction tri_objets.
Affecter, dans la fonction main, le résultat de l’appel de la fonction tri_objets à la variable objets.
Afficher à l’écran la liste triée.
Solution
Définir la fonction construction_sac_a_dos dont la spécification est :
defconstrution_sac_a_dos(objets_tries:list[dict],masse_max:float)->tuple[list[str],int,int]:"""
Construction du sac à dos à partir d'une stratégie gloutonne.
HYPOTHÈSE : la liste de dictionnaires est triée par ordre croissant des rapports
valeurs/masses.
Retourne un tuple constitué d'une liste contenant les noms des objets sélectionnés,
de la valeur du sac à dos et de la masse du sac à dos.
"""
Solution
defconstrution_sac_a_dos(objets_tries:list[dict],masse_max:float)->tuple[list[str],int,int]:"""
Construction du sac à dos à partir d'une stratégie gloultonne.
HYPOTHÈSE : la liste de dictionnaires est triée par ordre croissant des rapports
valeurs/masses.
Retourne un tuple constitué d'une liste contenant les noms des objets sélectionnés,
de la valeur du sac à dos et de la masse du sac à dos.
"""masse_sac=0valeur=0liste_objets=[]i=len(objets_tries)-1# Compteurwhilei>=0:objet=objets_tries[i]# objet est un dictionnaireif(masse_sac+objet["masse"])<=masse_max:valeur+=objet["valeur"]masse_sac+=objet["masse"]liste_objets.append(objet["nom"])i-=1# Décrémentation du compteurreturn(liste_objets,valeur,masse_sac)
Affecter, dans la partie principale du programme, le tuple retourné par la fonction construction_sac_a_dos aux variables sac_a_dos,valeur et masse_sac.
Solution
print("Stratégie gloutonne")print("-------------------")print(f"Constitution du sac à dos : {sac_a_dos}")print(f"Masse du sac à dos : {masse_sac}")print(f"Valeur du sac à dos : {valeur}")print()
Extension : Méthode de résolution exacte
Si on ne prend pas en compte, dans un premier temps, les contraintes, il est possible d’établir la liste des combinaisons possibles des objets à l’aide d’un arbre d’exploration binaire.
Par exemple, voici ce à quoi cet arbre ressemble lorsqu’on prend en compte les trois premiers objets :
graph TD
V("" ) --- A
V --- V1((" "))
A --- C(("A,B"))
C --- D(("A,B,C"))
C --- E(("A,B"))
A --- F(("A"))
F --- G(("A,C"))
F --- H(("A"))
V1 --- I(("B"))
I --- J(("B,C"))
I --- K(("B"))
V1 --- V2((" "))
V2 --- L(("C"))
V2 --- M((" "))
Les combinaisons s’obtiennent en parcourant l’arbre du sommet jusqu’à chaque extrémité : on obtient alors un vecteur dont on peut calculer la poids et la valeur. Il suffit alors de retenir celui dont la masse est inférieure à la masse maximale et dont la valeur est alors maximale.
Au niveau de chaque nœud à quoi correspond le chemin « gauche » : objet retenu ou objet non retenu ?
Réponse
Objet retenu.
Compléter l’arbre avec l’objet D.
Si on implémente un algorithme mettant en œuvre la technique présentée ici, on trouve comme solution [A,C,F]. Vérifier que cette solution est meilleure que celle donnée par l’algorithme glouton.
Pourquoi cette méthode n’est cependant pas utilisable la plupart du temps ? Quel est le nombre de combinaisons possibles ?
Réponse
Le nombre de combinaisons est 2n où n est le nombre d’objets. Cette croissance exponentielle rend l’algorithme exact beaucoup trop lent.
Écrire le code de la fonction masse_sac dont la spécification est :
defmasse_sac(objets:list[dict[str,str]],liste_obj:list[int])->int:"""
Calcule la masse du sac pour la liste d'objets retenus liste_obj.
"""
Écrire le code de la fonction calcul_valeur_sac dont la spécification est :
defcalcul_valeur_sac(objets:list[dict[str,str]],liste_obj:list[int])->int:"""
Calcule la masse du sac pour la liste d'objets retenus liste_obj.
"""
Écrire le code suivant :
defrecherche_recursive(objets:list[dict[str,str]],masse_max:isinstance,list_obj:list[int],i:int)->list[int]:"""
Détermine le chemin de l'arbre de décision correspondant à la valeur optimale
pour une masse du sac déterminée.
"""ifi==len(objets):returnlist_obj[:]val1=-1# Initialisation à une valeur impossible du poidsifobjets[i]["masse"]<=masse_max-masse_sac(objets,list_obj):# Ajoute objet si m_sac - m_inter > 0list_obj[i]=1sol1=recherche_recursive(objets,masse_max,list_obj,i+1)val1=calcul_valeur_sac(objets,sol1)list_obj[i]=0# On n'ajoute pas l'objetsol2=recherche_recursive(objets,masse_max,list_obj,i+1)val2=calcul_valeur_sac(objets,sol2)ifval1>val2:returnsol1[:]else:returnsol2[:]
Examiner cette fonction
Physique, Chimie et Informatique > Terminales Spé. NSI
Algorithmes de tri
Au programme de la classe de première
Contenus
Capacités attendues
Commentaires
Tris par insertion, par sélection
- Écrire un algorithme de tri. - Décrire un invariant de boucle qui prouve la correction des tris par insertion, par sélection.
- La terminaison de ces algorithmes est à justifier. - On montre que leur coût est quadratique dans le pire cas.
La recherche d’un élément dans un tableau est beaucoup plus efficace si ce
tableau est ordonné. À vrai dire, ce n’est pas en cours d’informatique que
vous avez découvert ceci : dans toutes les bibliothèques les livres sont
classés de façon à rendre leur recherche plus rapide !
Info
Le tri des tableaux/listes permet de trouver rapidement les objets recherchés et facilite la recherche des valeurs extrêmes.
La question que se propose d’aborder ce document est donc : « comment classer les éléments d’un tableau selon une relation d’ordre donnée ? ».
Cette question est suffisamment importante pour que de nombreux chercheurs se
soient penchés sur le problème et aient proposé plusieurs dizaines
d’algorithmes différents. Certains sont spécifiques au données numériques,
certains copient les données dans une nouvelle structure ou une structure temporaire (ce qui réclame de l’espace en mémoire supplémentaire), certains effectuent un tri en place (c’est à dire dans le même espace mémoire), certains sont stables (ils préservent alors l’ordre initial des valeurs égales), …
Ce document aborde l’étude du tri par sélection.
Du plus léger au plus lourd
Pour donner une idée de la difficulté du problème de tri, on peut utiliser le
petit jeu à cette adresse.
L’objectif est de trier quelques tonneaux (entre 3 et 10) par ordre de masse
croissante, la masse de chaque tonneau étant attribuée aléatoirement.
On peut utiliser le « Glisser – Déposer » pour déplacer les tonneaux.
On dispose :
d’une balance non étalonnée permettant de comparer les masses des tonneaux 2 à
2
d’étagères pouvant servir de stockage intermédiaire.
Info
Ce sont exactement les mêmes éléments que ceux dont dispose un ordinateur :
une fonction de comparaison et des zones de stockage.
Le but ultime du jeu est évidemment de trier ces tonneaux en faisant le moins
de comparaisons et d’échanges possibles.
Limiter l’animation à trois tonneaux et trouver le tonneau le plus léger.
Décrire la méthode employée. Combien de comparaisons est-il nécessaire de
faire ?
Réponse
On compare les deux premiers tonneaux et on conserve le plus léger sur la
balance. On compare alors ce tonneau à celui qui reste dans la liste de
tonneaux. Deux comparaisons sont donc nécessaires.
Toujours à partir de trois tonneaux, les trier du plus léger au plus lourd.
Décrire la méthode employée (on peut schématiser toutes les étapes sur sa
feuille). Combien de comparaisons est-il nécessaire de faire ?
Réponse
Sans utilisation de la zone de stockage, il faut effectuer 3 comparaison. On peut se
contenter de deux comparaisons si on utilise la zone de stockage.
Choisir maintenant cinq tonneaux. Les trier du plus léger au plus lourd.
Décrire la méthode employée et indiquer combien de comparaisons ont été
effectuées.
(Facultatif) Toujours à partir de cinq tonneaux, essayer de trouver une autre
méthode permettant de les trier. La décrire.
Algorithme de tri
À retenir
Un algorithme de tri est, en informatique ou en mathématiques, un algorithme
qui permet d’organiser une collection d’objets selon un ordre déterminé.
Les objets à trier font donc partie d’un ensemble muni d’une relation d’ordre.
Les ordres les plus utilisés sont l’ordre numérique et l’ordre lexicographique
(dictionnaire).
Tri par sélection
Introduction
La méthode du tri par insertion est expliquée à cette adresse, ou, de façon plus folklorique, à cette adresse.
Remarque : si la folie vous guette, évitez absolument cette vidéo… ou pas !
Visualiser la première vidéo (s’arrêter au bout de 4min40). Essayer de bien
comprendre la méthode.
Appliquer la méthode dans le jeu des tonneaux et trier cinq tonneaux du plus léger au plus lourd. Cette méthode était-elle celle que vous aviez mise en œuvre dans la section 1 ?
La méthode étant bien comprise, choisir sept cartes à jouer (avec les valeurs numériques, pas des figures). Les placer en ligne au hasard sur une table et les trier en appliquant le tri par sélection. Se filmer pendant toute l’opération en commentant chacune des étapes !
Algorithme
Info
À chaque étape du processus, le tableau est divisé en deux sous-tableaux : le
premier (indices plus petits que l’indice courant) est trié, le second
(indices plus grands que l’indice courant n’est pas encore trié). On cherche,
à partir de la position courante, la plus petite valeur dans le sous-tableau
non trié (à droite) et une fois cette dernière trouvée, on permute (si
nécessaire) la valeur courante et la valeur la plus petite.
Remarque : La permutation des valeurs contenues dans deux variables est souvent employée en informatique, elle nécessite une troisième variable pour un stockage
temporaire.
À retenir
Le tri par sélection est basé sur l’utilisation de deux boucles Pour imbriquées :
La première boucle parcourt la liste des valeurs, de la première à l’avant dernière ;
La seconde boucle recherche la plus petite valeur, de la position courante (compteur de la première boucle) à la fin du tableau, puis l’échange avec la position courante.
La partie gauche de la liste est donc triée au fur et à mesure de l’avancement
de la première boucle.
L’algorithme du tri par sélection est un algorithme de tri en place : la
réorganisation du tableau ne nécessite pas la création d’un nouveau tableau,
ce qui économise de la place en mémoire.
À partir de toutes les informations précédentes, écrire l’algorithme du tri par sélection. Implémenter cet algorithme en Python.
Réponse
fromrandomimportrandintdeftri_selection(tab:list[int|float])->None:"""
Tri par sélection.
"""foriinrange(len(tab)-1):# On s'arrête à l'avant-dernier élémentval_min=tab[i]# On sauvegarde la valeur couranteforjinrange(i+1,len(tab)):# On s'arrête au dernier élémentiftab[j]<val_min:val_min=tab[j]# On repère la valeur la plus petitej_min=j# et son indicetab[j_min]=tab[i]tab[i]=val_minif__name__=="__main__":tab=[randint(1,1000)foriinrange(20)]print(tab)tri_selection(tab)print(tab)
Faire tourner « à la main » l’algorithme lorsque la fonction reçoit le tableau
tab = [5,2,4,6,1,3].
Comment prouve-t-on, de façon générale, la terminaison d’un algorithme ?
Réponse
On recherche un variant de boucle.
À retenir
Un variant de boucle est une expression arithmétique associée à une boucle qui satisfait deux conditions :
Valeur initiale : Le variant doit être initialisé avec une valeur entière non négative avant que la boucle ne commence.
Décroissance : À chaque itération de la boucle, la valeur du variant doit décroître. Cela signifie que le variant agit comme une mesure de progression vers la sortie de la boucle.
L’idée derrière la notion de variant de boucle est que si le variant est toujours non négatif et diminue lors de la progression de la boucle, alors la boucle ne peut pas continuer indéfiniment. Si la boucle continue indéfiniment, cela signifie que le variant ne décroît pas à chaque itération, ce qui contredit la propriété de décroissance du variant.
Est-il nécessaire de prouver la terminaison de cet algorithme ?
Réponse
L’algorithme fait intervenir deux boucles Pour. Il se termine donc forcément puisqu’il s’agit de boucles déterministes.
Comment prouve-t-on, de façon générale, la correction d’un algorithme ?
Réponse
On recherche un invariant de boucle.
À retenir
Un invariant de boucle est une proposition vraie à chaque tour de boucle. Associé à une postcondition il permet, au final, de montrer la correction d’un algorithme.
Pour qu’un invariant de boucle soit efficace, il doit satisfaire deux propriétés essentielles :
Initialisation : L’invariant doit être vrai avant la première itération de la boucle. Cela garantit que l’invariant est une propriété valable lorsque la boucle commence son exécution.
Conservation : Si l’invariant est vrai avant une itération de la boucle, alors il doit également rester vrai après l’itération, à condition que la condition de boucle (la condition qui détermine si la boucle doit continuer ou s’arrêter) soit vraie. Cela assure que l’invariant reste préservé à chaque étape de la boucle.
Un invariant de boucle doit être associé à une postcondition, c’est dire à une propriété qui doit être vraie à la fin de la boucle.
Prouver que la proposition « Au début de chaque itération de la boucle Pour externe le tableau tab[0, ..., i-1] est un tableau trié constitué des i plus petits éléments du tableau tab, dans l’ordre croissant.» est un invariant de boucle.
Prouver que l’algorithme est correct.
Réponse
Déterminer la complexité de l’algorithme.
Dans quels cas le tri par sélection peut-il être pertinent ?
Le tri par sélection est globalement peu efficace. On peut tout de même lui attribuer quelques qualités :
Petites quantités de données : Le tri par sélection peut être efficace pour trier de petites quantités de données. Sa complexité en temps est de l’ordre de O(n2), ce qui peut devenir inefficace pour des ensembles de données très importants. Pour des listes de taille modérée, le tri par sélection peut être simple à comprendre et à mettre en œuvre.
Complexité en espace : Le tri par sélection n’a besoin que d’une quantité constante d’espace supplémentaire, ce qui signifie qu’il peut être plus efficace en termes de mémoire que d’autres algorithmes qui nécessitent une mémoire auxiliaire plus importante.
Stabilité : Le tri par sélection est stable, ce qui signifie qu’il préserve l’ordre relatif des éléments égaux. Si la stabilité est une exigence, le tri par sélection peut être préférable dans certains cas.
Peu de mouvements d’éléments : Bien que le tri par sélection effectue un nombre quadratique de comparaisons, le nombre de mouvements d’éléments est linéaire (l’échange d’éléments n’a lieu qu’une seule fois à chaque itération). Cela peut être avantageux dans des situations où le coût des comparaisons est faible par rapport au coût des déplacements d’éléments dans la mémoire.
Physique, Chimie et Informatique > Terminales Spé. NSI > Algorithmes de tri
Le tri par insertion est un tri « naturel » souvent qualifié de « tri du
joueur de carte ».
Comment un joueur de carte trie-t-il ses cartes ?
Au début, la main gauche du joueur est vide et ses cartes sont posées sur la
table.
Le joueur prend alors sur la table les cartes, une par une avec sa main
droite, pour les placer dans sa main gauche.
Pour savoir où placer une carte dans son jeu, le joueur la compare avec
chacune des cartes déjà présentes dans sa main gauche, en examinant les cartes
de la droite vers la gauche.
À tout moment, les cartes tenues par la main gauche sont triées ; ces cartes
étaient, à l’origine, les cartes situées au sommet de la pile sur la table.
Choisir sept cartes à jouer. Les placer en ligne au hasard sur une table et
mettre en œuvre la technique décrite ci-dessus. Se filmer pendant toute l’opération en commentant chacune des étapes !
Tri par insertion
Introduction
La méthode du tri par insertion est ilustré à cette adresse, ou, de façon plus folklorique, à cette adresse.
Remarque : si la folie vous guette, évitez absolument cette vidéo… ou pas !
Visualiser la première vidéo (s’arrêter au bout de 4min40). Essayer de bien
comprendre la méthode.
La méthode étant bien comprise, choisir sept cartes à jouer (avec les valeurs
numériques, pas des figures). Les placer en ligne au hasard sur une table et
les trier en appliquant le tri par insertion.
Se filmer pendant toute l’opération en commentant chacune des étapes !
Algorithme
Info
À chaque étape du processus, le tableau est divisé en deux sous-tableaux : le
premier (indices plus petits que l’indice courant) est trié, le second
(indices plus grands que l’indice courant n’est pas encore trié). On cherche
la place de l’élément courant (non encore trié) dans le tableau trié.
À retenir
Le tri par insertion est basé sur l’utilisation de deux boucles imbriquées :
La première boucle, une boucle Pour, parcourt la liste des valeurs, de la
deuxième à la dernière ;
La seconde boucle, une boucle TantQue, cherche à placer l’élément courant
dans la première partie triée du tableau (indices inférieurs à l’indice
courant).
L’algorithme du tri par insertion est un algorithme de tri en place. La
réorganisation du tableau ne nécessite pas la création d’un nouveau tableau,
ce qui économise de la place en mémoire.
À partir de toutes les informations précédentes, écrire l’algorithme du tri par insertion. Implémenter cet algorithme en Python.
Réponse
deftri_insertion(tab:list[int|float|str])->None:""" Tri par insertion """foriinrange(1,len(tab)):valeur=tab[i]# Sauvegarde de la valeur en coursj=i-1# Indice de la boucle internewhiletab[j]>valeurandj>=0:tab[j+1]=tab[j]# On remonte la valeur plus grandej=j-1tab[j+1]=valeur# On insère la valeur dans le tableau
Faire tourner « à la main » l’algorithme lorsque la fonction reçoit le tableau
tab = [5,2,4,6,1,3].
Comment prouve-t-on, de façon générale, la terminaison d’un algorithme ?
Est-il nécessaire de prouver la terminaison de la boucle externe de cet
algorithme ? De la boucle interne ?
Démontrer la terminaison de cet algorithme.
Comment prouve-t-on, de façon générale, la correction d’un algorithme ?
Prouver que la proposition « Au début de chaque itération de la boucle Pour externe le tableau tab[0, ..., i-1] est un tableau trié dans l’ordre croissant.» est un invariant de boucle.
Prouver que l’algorithme est correct.
Déterminer la complexité de l’algorithme.
Info
Le tri par sélection est globalement peu efficace. On peut tout de même lui attribuer quelques qualités :
Pour de petites listes ou des données déjà partiellement triées : Si vous avez une petite liste d’éléments à trier ou si votre liste est déjà partiellement triée, le tri par insertion peut être plus simple et rapide que d’autres méthodes.
Si vous voulez que l’ordre initial des éléments identiques soit préservé : Le tri par insertion est une méthode « stable », ce qui signifie qu’il conserve l’ordre d’origine des éléments égaux. Cela peut être important dans certaines situations.
Lorsque vous ajoutez de nouveaux éléments à une liste déjà triée : Le tri par insertion s’adapte bien lorsque vous ajoutez de nouveaux éléments à une liste déjà triée. En effet, la plupart des éléments sont déjà à leur place correcte ; le tri par insertion profite donc de cette caractéristique en minimisant le nombre d’opérations nécessaires pour insérer de nouveaux éléments car il peut sauter rapidement à travers la partie triée sans avoir à déplacer de nombreux éléments.
Si vous avez des contraintes de mémoire : Le tri par insertion est un tri en place, il utilise une quantité constante de mémoire supplémentaire, ce qui peut être avantageux si vous avez des contraintes de mémoire.
Physique, Chimie et Informatique > Terminales Spé. NSI
Méthode « Diviser pour régner »
Au programme
Contenus
Capacités attendues
Commentaires
- Méthode « diviser pour régner ».
Écrire un algorithme utilisant la méthode « diviser pour régner ».
- La rotation d’une image bitmap d’un quart de tour avec un coût en mémoire constant est un bon exemple. - L’exemple du tri fusion permet également d’exploiter la récursivité et d’exhiber un algorithme de coût en nlog2n dans les pires des cas.
On parvient à découper un problème en sous-problèmes indépendants les uns des autres. On poursuit cette démarche jusqu’à aboutir à une situation simple : cas de base.
La solution du cas de base est généralement simple à obtenir et permet la construction de la solution du problème.
Remarque
C’est l’indépendance des sous-problèmes qui permet la construction de la solution globale directe par recombinaison des solutions intermédiaires.
Exemples
Exponentiation rapide
Recherche dichotomique dans un tableau trié, dans une liste triée
Tri rapide d’un tableau
Tri fusion récursif d’un tableau
etc.
Schéma de résolution
À retenir
Diviser
On décompose le problème initial en un ou plusieurs sous-problèmes de plus petites tailles.
Régner
Chaque sous-problème est résolu
Combiner
Les solutions des sous-problèmes sont combinées pour construire la solution du problème initial.
Remarques
Cette procédure se prête naturellement à un traitement récursif des problèmes mais une approche itérative reste possible.
Cette procédure assure que l’algorithme est correct. Il reste à valider sa terminaison (que le cas de base est toujours atteint ).
Exercice : exponentiation rapide
L’algorithme suivant permet de calculer an :
an={1a×an−1if n=0if n>0
Programmer la fonction puissance1 dont la spécification est :
defpuissance1(a:int,n:int)->int:"""
Calcul de a^n.
"""
Penser à écrire quelques tests.
Réponse
defpuissance1(a:int,n:int)->int:"""
Calcul de a^n.
Implémentation de l'algorithme 1.
"""ifn==0:return1else:returna*puissance1(a,n-1)if__name__=="__main__":assertpuissance1(3,2)==9assertpuissance1(5,0)==1assertpuissance1(2,8)==256print("Done!")
Quelle est la complexité de cet algorithme ?
Réponse
Le calcul nécessite n appels récursifs et n+1 multiplications. La complexité est donc en O(n).
L’algorithme suivant permet aussi de calculer an :
an=⎩⎨⎧1(ak)2a×(ak)2if n=0if n=2k (n est pair)if n=2k+1 (n est impair)
Programmer la fonction puissance2 dont la spécification est :
defpuissance2(a:int,n:int)->int:"""
Calcul de a^n.
Implémentation de l'algorithme 2.
"""
Penser à écrire quelques tests.
Réponse
defpuissance2(a:int,n:int)->int:"""
Calcul de a^n.
"""ifn==0:return1calc=puissance2(a,n//2)ifn%2==0:returncalc**2else:returna*(calc)**2if__name__=="__main__":assertpuissance2(3,2)==9assertpuissance2(5,0)==1assertpuissance2(2,8)==256print("Done!")
Justifier que le seconde algorithme met en œuvre le raisonnement « Diviser pour règner ».
Réponse
La première ligne de l’algorithme correspond au cas de base pour lequel n=0 et an=1.
Pour n>0, à partir de la valeur n, le calcul se poursuit avec la valeur ⌊2n⌋. On décompose le calcul de an en celui de a⌊2n⌋, puis celui de a⌊2n⌋/2, etc. jusqu’à atteindre le cas de base. Chaque calcul intermédiaire se fait sur une instance plus petite.
Chaque calcul intermédiaire est aussi indépendant du calcul précédent.
Remarque
⌊2n⌋ est la notation mathématique pour l’opération en Python n // 2, c’est à dire le plus grand entier inférieur au résultat de la division denpar 2.
⌈2n⌉ est la notation mathématique pour l’opération en Python n // 2 + 1, c’est à dire pour le plus petit entier supérieur au résultat de la division denpar 2.
Pourquoi appelle-t-on l’algorithme 2, l’exponentiation rapide ?
Réponse
Soit k le nombre de fois qu’il faut diviser (division euclidienne) n par 2 pour parvenir à la valeur 1. k est tel que
1=2kn⟺2k=n⟺k=log2n
.
Il reste un appel récursif supplémentaire à effectuer pour arriver au cas de base.
La complexité de l’algorithme est donc en O(log2n) ; elle est bien meilleure que celle de l’algorithme 1.
Conclusion
À retenir
La méthode « Diviser pour régner » est le paradigme naturel de la récursivité.
La complexité d’un algorithme qui s’appuit sur le paradigme « Diviser pour régner » est parfois optimale (exponentiation rapide, recherche dichotomique, tri fusion, etc.) mais pas toujours (recherche du minimum et du maximum dans une liste, somme des éléments d’une liste, recherche dans une liste non triée, etc.).
L’efficacité d’un algorithme qui s’appuit sur le paradigme « Diviser pour régner » dépend de l’implémentation de la récursivité par le langage choisi.
Exercice : recherche dichotomique
Écrire le code de la fonction recherche1 dont la spécification est la suivante :
defrecherche1(liste:list[int],val:int)->int:"""
Retourne l'indice de la valeur dans la liste si cette
dernière est présente, -1 sinon.
HYPOTHÈSE : val est unique si présente.
Algorithme itératif.
"""
Réponse
defrecherche1(liste:list[int],val:int)->int:"""
Retourne l'indice de la valeur dans la liste si cette
dernière est présente, -1 sinon.
HYPOTHÈSE : val est unique si présente.
Algorithme itératif.
"""g=0# indice le plus petitd=len(liste)-1# indice le plus grandtrouve=Falsewhile(g<d)andnottrouve:m=(g+d)//2# indice milieuifliste[m]==val:trouve=Trueelifliste[m]>val:d=m-1else:g=m+1returnmiftrouveelse-1
Tester la fonction recherche1.
Écrire le code de la fonction recherche2 dont la spécification est la suivante :
defrecherche2(liste:list[int],val:int,g:int,d:int)->bool:"""
Retourne l'indice de la valeur dans la liste si cette
dernière est présente, -1 sinon.
HYPOTHÈSE : val est unique si présente.
Algorithme récursif.
"""
Réponse
defrecherche2(liste:list[int],val:int,g:int,d:int)->bool:"""
Retourne l'indice de la valeur dans la liste si cette
dernière est présente, -1 sinon.
HYPOTHÈSE : val est unique si présente.
Algorithme récursif.
"""ifg>d:return-1else:m=(g+d)//2# indice milieuifliste[m]==val:returnmelifliste[m]>val:returnrecursive(liste,val,g,m-1)else:returnrecursive(liste,val,m+1,d)
Tester la fonction recherche2.
Physique, Chimie et Informatique > Terminales Spé. NSI > Méthode « Diviser pour régner »
Dans cette partie, nous allons essayer de comprendre les principes sur lesquels s’appuie ce tri. Son implémentation, pour des tableaux ou des listes chaînées, sera développée dans les prochaines sections.
Le tri fusion s’appuie sur la méthode Diviser pour régner pour trier les n éléments d’une séquence S :
Diviser : Si la séquence S est composée de 0 ou un élément, retourner S immédiatement ; cette séquence est déjà triée. Si la séquence S est composée de plus de deux éléments, la diviser en deux sous-séquences S1 et S2 contenant chacune environ la moitié des éléments de S ; donc S1 est formée des ⌊2n⌋ premiers éléments de S contient les ⌈2n⌉ derniers éléments de S.
Régner : Trier récursivement S1 et S2.
Combiner : Reformer la séquence S en combinant, dans l’ordre, les éléments des séquences triées S1 et S2.
Info
⌊2n⌋ est la notation mathématique pour l’opération en Python n // 2, c’est à dire le plus grand entier inférieur au résultat de la division denpar 2.
⌈2n⌉ est la notation mathématique pour l’opération en Python n // 2 + 1, c’est à dire pour le plus petit entier supérieur au résultat de la division denpar 2.
Pour bien comprendre la méthode employée, le plus simple est de construire un arbre binaire dans lequel chaque nœud est le résultat d’un appel récursif.
On peut montrer que la hauteur de l’arbre des appels récursifs est voisine (en fonction de la définition choisie pour la hauteur) de log2(n) où n est le nombre d’éléments dans la séquence.
Implémentation du tri fusion pour un tableau
Étudier le code suivant et remplacer les … pour chaque numéro.
deftri_fusion(S:list[int])->None:"""
Implémentation du tri fusion.
La liste S est modifiée en place.
"""n=len(S)# ... (0)ifn<2:returnNone# ... (1)# Diviser, Régner, Combiner ? ... (2)milieu=n//2S1=S[:milieu]# .... (3)S2=S[milieu:]# .... (4)# Diviser, Régner, Combiner ? ... (5)tri_fusion(S1)# ... (6)tri_fusion(S2)# ... (7)# Diviser, Régner, Combiner ? ... (8)fusion(S1,S2,S)# ... (9)
Étudier le code suivant et expliquer comment s’effectue la fusion.
deffusion(S1:list[int],S2:list[int],S:list[int])->None:"""
Combine les éléments des deux listes S1 et S2 dans la liste S (en place).
i est le nombre d'élément(s) de S1 copié(s) dans S.
j est le nombre d'élément(s) de S2 copié(s) dans S.
On doit donc avoir i + j <= len(S).
"""i=0j=0whilei+j<len(S):ifj==len(S2)or(i<len(S1)andS1[i]<S2[j]):S[i+j]=S1[i]i=i+1else:S[i+j]=S2[j]j=j+1
Étudier le comportement du programme complet à l’aide de pythontutor.
Construire la liste à l’aide de l’instruction :
liste=[randint(1,400)foriinrange(5)]
Quelle est la complexité de la fonction fusion ?
Essayer d’évaluer la complexité de l’algorithme sans faire de calcul.
Le tri fusion d’une liste chaînée
Dans cette section, on cherche à adapter l’algorithme de tri fusion à une liste chaînée.
Écrire le code de la classe Cellule permettant d’implémenter une liste chaînée. Cette classe sert juste de structure et définit les champs valeur, de type int, et suivant, de type Cellule, initialisé à None.
Dans la partie principale du programme, écrire le code qui crée la liste chaînée [14, 11, 2, 35, 9, 1].
Définir le code de la fonction tri_fusion dont la spécification est
deftri_fusion(lst:Cellule)->Cellule:"""
Implémente l'algorithme de tri-fusion.
Une nouvelle liste chaînée est créée.
"""
Cette fonction doit utiliser la fonction coupe (définie un peu plus bas), qui découpe une liste chaînée en deux sous-listes, et la fonction fusion (définie elle aussi un peu plus bas) qui réalise la fusion de deux listes triées.
La fonction tri_fusion doit mettre en œuvre le principe « Diviser pour régner ».
Définir la fonction coupe dont la spécification est
defcoupe(lst:Cellule)->Cellule:"""
Découpe la liste L2 est deux sous-listes de même
longueur à un élément près.
"""
Définir la fonction fusion dont la spécification est
deffusion(l1:Cellule,l2:Cellule)->Cellule:"""
Réalise la fusion des deux listes l1 et l2
triées.
Algorithme récursif.
"""
Physique, Chimie et Informatique > Terminales Spé. NSI > Méthode « Diviser pour régner »
Recherche des plus grand et petit éléments dans un tableau
L’objectif de ce document est d’écrire et d’implémenter un algorithme s’appuyant sur le raisonnement « Diviser pour régner » qui permet de déterminer le maximum et le minimum des éléments dans un tableau.
Générer une liste contenant un million de termes choisis aléatoirement entre un et mille milliards.
Réponse
Utiliser les fonctions min et max fournies par le langage Python afin d’afficher les maximum et minimum dans la liste.
Réponse
print("Fonctions Python")val_min,val_max=(min(tab),max(tab))print("min = {}, max = {}".format(val_min,val_max))
Écrire le code de la fonction maxmin1 qui, à partir d’un algorithme de « brute force », détermine les maximum et minimum dans la liste passée en argument.
La spécification de la fonction est :
defmaxmin1(tab:List[float])->Tuple[float,float]:"""
Recherche du minimum et du maximum dans le tableau tab.
Paradigme « Brute force »
"""
Réponse
defmaxmin1(tab:List[float])->Tuple[float,float]:"""
Recherche du minimum et du maximum dans le tableau tab.
Paradigme « Brute force »
"""val_max=tab[0]val_min=tab[0]foreltintab:ifelt>val_max:val_max=eltifelt<val_min:val_min=eltreturn(val_min,val_max)
Vérifier le bon fonctionnement de la fonction maxmin1 en affichant les maximum et minimum dans la liste, à la suite de ceux déterminés à l’aide des fonctions fournies par Python.
Réponse
print("Recherche « Brute Force »")val_min,val_max=maxmin1(tab)print("min = {}, max = {}".format(val_min,val_max))
Quelle est la complexité de la fonction maxmin1 ?
Réponse
Il est nécessaire de parcourir tout le tableau, la complexité est donc en O(N).
Comparer l’efficacité de la fonction maxmin1 à celle des fonctions fournies par Python en mesurant les durées d’exécution à l’aide de la fonction time du module time.
Réponse
importtimeif__name__=="__main__":tab=[randint(1,int(1e12))foriinrange(int(1e6))]print("Fonctions Python")t1=time.time()val_min,val_max=(min(tab),max(tab))t2=time.time()print("min = {}, max = {}".format(val_min,val_max))print("Durée de la recherche : {} s".format(t2-t1))print("Recherche « Brute Force »")t1=time.time()val_min,val_max=maxmin1(tab)t2=time.time()print("min = {}, max = {}".format(val_min,val_max))print("Durée de la recherche : {} s".format(t2-t1))
Il existe un rapport 2 entre les durées d’exécution des deux fonctions. Elles sont donc du même ordre de grandeur.
En faisant varier le nombre d’éléments dans le tableau, vérifier si les durées d’exécution de la fonction maxmin1 correspond bien à la complexité établie à la question 5.
La complexité des fonctions max et min fournies par Python vous semblent-elles être en O(N) ?
Écrire et implémenter la fonction maxmin2 qui implémente le raisonnement «Diviser pour régner » pour résoudre ce problème.
Dans un premier temps, écrire une fonction qui se contente de déterminer le maximum dans la liste passée en argument. Compléter ensuite le code de façon à ce que le maximum et le minimum soient retournés.
La spécification de la fonction est :
defmaxmin2(tab:List[float])->float:"""
Recherche du maximum dans le tableau tab.
Paradigme : Diviser pour règner
"""
Réponse
defmaxmin2(tab:List[float])->float:"""
Recherche du maximum dans le tableau tab.
Paradigme : Diviser pour régner
"""# Cas de baseiflen(tab)==1:returntab[0]# Divisermilieu=len(tab)//2max1=maxmin2(tab[:milieu])max2=maxmin2(tab[milieu:])# Régnermaximum=max(max1,max2)# Combinerreturnmaximum
Remarque : on peut aussi développer sa propre fonction max.
Vérifier le bon fonctionnement de la fonction à la suite des précédentes vérifications.
Réponse
print("Diviser pour régner")val_max=maxmin2(tab)print("max = {}".format(val_max))
Modifier la fonction maxmin2 afin qu’elle retourne les maximum et minimum dans la liste.
La spécification de la fonction est :
defmaxmin2(tab:List[float])->Tuple[float,float]:"""
Recherche du minimum et du maximum dans le tableau tab.
Paradigme : Diviser pour régner
"""
Réponse
defmaxmin2(tab:List[float])->Tuple[float,float]:"""
Recherche du minimum et du maximum dans le tableau tab.
Paradigme : Diviser pour régner
"""# Cas de baseiflen(tab)==1:return(tab[0],tab[0])# Divisermilieu=len(tab)//2max1,min1=maxmin2(tab[:milieu])max2,min2=maxmin2(tab[milieu:])# Régnermaximum=max(max1,max2)minimum=min(min1,min2)# Combinerreturn(minimum,maximum)
Quelle est la complexité de cette fonction ?
Réponse
Si on note C(n) la complexité en nombre de comparaisons à effectuer pour résoudre le problème en fonction de la taille du tableau, on obtient la relation suivante :
C(n)=⎩⎨⎧022C(n//2)+2si n=1si n=2si n>2
Dans la suite de cette partie, pour résoudre cette récurrence, on simplifie le problème en posant n=2k (on ne restreint pas la généralité de la conclusion en effectuant cette hypothèse).
On a alors
il faut diviser k−1 fois pour parvenir au cas de base, on a alors
C(n)=2k−1×C(2)+i=1∑k−12i
Comme C(2)=2 et ∑i=1k−12i=2k−2,
C(n)=2k−1×2+2k−2=2k+2k−2
Finalement
C(n)=2n−2
Il faut donc 2n−2 comparaisons pour résoudre le problème. La complexité est donc linéaire.
Vérifier le bon fonctionnement de la fonction à la suite des précédentes vérifications.
Réponse
print("Diviser pour régner")t1=time.time()val_min,val_max=maxmin2(tab)t2=time.time()print("min = {}, max = {}".format(val_min,val_max))print("Durée de la recherche : {} s".format(t2-t1))
La fonction maxmin2 est-elle, théoriquement, plus efficace que la fonction maxmin1 ? Dans la pratique ? Comment expliquer ce comportement ?
Réponse
La fonction maxmin2 n’est théoriquement pas plus efficace que la fonction maxmin1 puisque dans les deux cas, la complexité est linéaire.
En pratique, la fonction maxmin2 peut même être moins efficace que la fonction maxmin1 ! Tout dépend de l’implémentation de la récursivité par le langage.
Physique, Chimie et Informatique > Terminales Spé. NSI > Méthode « Diviser pour régner »
Le problème mathématique des tours de Hanoï a été inventé par Édouard Lucas. Paru d’abord en fascicule en 1889 , il est publié ensuite dans le tome 3 de ses « Récréations mathématiques », parues à titre posthume en 1892. Il annonce que ce problème est dû à un de ses amis, N. Claus de Siam (anagramme de Lucas d’Amiens, Amiens étant sa ville de naissance), prétendument professeur au collège de Li-Sou-Stian (anagramme de Saint Louis, le lycée où Lucas enseignait).
Sous le titre « Les brahmes tombent », Lucas relate que « N. Claus de Siam a vu, dans ses voyages pour la publication des écrits de l’illustre Fer-Fer-Tam-Tam, dans le grand temple de Bénarès, au-dessous du dôme qui marque le centre du monde, trois aiguilles de diamant, plantées dans une dalle d’airain, hautes d’une coudée et grosses comme le corps d’une abeille.Sur une de ces aiguilles, Dieu enfila au commencement des siècles, 64 disques d’or pur, le plus large reposant sur l’airain, et les autres, de plus en plus étroits, superposés jusqu’au sommet. C’est la tour sacrée du Brahmâ.Nuit et jour, les prêtres se succèdent sur les marches de l’autel, occupés à transporter la tour de la première aiguille sur la troisième, sans s’écarter des règles fixes que nous venons d’indiquer, et qui ont été imposées par Brahma.Quand tout sera fini, la tour et les brahmes tomberont, et ce sera la fin des mondes ! ».
Au début du jeu, les disques sont tous positionnés sur la première tige (du plus grand au plus petit) et l’objectif est de déplacer tous ces disques sur la troisième tige, en respectant les règles suivantes :
Un seul disque peut être déplacé à la fois ;
On ne peut jamais poser un disque sur un disque de diamètre inférieur.
Numéroter chaque disque pour un empilement à 4 disques et écrire l’enchaînement des étapes nécessaires à la réalisation de la tâche.
Faire émerger le raisonnement récursif qui permet de résoudre le problème.
Réponse
Pour pouvoir déplacer le dernier disque (celui du dessous), il est nécessaire de déplacer les n−1 disques qui le couvrent sur la tige centrale. Une fois ces déplacements effectués, on peut le déplacer sur la troisième tige. Il reste alors à déplacer les n−1 autres disques vers la troisième tige.
Écrire le code de la fonction dont la spécification est
defhanoi(n:int,source:str,milieu:str,destination:str)->None:"""
Fonction qui déplace récursivement les disques selon les règles des tours de Hanoï.
"""
Tester cette fonction.
Aide
Info
L’algorithme est le suivant :
Si le nombre de disques est égal à 0, ne rien faire ;
Si le nombre de disques est égal à 1, déplacer directement le disque du piquet A au piquet C ;
Si le nombre de disques est supérieur ou égal à 2, enchaîner les étapes suivante :
Déplacer n−1 disques du piquet A jusqu’au piquet B ;
Déplacer le disque qui reste du piquet A au piquet C ;
Déplacer n−1 disques du piquet B au piquet C.
Indiquer tous les appels de fonctions et toutes les instructions exécutées pour n=3.
Réponse
hanoi(3, "A", "B", "C")
hanoi(2, "A", "C", "B")
hanoi(1, "A", "B", "C")
hanoi(0, "A", "C", "B")
Affichage : 1 de A à C
hanoi(0, "B", "A", "C")
Affichage : 2 de A à B
hanoi(1, "C", "A", "B")
hanoi(0, "C", "B", "A")
Affichage : 1 de C à B
hanoi(0, "A", "C", "B")
Affichage : 3 de A à C
hanoi(2, "B", "A", "C")
hanoi(1, "B", "C", "A")
hanoi(0, "B", "A", "C")
Affichage : 1 de B à A
hanoi(0, "C", "B", "A")
Affichage : 2 de B à C
hanoi(1, "A", "B", "C")
hanoi(0, "A", "C", "B")
Affichage : 1 de A vers C
hanoi(0, "B", "A", "C")
Quelle est la complexité de la fonction ?
Réponse
Récurrence
Si on note xn le nombre de mouvement pour déplacer n disques, on obtient la relation de récurrence :
Physique, Chimie et Informatique > Terminales Spé. NSI > Méthode « Diviser pour régner »
Problème de la sous-séquence de somme maximale
Ce document étudie le problème de la sous-séquence de somme maximale. Ce problème est intéressant parce qu’il existe nombre d’algorithmes pour le résoudre et la complexité (en nombre d’opérations de somme) de ces algorithmes varie considérablement.
Seulement deux algorithmes seront abordés, un prochain document présentera l’algorithme le plus efficace (cf. programmation dynamique).
Présentation
Info
Étant donné un tableau tab[1..n] d’entiers (positifs et négatifs), déterminer la valeur maximale du sous-tableau tab[g..h] donnant la plus grande somme de tous les sous-tableaux contigus de tab.
Pour plus de commodité, la sous-séquence de somme maximale est 0 si tous les entiers sont négatifs.
Exemples
Pour le tableau tab = [-2, -5, 6, -2, -3, 1, 5, -6], la sous séquence de somme maximale est [6, -2, -3, 1, 5] et sa somme est 7.
Pour le tableau tab = [0, 1, 2, -2, 3, 2], la sous séquence de somme maximale est [1, 2, -2, 3, 2] et sa somme est 6.
Pour le tableau tab = [1, -2, 3, 10, -4, 7, 2, -5], la sous séquence de somme maximale est [3, 10, -4, 7, 2] et sa somme est 18.
Paradigme « Brute force »
On envisage dans un premier temps un algorithme basé sur le paradigme « Brute force » : on évalue la somme de chaque sous-tableau (parmi les n(n+1)/2 sous-tableaux possibles) et à chaque évaluation on mémorise la somme maximale.
Écrire le code de la fonction sous_tab_max dont la spécification est :
defsous_tab_max(tab:List[int])->int:"""
Recherche de la somme maximale dans un tableau.
Paradigme : « Brute force ».
"""
Tester cette fonction.
Réponse
defsous_tab_max(tab:List[int])->int:"""
Recherche de la somme maximale dans un tableau.
Paradigme : « Brute force ».
"""smax=0foriinrange(len(tab)-1):somme=0forjinrange(i,len(tab)):somme+=tab[j]smax=max(smax,somme)returnsmax
Quelle est la complexité de cette fonction ?
Réponse
On retrouve deux boucles imbriquées dans la fonction, la complexité est donc en O(n2).
Paradigme « Diviser pour régner »
Dans la suite, on cherche à mettre en œuvre le paradigme « Diviser pour régner ».
Le tableau initial est scindé en deux parties de tailles à peu près égales (selon que n est pair ou impair) : la plus grande somme se trouve soit dans le sous-tableau B de droite, soit dans le sous-tableau A de gauche, soit à cheval sur les deux sous-parties. Dans ce dernier cas elle est constituée d’une plus grande somme de la partie gauche se terminant à la fin de la partie gauche (c.-à-d. en m), et d’une plus grande somme de la partie droite commençant au début de la partie droite (c’est à dire en m+1).
La procédure est récursive. Pour « sortir » des appels récursifs, il est nécessaire de rencontrer un « couple de données-paramètres » (transmis à l’appel) dont la solution est triviale. C’est le cas si le tableau est composé d’au plus un élément.
Écrire le code de la fonction somme_max dont la spécification est :
defsomme_max(tab:List[int])->int:"""
Recherche de la somme maximale dans un
sous-tableau en appliquant le paradigme
« Diviser pour régner ».
"""
Remarque
Ne pas effectuer le calcul de la somme maximale se trouveant dans la séquence à cheval sur les deux sous-parties. Ce calcul doit être effectué par un appel à la fonction max_sous_tab définie ci-dessous.
Réponse
defsomme_max(tab:List[int])->int:"""
Recherche de la somme maximale dans un
sous-tableau en appliquant le paradigme
« Diviser pour régner ».
"""# Cas de baseiflen(tab)==1:returnmax(0,tab[0])# Divisermilieu=len(tab)//2s_max1=somme_max(tab[:milieu])s_max2=somme_max(tab[milieu:])s_max3=max_sous_tab(tab,milieu)# Régners_max=max(s_max1,s_max2,s_max3)# Combinerreturns_max
Écrire le code de la fonction max_sous_tab dont la spécification est :
defmax_sous_tab(tab:List[float],milieu:int)->float:"""
Recherche la somme maximale entre les deux
sous-tableaux du tableau tab à partir du milieu.
"""
Réponse
defmax_sous_tab(tab:List[float],milieu:int)->float:"""
Recherche la somme maximale entre les deux
sous-tableaux du tableau tab à partir du milieu.
"""# Sous-tableau gauchegmax=0somme=0foriinrange(milieu,-1,-1):somme+=tab[i]gmax=max(gmax,somme)# Sous-tableau droitdmax=0somme=0foriinrange(milieu+1,len(tab)):somme+=tab[i]dmax=max(dmax,somme)returngmax+dmax
Quelle est la complexité de la fonction somme_max ?
Physique, Chimie et Informatique > Terminales Spé. NSI > Méthode « Diviser pour régner »
Dans ce document on introduit une méthode permettant d’évaluer numériquement une solution de l’équation f(x)=0, avec f une fonction de R dans R (lorsque la solution existe, bien sur) : la méthode de dichotomie.
La méthode de dichotomie est efficace et converge relativement vite. De plus, les conditions de son utilisation sont assez simples : la fonction f doit seulement être continue et changer de signe sur l’intervalle choisi ;
La méthode de Newtonconverge étonnement vite ! Les conditions de son utilisation sont cependant plus contraignantes : la fonction fdoit être dérivable.
Méthode de la dichotomie
Le raisonnement à mettre en œuvre s’appuie sur le théorème des valeurs intermédiaires.
Théorème des valeurs intermédiaires
Soit f:[a,b]→R une fonction continue sur un segment. Si f(a)⋅f(b)⩽0, alors il existe ℓ∈[a,b] tel que f(ℓ)=0.
Principe de résolution du problème
Info
On choisit un intervalle [a,b] dans lequel on pense que la fonction f s’annule une seule fois (il peut donc être nécessaire de limiter la largeur de cet intervalle).
Étape 1. On détermine les coordonnées du point milieu de l’intervalle : 2a+b
Si f(a)⋅f(2a+b)⩽0, le théorème des valeurs intermédiaires permet de conclure qu’il existe un point c∈[a,2a+b] tel que f(c)=0.
Si f(a)⋅f(2a+b)⩾0, le théorème des valeurs intermédiaires permet de conclure qu’il existe un point c∈[2a+b,b] tel que f(c)=0.
On est donc parvenu, à l’issu de cette étape, à définir un intervalle dans lequel f(x)=0, de longueur moitié par rapport à l’intervalle initial.
Étape suivante. On répète le processus mis en œuvre dans l’Étape 1 pour l’intervalle [a,2a+b] ou [2a+b,b].
Étapes suivantes. On continue à répéter le processus jusqu’à ce que l’intervalle soit de longueur inférieure à une longueur choisie (arbitrairement).
La méthode converge-t-elle réellement ?
On construit deux suites (an) et (bn) qui évoluent comme les bornes de l’intervalle, et la suite (xn), zéro de f pour chaque intervalle.
Au rang 0. On pose a0=a, b0=b. Comme f(a)⋅f(b)⩽0, il existe une solution, notée x0, de l’équation f(x)=0 dans l’intervalle [a0,b0].
Au rang 1. Si f(a0)⋅f(2a0+b0)⩽0, alors on pose a1=a0 et b1=2a0+b0, sinon on pose a1=2a0+b0 et b1=b0.
Comme f(a1)⋅f(b1)⩽0, il existe une solution, notée x1, de l’équation f(x)=0 dans l’intervalle [a1,b1].
Au rang n. On suppose construit un intervalle [an,bn], de longueur 2nbn−an, contenant une solution xn de l’équation f(x)=0.
Si f(an)⋅f(2an+bn)⩽0, alors on pose an+1=an et bn+1=2an+bn, sinon on pose an+1=2an+bn et bn+1=bn. Comme f(an+1)⋅f(bn+1)⩽0, il existe une solution, notée xn+1, de l’équation f(x)=0 dans l’intervalle [an+1,bn+1].
Étude des suites construites
Par construction :
- an⩽xn⩽bn
- (an) est une suite croissante, (bn) une suite décroissante.
La limite de (bn−an) tend donc vers 0 lorsque n tend vers +∞ :
lim(bn−an)n→+∞0
Les suites (an) et (bn) sont adjacentes. Elles admettent donc une même limite, ℓ.
Par application du théorème des gendarmes, on peut aussi en conclure que
lim(xn)n→+∞ℓ
et, comme f est une fonction continue,
f(ℓ)=n→+∞limf(xn)=n→+∞lim0=0
En conclusion, les suites (an) et (bn) tendent vers la valeur ℓ, solution de f(x)=0.
Remarque
En pratique, on arrête le processus dès que bn−an=2nb−a
est inférieur à la précision souhaitée.
Exemple : Approximation de 10
On définit la fonction f définie par f(x)=x2−10. f est
une fonction continue sur R qui s’annule en 10 et −10.
On limite l’étude à l’intervalle [3;4] puisque : f(3)=32−10=−1<0 et f(4)=42−10=6>0 entraîne 10∈[3;4].
On écrit le processus itératif :
On pose a0=3 et b0=4. f(a0)⩽0 et f(b0)⩾0.
2a0+b0=3,5 donc f(2a0+b0)=f(3,5)=3,52−10=2,25⩾0.
f(a0)⋅f(2a0+b0)⩽0, on en
déduit que 10 est dans l’intervalle [3;3,5].
On pose a1=3 et b1=3,5.
2a1+b1=3,25 donc f(2a1+b1)=f(3,25)=0,5625⩾0.
f(a1)⋅f(2a1+b1)⩽0, on en
déduit que 10 est dans l’intervalle [3;3,25].
On pose a2=3 et b2=3,25.
2a2+b2=3,125 donc f(2a2+b2)=f(3,125)=−0,23⋅⋅⋅⩽0.
f(b2)⩾0, f s’annule sur l’intervalle [3,125;3,25].
À ce stade, on a donc démontré que : 3,125⩽10⩽3,25.
Avec quelques étapes de plus, on obtient :
a0=3
b0=4
a1=3
b1=3,5
a2=3
b2=3,25
a3=3,125
b3=3,25
a4=3,125
b4=3,1875
a5=3,15625
b5=3,1875
a6=3,15625
b6=3,171875
a7=3,15625
b7=3,164062
a8=3,16015
b8=3,164062
En 8 étapes, on obtient donc l’encadrement :
3,160⩽10⩽3,165
ce qui donne les deux premières décimales du résultat.
Nombre d’itérations nécessaires pour atteindre un résultat
La longueur de l’intervalle [an,bn] est 2nb−a puisqu’il a
été nécessaire de découper n fois l’intervalle de départ en deux pour
parvenir à cet intervalle.
On peut alors rechercher le nombre d’itérations nécessaires pour
atteindre une précision choisie lors de la phase préliminaire de l’étude ; il suffit de rechercher le nombre n tel que 2nb−a⩽10−N :
L’objectif de cette activité est l’écriture d’une fonction qui effectue la rotation d’une image bitmap de 90 degrés en utilisant le principe « Diviser pour régner ».
On peut manipuler des images en Python à l’aide du module PIL (Python Image Library). Une première partie de l’activité est consacrée à la prise en main de ce module. Dans un second temps, la fonction de manipulation des bits est développée.
Images numériques
Définition
L’image matricielle
Une image matricielle, ou « carte de points » (de l’anglais « bitmap »), est une image constituée d’une matrice de points colorés, c’est-à-dire, constituée d’un tableau, d’une grille, où chaque case possède une couleur qui lui est propre et est considérée comme un point. Il s’agit donc d’une juxtaposition de points de couleurs formant, dans leur ensemble, une image.
Le codage ou la représentation informatique d’une image implique sa numérisation. Cette numérisation se fait dans deux espaces :
l’espace spatial dans lequel l’image est numérisée suivant l’axe des abscisses et l’axe des ordonnées : on parle d’échantillonnage. Les échantillons dans cet espace sont nommés pixels (« picture element ») et leur nombre va constituer la définition de l’image.
l’espace des couleurs dans lequel les différentes valeurs de luminosité que peut prendre un pixel sont numérisées pour représenter sa couleur et son intensité ; on parle de quantification. La précision dans cet espace dépend du nombre de bits sur lesquels on code la luminosité et est appelée profondeur de l’image.
À retenir
La qualité d’une image matricielle est déterminée par le nombre total de pixels et la quantité d’information contenue dans chaque pixel (souvent appelée profondeur de numérisation des couleurs).
Définition d’une image
On appelle définition le nombre de points (pixels) constituant une image: c’est le nombre de colonnes de l’image que multiplie son nombre de lignes.
La définition d’une image indique donc le niveau de détails qui seront visibles dans l’image. Pour une taille donnée, plus il y aura de pixels, plus il y aura de détails fins visibles.
Exemple. Une image numérisée avec une définition de 640×480 pixels (donc contenant 307 200 pixels) apparaîtra très approximative et sous forme d’un pavage de petits carrés de couleur, par comparaison à une image de 1280×1024 pixels (soit 1 310 720 pixels).
Résolution d’une image
On appelle résolution le nombre de points (pixels) contenus dans une longueur donnée, le pouce (un pouce mesure 2,54cm, c’est une unité de mesure britannique). Elle est exprimée en « points par pouce » (PPP) en français et « Dots Per Inch » (DPI) en anglais.
La résolution permet ainsi d’établir le rapport entre la définition d’une image et la dimension réelle de sa représentation sur un support physique (écran, papier, etc.)
En plus de sa définition, une image numérique utilise plus ou moins de mémoire selon le codage des informations de couleur qu’elle possède. C’est ce que l’on nomme le codage de couleurs ou profondeur des couleurs, exprimé en bits par pixel (bpp) : 1, 4, 8, 16, 24, … bits.
Le codage des informations de couleur est donc le nombre de bits utilisés pour coder une couleur.
Remarque
Les écrans utilisent la synthèse additive pour restituer les couleurs : chaque pixel est composé de trois sous-éléments munis respectivement d’un filtre : rouge, vert, bleu.
Quelques modes de représentation des couleurs
Mode bitmap (noir et blanc) : Avec ce mode, il est possible d’afficher uniquement des images en deux couleurs: noir et blanc. Il présente une profondeur de 1 bpp.
Mode niveau de gris : Avec ce mode, il est possible d’afficher des images utilisant 254 ou 65534 nuances de gris entre le blanc et le noir.
Le niveau de gris représente la luminosité d’un pixel, lorsque les valeurs de ses composantes de couleur sont identiques.
Pour convertir une image couleur en niveau de gris il faut remplacer, pour chaque pixel les trois valeurs représentant les niveaux de rouge, de vert et de bleu, en une seule valeur représentant la luminosité.
Il présente une profondeur de 8 bpp ou 16 bpp.
Mode RVB : Dans ce mode, la couleur de chaque pixel de l’image est codée à l’aide d’un triplet de valeurs pour le rouge, le vert et le bleu. Chaque canal peut être codé sur 8 bits (le plus fréquent) ou 16 bits (appareils de photo modernes).
Exploitation des documents
Déterminer la résolution d’une image de 300×300 pixels mesurant 2 pouces par coté.
Quelle serait la définition en pixels d’une feuille scannée d’une largeur de 8,5 pouces sur une hauteur de 11 pouces en 300 dpi ?
Quel est le poids, en octets, d’une image d’une définition de 640×480, codée sur 1 bit (image en « noir et blanc ») ? codée sur 8 bits (« niveau de gris ») ? codée sur 24 bits (« RVB ») ?
Pourquoi le mode « niveau de gris » divise-t-il par trois le nombre d’octets nécessaire au codage ?
Quelle particularité doivent présenter les sous-éléments de chaque pixel lors de l’affichage d’une image en « niveau de gris » ?
Déterminer le nombre de couleurs que l’on peut coder en mode RVB (8 bpp).
Manipulation d’une image en niveaux de gris avec Python
Étudier le code suivant, essayer de déterminer quel traitement effectue la fonction mystere et le tester.
importPIL.Imageaspidefmystere(im):"""
Cette fonction réalise un traitement qu'il faut deviner, sur
l'image dont l'objet qui la représente est passé en argument.
Paramètre
---------
im: PIL.Image.Image
Objet image
Retour
------
None
"""(largeur,hauteur)=(im.width,im.height)foryinrange(hauteur):forxinrange(largeur):niveau=im.getpixel((x,y))niveau=255-niveauim.putpixel((x,y),niveau)defmain():"""Fonction principale"""# Chemin de l'imageimage="tigrenb.png"# Création de l'objet imageim_nb=pi.open(image)# Visualisation du fichierim_nb.show()# Modification du fichiermystere(im_nb)# Visualisation des modificationsim_nb.show()main()
À partir de la fonction précédente, écrire une fonction nommée noir_et_blanc qui, en fonction d’un seuil s, transforme tous les pixels de valeur inférieure à s en 0 (noir) et tous les autres en 255 (blanc).
En modifiant les couleurs des pixels, il est possible de « dessiner » dans une image. Par exemple, on peut tracer une ligne horizontale blanche dans l’image.
Écrire la fonction ligne_blanche qui trace une ligne blanche horizontale au niveau de l’ordonnée y de l’image et le tester.
Écrire la fonction ligne, évolution de la fonction précédente, qui permet de tracer une ligne horizontale d’une « couleur », codée en niveau de gris, dont le niveau est passé en argument.
On veut maintenant pouvoir assombrir ou éclaircir des images. Pour assombrir une image, on décide de diviser par 2 le niveau de tous les pixels. À l’opposé, pour éclaircir une image, on décide de multiplier par 2 le niveau de tous les pixels, en prenant soin de ne pas dépasser la valeur maximale de 255 (on limite donc les valeurs supérieures à 255).
Écrire la fonction traitement qui réalise ces opérations (la fonction doit être capable d’éclaircir ou d’assombrir l’image).
Écrire la fonction grille qui trace une grille à l’écran. Cette fonction doit recevoir en argument le pas de la grille, la couleur des traits horizontaux et verticaux (en niveaux de gris) et l’objet image.
Manipulation d’une image en couleur avec Python
Étudier le code suivant.
fromPILimportImagedefrecuperation_niveaux(im:Image,pt:tuple)->None:"""
Récupère la couleur du pixel pt.
"""# On vérifie que le point est dans l'image(largeur,hauteur)=(im.width,im.height)ifpt[0]>(largeur-1)orpt[0]<0orpt[1]<0orpt[1]>(hauteur-1):raiseException("Le point indiqué n'est pas dans l'image.")# Récupération des niveaux de couleurtriplet=im.getpixel(pt)returntripletdefmodification_couleur(im:Image,pt:tuple,triplet:tuple)->None:"""
Attribue la couleur (triplet) au pixel pt.
"""# On vérifie que le point est dans l'image(largeur,hauteur)=(im.width,im.height)ifpt[0]>(largeur-1)orpt[0]<0orpt[1]<0orpt[1]>(hauteur-1):raiseException("Le point indiqué n'est pas dans l'image.")# Modification de la couleurim.putpixel(pt,triplet)defgrille(im:Image,pas:int,triplet:tuple)->None:"""
Trace une grille à l'écran, de pas 'pas' dont la couleur
est donnée par le triplet triplet.
"""passdefaugmentation_contraste(im:Image,offset:int)->None:"""
Augmente le contraste de l'image d'une valeur offset.
"""passdefteinte_plus_chaude(im:Image,offset:int)->None:passdefmain():"""Fonction principale."""nom_image="tigre.jpg"# Création de l'objet imageim=Image.open(nom_image)im.show()# Récupération des niveaux de couleurpt=(600,250)(rouge,vert,bleu)=recuperation_niveaux(im,pt)# Affichage du résultatprint("Au point {} : R : {}, V : {}, B : {}".format(pt,rouge,vert,bleu))main()
L’idée de l’algorithme consiste à découper l’image en quatre, à effectuer la rotation de 90 degrés de chacun des quatre morceaux, puis de les déplacer vers leur position finale.
Afin de pouvoir procéder récursivement, définir la fonction (et sa spécification !) rotation_aux(px, x, y, t) qui effectue la rotation de la portion carrée de l’image comprise entre les pixels (x,y) et (x+t,y+t). Cette fonction ne renvoie rien, elle modifie le tableau px pour effectuer la rotation de cette portion de l’image, au même endroit. On suppose que t est une puissance de 2.
Le code de cette fonction est :
Étudier ce code afin de bien le comprendre. En particulier, faire fonctionner à la main la fonction pour une image de définition 8×8.
En déduire la fonction rotation(px) qui effectue une rotation de l’image toute entière, sa dimension étant donnée par le paramètre taille.
Une fois la rotation effectuée, on pourra sauvegarder le résultat dans un autre fichier avec l’instruction im.save("Apres_rotation.png").
Physique, Chimie et Informatique > Terminales Spé. NSI > Méthode « Diviser pour régner »
L’objectif de ce document est d’écrire et d’implémenter un algorithme s’appuyant sur le raisonnement « Diviser pour régner » qui permet de déterminer la somme des n nombres (entiers) d’un tableau.
Écrire le code de fonction somme1 dont la spécification est :
defsomme1(tab:List[float])->float:"""
Calcul de la somme des nombres éléments
de tab.
Algorithme : Récursivité enveloppée
"""
Penser à écrire un jeu de tests.
Réponse
defsomme1(tab:List[float])->float:"""
Calcul de la somme des nombres éléments
de tab.
Algorithme : Récursivité enveloppée
"""iflen(tab)==1:returntab[0]returntab[0]+somme1(tab[1:])if__name__=="__main__":tab=[1,2,3,4,5,6,7]n=tab[len(tab)-1]assertsomme1(tab)==n*(n+1)//2print("Done!")
Réfléchir à un algorithme utilisant le principe « Diviser pour régner » qui résoud le même problème.
Écrire le code de la fonction somme2 qui implémente cet algorithme.
Tester cette fonction.
Réponse
defsomme2(tab:List[float])->float:"""
Calcul de la somme des nombres éléments
de tab.
Algorithme : Diviser pour Régner.
"""# Cas de baseiflen(tab)==1:returntab[0]# Diviserm=len(tab)//2somme_g=somme2(tab[:m])somme_d=somme2(tab[m:])# Régnertotal=somme_g+somme_d# Recombinerreturntotalif__name__=="__main__":tab=[1,2,3,4,5,6,7]n=tab[len(tab)-1]assertsomme1(tab)==n*(n+1)//2assertsomme2(tab)==n*(n+1)//2print("Done!")
Décrire le fonctionnement de l’algorithme pour la liste [1, 2, 3, 4, 5, 6, 7].
Réponse
Physique, Chimie et Informatique > Terminales Spé. NSI
Programmation dynamique
Au programme
Contenus
Capacités attendues
Commentaires
Programmation dynamique
Utiliser la programmation dynamique pour écrire un algorithme.
- Les exemples de l’alignement de séquences ou du rendu de monnaie peuvent être présentés. - La discussion sur le coût en mémoire peut être développée.
Définir la fonction fact_env qui calcule la factorielle d’un entier naturel n, sans oublier le jeu de tests.
La spécification de la fonction est :
deffact_env(n:int)->int:"""
Retourne la factorielle de n.
Algorithme : récursivité enveloppée
"""
Réponse
deffact_env(n:int)->int:"""
Retourne la factorielle de n.
Algorithme : récursivité enveloppée
"""ifn==0:return1returnn*fact_env(n-1)if__name__=="__main__":assertfact_env(0)==1assertfact_env(1)==1assertfact_env(5)==120assertfact_env(8)==40320
Info
En informatique, la récursion terminale, aussi appelée, récursion finale, est un cas particulier de récursivité assimilée à une itération.
Une fonction à récursivité terminale (dite tail-recursive en anglais) est une fonction où l’appel récursif est la dernière instruction à être évaluée. Cette instruction est alors nécessairement « pure », c’est-à-dire qu’elle consiste en un simple appel à la fonction, et jamais à un calcul ou une composition.
Les algorithmes récursifs exprimés à l’aide de fonctions à récursion terminale profitent donc d’une optimisation de la pile d’exécution.
Cette réorganisation économise de l’espace mémoire car aucun état, sauf l’adresse de la fonction appelante, n’a besoin d’être sauvé sur la pile d’exécution. Cela signifie également que le programmeur n’a pas à craindre l’épuisement de l’espace de pile ou du tas pour des récursions très profondes.
Wikipedia
Définir la fonction fact_term qui calcule la factorielle d’un entier naturel n, sans oublier le jeu de tests.
La spécification de la fonction est :
deffact_term(n:int)->int:"""
Retourne la factorielle de n.
Algorithme : récursivité terminale
"""
La fonction fact_term est en fait une fonction enveloppe de la fonction _fact dont la spécification est :
def_fact(n:int,acc:int=1)->int:"""
Fonction qui effectue réellement le calcul récursif.
"""
La fonction _fact met en œuvre un raisonnement basé sur la récursivité terminale.
Réponse
deffact_term(n:int)->int:"""
Retourne la factorielle de n.
Algorithme : récursivité terminale
"""def_fact(n:int,acc:int=1)->int:"""
Fonction qui effectue réellement le calcul récursif.
"""ifn==0:returnaccreturn_fact(n-1,acc*n)return_fact(n,1)if__name__=="__main__":assertfact_term(0)==1assertfact_term(1)==1assertfact_term(5)==120assertfact_term(8)==40320
Autour de la suite de Fibonacci
En mathématiques, la suite de Fibonacci est une suite d’entiers dans laquelle chaque terme est la somme des deux termes qui le précèdent. Elle commence par les termes 0 et 1 si on part de l’indice 0, ou par 1 et 1 si on part de l’indice 1.
Fn=⎩⎨⎧F0=0F1=1Fn=Fn−1+Fn−2
Résolutions du problème sans programmation dynamique
Définir la fonction fibo_iter qui calcule le terme de rang n de la suite de Fibonacci, sans oublier le jeu de tests. Le raisonnement mis en œuvre doit être itératif.
La spécification de la fonction est :
deffibo_iter(n:int)->int:"""
Retourne le terme de rang n de la suite de Fibonacci.
Algorithme : itératif
"""
Réponse
deffibo_iter(n:int)->int:"""
Retourne le terme de rang n de la suite de Fibonacci.
Algorithme : itératif
"""u=0v=1foriinrange(2,n+1):w=u+vu=vv=wifn==0:return0else:returnvif__name__=="__main__":# fibo_iterassertfibo_iter(0)==0assertfibo_iter(1)==1assertfibo_iter(10)==55assertfibo_iter(16)==987
Quelle est la complexité de l’algorithme itératif ?
Réponse
L’algorithme comporte une boucle, la complexité est donc en O(n).
Définir la fonction fibo_head qui calcule le terme de rang n de la suite de Fibonacci, sans oublier le jeu de tests. Le raisonnement mis en œuvre doit être récursif.
La spécification de la fonction est :
deffibo_head(n:int)->int:"""
Retourne le terme de rang n de la suite de Fibonacci.
Algorithme : récursif (enveloppé)
"""
Réponse
deffibo_head(n:int)->int:"""
Retourne le terme de rang n de la suite de Fibonacci.
Algorithme : récursif (enveloppé)
"""ifn==0:return0elifn==1:return1fibo1=fibo_head(n-1)fibo2=fibo_head(n-2)returnfibo1+fibo2if__name__=="__main__":assertfibo_head(0)==0assertfibo_head(1)==1assertfibo_head(10)==55assertfibo_head(16)==987
Écrire l’arbre des appels récursifs pour n=5. En déduire la complexité de l’algorithme récursif.
Quelle est la raison d’une telle complexité ?
Réponse
Les mêmes calculs sont effectués plusieurs fois.
La hauteur de l’arbre des appels est égale à n−1.
Si chaque étape est en O(1), le nombre de calculs effectués est donc 20+21+22+23+…+2n−1=2n.
La complexité est donc en O(2n).
En prenant pour exemple la définition de la fonction à la question 2. et l’algorithme itératif, à la question 3., définir la fonction fib_tail qui calcule le terme de rang n de la suite de Fibonacci à l’aide d’un algorithme récursif terminal.
La spécification de la fonction fib_tail est :
deffibo_tail(n:int)->int:"""
Retourne le terme de rang n de la suite de Fibonacci.
Algorithme : récursif (terminale)
"""
La fonction fib_tail est en fait une fonction enveloppe de la fonction _fibo dont la spécification est :
def_fibo(n:int,a:int=0,b:int=1)->int:"""
Fonction qui effectue réellement le calcul récursif.
"""
Réponse
deffibo_tail(n:int)->int:"""
Retourne le terme de rang n de la suite de Fibonacci.
Algorithme : récursif (terminale)
"""def_fibo_tail(n:int,a:int=0,b:int=1):ifn==0:returnaelifn==1:returnbreturn_fibo_tail(n-1,b,a+b)return_fibo_tail(n)if__name__=="__main__":assertfibo_tail(0)==0assertfibo_tail(1)==1assertfibo_tail(10)==55assertfibo_tail(16)==987
Quelle est la complexité de cet algorithme ?
Réponse
La complexité de l’algorithme récursif terminal, en nombre d’additions, est donnée par la récurrence T(n)=1+T(n−1). On a donc T(n)=n−1 pour _fibo_tail, et par extension pour fibo_tail.
Programmation dynamique
À retenir
En informatique, la programmation dynamique est une méthode algorithmique pour résoudre des problèmes d’optimisation. Le concept a été introduit au début des années 1950 par Richard Bellman.
La programmation dynamique consiste à résoudre un problème en le décomposant en sous-problèmes, puis à résoudre les sous-problèmes, des plus petits aux plus grands en stockant les résultats intermédiaires.
La programmation dynamique s’appuie sur le principe d’optimalité de Bellman : une solution optimale d’un problème s’obtient en combinant des solutions optimales à des sous-problèmes.
La méthode de programmation dynamique, comme la méthode diviser pour régner, résout des problèmes en combinant des solutions de sous-problèmes. Les algorithmes diviser-pour-régner partitionnent le problème en sous-problèmes indépendants qu’ils résolvent récursivement, puis combinent leurs solutions pour résoudre le problème initial. La méthode diviser-pour-régner est inefficace si on doit résoudre plusieurs fois le même sous-problème.
Info
La programmation dynamique est utilisée pour résoudre des problèmes d’optimisation.
La conception d’un algorithme de programmation dynamique est typiquement découpée en quatre étapes :
Caractériser la structure d’une solution optimale.
Définir (souvent de manière récursive) la valeur d’une solution optimale.
Calculer la valeur d’une solution optimale.
Construire une solution optimale à partir des informations calculées.
La dernière étape est utile pour calculer une solution optimale, et pas seulement la valeur optimale. Un problème d’optimisation peut avoir de nombreuses solutions. Chaque solution a une valeur, et on souhaite trouver une solution ayant la valeur optimale. Une telle solution optimale au problème n’est pas forcément unique, c’est sa valeur qui l’est.
Dans le cas du calcul du terme de rang n de la suite de Fibonacci à l’aide d’un raisonnement récursif, le problème a pour origine les multiples calculs de chacun des sous-termes nécessaires. La programmation dynamique consiste alors à stocker les valeurs des sous-problèmes pour éviter les recalculs.
À retenir
Il existe alors deux méthodes pour calculer effectivement une solution : la méthode ascendante (Bottom-up approach) et la méthode descendante (Top-down approach).
Dans la méthode ascendante, on commence par calculer des solutions pour les sous-problèmes les plus petits, puis, de proche en proche, on calcule les solutions des problèmes en utilisant le principe d’optimalité et on mémorise les résultats dans un tableau ou un dictionnaire F.
Dans la méthode descendante, on écrit un algorithme récursif mais on utilise la mémoïsation pour ne pas résoudre plusieurs fois le même problème, c’est-à-dire que l’on stocke dans un tableau ou un dictionnaire F les résultats des appels récursifs.
Info
Une fonction mémoïséestocke les valeurs renvoyées par ses appels précédents dans une structure de données adaptée et, lorsqu’elle est appelée à nouveau avec les mêmes paramètres, renvoie la valeur stockée au lieu de la recalculer. Une fonction peut être mémoïsée seulement si elle est pure, c’est-à-dire si sa valeur de retour ne dépend que de la valeur de ses arguments, sans effet de bord. En ce cas, la transparence référentielle permet de remplacer l’appel de la fonction directement par sa valeur. À la différence d’une fonction tabulée, où la table est statique, une fonction mémoïsée repose sur une table dynamique remplie à la volée.
La mémoïsation est une façon de diminuer le temps de calcul d’une fonction, au prix d’une occupation mémoire plus importante. La mémoïsation modifie donc la complexité d’une fonction, en temps comme en espace.
Résolutions du problème à l’aide de la programmation dynamique
Quel est l’intérêt des structures de données tableau ou dictionnaire pour le stockage des valeurs des sous-problèmes ?
Écrire l’arbre des appels récursifs pour n=5, lorsque la technique de mémoïsation est mise en œuvre. Le comparer à l’arbre obtenu à la question 6.
Réponse
Définir la fonction fibo_memo qui calcule le terme de rang n de la suite de Fibonacci, sans oublier le jeu de tests. Le raisonnement doit être récursif et mettre en œuvre la technique de mémoïsation (méthode descendante).
Réponse
deffibo_memo1(n:int)->int:"""
Version mémoïsée de Fibonacci.
Utilisation d'un dictionnaire et d'une fonction
enveloppe.
"""dic={0:0,1:1}def_fibo(n:int,dic:"dict[int: int]")->int:ifnindic.keys():returndic[n]else:dic[n]=_fibo(n-1,dic)+_fibo(n-2,dic)returndic[n]return_fibo(n,dic)
ou
deffibo_memo2(n:int,tab:list[int]=[0,1])->int:"""
Version mémoïsée de Fibonacci.
Utilisation d'une liste.
"""ifn<len(tab):returntab[n]calcul=fibo_memo2(n-1,tab)+fibo_memo2(n-2,tab)tab.append(calcul)returncalcul
Quelle est la complexité de l’algorithme avec mémoïsation ?
Réponse
Définir la fonction fibo_up qui calcule le terme de rang n de la suite de Fibonacci, sans oublier le jeu de tests. Le raisonnement doit mettre en œuvre la méthode ascendante du problème.
Réponse
deffibo_up(n:int)->int:"""
Retourne la valeur de rang n de la suite de Fibonacci.
Version itérative avec stockage des valeurs dans une liste.
"""tab=[0,1]foriinrange(2,n+1):valeur=tab[i-2]+tab[i-1]tab.append(valeur)returntab[n]
Application : nombre de façon d’atteindre la nième marche d’un escalier
On cherche le nombre de méthodes différentes qui permettent d’atteindre la nième marche d’un escalier, sachant que l’on peut monter un, deux ou trois marches à la fois.
Déterminer la relation de récurrence, sachant que l’on note un le nombre de méthodes permettant d’atteindre la nième marche.
Réponse
un=⎩⎨⎧u1u2u3un=1=2=4=un−1+un−2+un−3
Quel est l’écueil à éviter lorsqu’on programme le calcul du n-ième terme de la suite précédente de manière récursive ?
Réponse
Il faut éviter que les appels récursifs calculent plusieurs fois les mêmes valeurs.
Proposer une version itérative du calcul de un.
defnbre_methodes_iter(n:int)->int:"""
Calcul du nombre de méthodes différentes pour
accéder à la nième marche d'un escalier.
Version itérative.
"""
Réponse
defnbre_methodes_iter(n:int)->int:"""
Calcul du nombre de méthodes différentes pour
accéder à la nième marche d'un escalier.
Version itérative.
"""u,v,w=1,2,4foriinrange(4,n+1):z=u+v+wu=vv=ww=zifn==1:return1elifn==2:return2elifn==3:return4else:returnw
Proposer une version récursive du calcul de un.
defnbre_methodes_rec(n:int)->int:"""
Calcul du nombre de méthodes différentes pour
accéder à la nième marche d'un escalier.
Version récursive.
"""
Réponse
defnbre_methodes_rec(n:int)->int:"""
Calcul du nombre de méthodes différentes pour
accéder à la nième marche d'un escalier.
Version récursive.
"""ifn==1:return1elifn==2:return2elifn==3:return4return(nbre_methodes_rec(n-1)+nbre_methodes_rec(n-2)+nbre_methodes_rec(n-3))
Proposer une version récursive efficace du calcul de un qui utilise la mémoïsation.
defnbre_methodes_memo(n:int)->int:"""
Calcul du nombre de méthodes différentes pour
accéder à la nième marche d'un escalier.
Version qui utilise la mémoïsation.
"""
Réponse
defnbre_methodes_memo(n:int)->int:"""
Calcul du nombre de méthodes différentes pour
accéder à la nième marche d'un escalier.
Version qui utilise la mémoïsation.
"""memo={1:1,2:2,3:4}def_nbre(n:int)->int:ifninmemo.keys():returnmemo[n]else:memo[n]=_nbre(n-1)+_nbre(n-2)+_nbre(n-3)returnmemo[n]return_nbre(n)
Un commerçant cherche à rendre la monnaie à ses clients de façon optimale, c’est-à-dire avec le nombre minimal de pièces et de billets.
Dans ce problème,
On suppose que les clients ne donnent que des sommes entières en euros (pas de centimes pour simplifier) ;
Les valeurs des pièces et billets à disposition sont : 1, 2, 5, 10, 20, 50, 100, 200 et 500. On suppose que l’on a autant d’exemplaires que nécessaire de chaque pièce et billet ;
Dans la suite, afin de simplifier, on désigne par « pièces » à la fois les pièces et les billets.
Algorithme glouton
Un client nous achète un objet qui coûte 53 euros. Il paye avec un billet de 200 euros. Il faut donc lui rendre 147 euros, par exemple un billet de 100, deux billets de 20, un billet de 5 et une pièce de 2.
Afin de minimiser le nombre de pièces à rendre, on peut suivre la stratégie suivante :
On commence par rendre la pièce de plus grande valeur possible ;
On déduit cette valeur de la somme (encore) à rendre ;
On recommence, jusqu’à obtenir une somme nulle.
En procédant ainsi, on résout le problème étape par étape et un choix optimal est effectué à chacune de ces étapes (la pièce de plus grande valeur). Cet algorithme fait parti de la catégorie des algorithmes gloutons : chercher la solution optimale à partir d’optima locaux.
Préparer le code suivant et étudier sa structure :
if__name__=="__main__":# valeurs des piècespieces=[1,2,5,10,20,50,100]prix=int(input("Quel est le prix ? "))client=int(input("Combien le client donne-t-il ? "))a_rendre=somme_a_rendre(prix,client)comment=pieces_a_rendre(a_rendre,pieces)reponse=[f"{comment[i]} piece(s) de {pieces[i]}"foriinrange(len(pieces))]print(f"Je dois rendre : {a_rendre}")print(f"Je donne donc : {reponse}")
Définir la fonction somme_a_rendre dont la spécification est :
defsomme_a_rendre(prix:int,montant_client:int)->int:"""
Détermine la somme à rendre à partir du prix et du montant donné par
le client.
"""
Réponse
defsomme_a_rendre(prix:int,montant_client:int)->int:"""
Détermine la somme à rendre à partir du prix et
du montant donné par le client.
"""returnmontant_client-prix
Définir la fonction pieces_a_rendre dont la spécification est :
defpieces_a_rendre(somme:int,pieces:list[int])->list[int]:"""
Détermine les pièces (et leur nombre) à choisir pour rendre la somme
passée en argument.
Utilise la division euclidienne et le modulo de façon à pouvoir
traiter tous les cas.
"""
Réponse
defpieces_a_rendre(somme:int,pieces:list[int])->list[int]:"""
Détermine les pièces (et leur nombre) à choisir
pour rendre la somme passée en argument.
Utilise la division euclidienne et le modulo de
façon à pouvoir traiter tous les cas.
On reçoit : pieces = [1, 2, 5, 10, 20]
On retourne : a_rendre = [x, z, y, a, b]
"""a_rendre=[]foriinrange(len(pieces)-1,-1,-1):nbre=somme//pieces[i]somme=somme%pieces[i]a_rendre.append(nbre)returnlist(reversed(a_rendre))defpieces_a_rendre_2(somme:int,pieces:list[int]):a_rendre={}i=len(pieces)-1whilesomme>0:nbre=somme//pieces[i]somme=somme%pieces[i]a_rendre[pieces[i]]=nbrei=i-1returna_rendredefpieces_a_rendre_3(somme:int,pieces:list[int])->list[int]:a_rendre=[0]*len(pieces)i=len(pieces)-1whilesomme>0:nbre=somme//pieces[i]somme=somme%pieces[i]a_rendre[i]=nbrei=i-1returnlist(reversed(a_rendre))
On note nb le nombre de pièces à rendre, prises dans la liste des pièces p=[1,2,5,10,20,50,100,200,500], lorsque la somme à rendre est x.
Écrire la relation de récurrence que doit vérifier nb.
Réponse
nb(x)={01+nb(x−p[i]) si x=0 si x−p[i]⩾0
En fait, on cherche le nombre minimal de pièces à rendre pour la somme x.
Adapter la relation de récurrence.
Réponse
nb(x)={01+min(nb(x−p[i])) si x=0 si x−p[i]⩾0 et i∈[0,len(p)[
Écrire le schéma des appels récursifs pour x=11 et p=[2,5,10].
Réponse
Indiquer l’avantage et l’inconvénient de l’algorithme par Brute Force.
Réponse
Cet algorithme retourne une solution optimale mais calcule plusieurs fois les mêmes valeurs. Il est donc inutilisable si la valeur à retourner est importante.
Réfléchir au code de la fonction dont la spécification est :
defnb_rendre(a_rendre:int,pieces:list[int])->int:"""
Détermine le nombre minimal de pièces
à rendre.
Algorithme récursif.
"""
Écrire le code de cette fonction.
Réponse
defnb_rendre(a_rendre:int,pieces:list[int])->int:"""
Détermine le nombre minimal de pièces
à rendre.
Algorithme récursif.
"""ifa_rendre==0:return0nb_min=float("inf")foriinrange(len(pieces)):ifpieces[i]<=a_rendre:nb=1+nb_rendre(a_rendre-pieces[i],pieces)ifnb<=nb_min:nb_min=nbreturnnb_min
Tester le code pour une somme à rendre de 13 puis de 130. Le résultat confirme-t-il la réponse à la question 4 ?
On souhaite maintenant écrire le code de la fonction pieces_a_rendre dont la spécification est :
defpieces_a_rendre(somme:int,pieces:tuple[int],serie:list[int],series:list[Tuple[int]])->None:"""
Détermine toutes les combinaisons de pièces qui permettent de rendre la somme somme.
pieces est le tuple des pièces disponibles.
series est la liste des pièces à rendre.
series est la liste des listes des pièces à rendre.
"""
Remarque
On peut bien sur créer une fonction enveloppe qui ne prendrait que la somme et la liste des pièces disponibles en argument et retournerait la liste des listes de pièces.
Réponse
defpieces_a_rendre(somme:int,pieces:tuple[int],serie:list[int],series:list[Tuple[int]])->None:"""
Détermine toutes les combinaisons de pièces qui permettent de rendre la somme somme.
"""ifsomme==0:series.append(serie)returnNoneforpieceinpieces:ifpiece>somme:continue# Sauvegarde de la liste des pièces pour le retour arrièreserie_sauv=list(serie)serie.append(piece)pieces_a_rendre(somme-piece,pieces,serie,series)serie=serie_sauv
Tester le code pour une somme à rendre de 13 puis de 130. Obtient-on rapidement un résultat pour cette dernière valeur ?
Comment déterminer le nombre minimum de pièces à retourner ?
Réponse
Le nombre minimum de pièces est égal à la plus petite longueur des listes éléments de la liste series.
Programmation dynamique (mémoïsation)
Rappeler quel est l’objectif de la programmation dynamique.
Réponse
À retenir
La programmation dynamique, comme la méthode diviser-pour-régner, résout des problèmes en combinant des solutions de sous-problèmes.
Les algorithmes diviser-pour-régner partitionnent le problème en sous-problèmes indépendants qu’ils résolvent récursivement, puis combinent leurs solutions pour résoudre le problème initial.
La programmation dynamique, quant à elle, peut s’appliquer même lorsque les sous-problèmes ne sont pas indépendants, c’est-à-dire lorsque des sous-problèmes ont des sous-sous-problèmes communs.
Dans ce cas, un algorithme diviser-pour-régner fait plus de travail que nécessaire, en résolvant plusieurs fois le sous-sous-problème commun. Un algorithme de programmation dynamique résout chaque sous-sous-problème une seule fois et mémorise sa réponse dans un tableau, évitant ainsi le recalcul de la solution chaque fois que le sous-sous-problème est rencontré.
La programmation dynamique est, en général, appliquée aux problèmes d’optimisation. Dans ce type de problèmes, il peut y avoir de nombreuses solutions possibles. Chaque solution a une valeur, et on souhaite trouver une solution ayant la valeur optimale (minimale ou maximale). Une telle solution est une solution optimale au problème, et non pas la solution optimale, puisqu’il peut y avoir plusieurs solutions qui donnent la valeur optimale.
Le manque d’efficacité de la méthode force brute a pour origine les multiples calculs redondants. Mettre en œuvre la méthode de mémoïsation afin d’améliorer l’efficacité du code de la fonction nb_rendre.
Réponse
defnb_rendre(a_rendre:int,pieces:list[int])->int:"""
Détermine le nombre minimal de pièces
à rendre.
Algorithme récursif avec mémoïsation.
"""dic_a_rendre={0:0}def_nb_rendre(a_rendre:int,pieces:list[int],dic:dict[int,int])->int:"""
Version mémoïsée de la fonction nb_rendre.
"""ifa_rendrenotindic.keys():nb_min=float("inf")foriinrange(len(pieces)):ifpieces[i]<=a_rendre:nb=1+_nb_rendre(a_rendre-pieces[i],pieces,dic)ifnb<=nb_min:nb_min=nbdic[a_rendre]=nb_minreturndic[a_rendre]return_nb_rendre(a_rendre,pieces,dic_a_rendre)
Rappeler quel est l’objectif de la programmation dynamique.
Réponse
À retenir
La programmation dynamique, comme la méthode diviser-pour-régner, résout des problèmes en combinant des solutions de sous-problèmes.
Les algorithmes diviser-pour-régner partitionnent le problème en sous-problèmes indépendants qu’ils résolvent récursivement, puis combinent leurs solutions pour résoudre le problème initial.
La programmation dynamique, quant à elle, peut s’appliquer même lorsque les sous-problèmes ne sont pas indépendants, c’est-à-dire lorsque des sous-problèmes ont des sous-sous-problèmes communs.
Dans ce cas, un algorithme diviser-pour-régner fait plus de travail que nécessaire, en résolvant plusieurs fois le sous-sous-problème commun. Un algorithme de programmation dynamique résout chaque sous-sous-problème une seule fois et mémorise sa réponse dans un tableau, évitant ainsi le recalcul de la solution chaque fois que le sous-sous-problème est rencontré.
La programmation dynamique est, en général, appliquée aux problèmes d’optimisation. Dans ce type de problèmes, il peut y avoir de nombreuses solutions possibles. Chaque solution a une valeur, et on souhaite trouver une solution ayant la valeur optimale (minimale ou maximale). Une telle solution est une solution optimale au problème, et non pas la solution optimale, puisqu’il peut y avoir plusieurs solutions qui donnent la valeur optimale.
Le manque d’efficacité de la méthode force brute a pour origine les multiples calculs redondants. Mettre en œuvre la méthode de ascendante afin d’améliorer l’efficacité du code de la fonction nb_rendre.
Réponse
defnb_rendre(a_rendre:int,pieces:list[int])->int:"""
Détermine le nombre minimal de pièces
à rendre.
Algorithme itératif, méthode ascendante.
"""nbres=[float("inf")]*(a_rendre+1)# Tableau des valeursnbres[0]=0forsommeinrange(1,len(nbres)):forpieceinpieces:if(somme-piece)>=0:nbres[somme]=min(nbres[sommes],1+nbres[somme-piece])returnnbres[a_rendre]
En résumé
Rendu de monnaie - Nombre de pièces à rendre - Toutes les méthodes
"""
Les mille et unes façon de rendre la monnaie.
"""defglouton(somme:int,pieces:list[int])->int:"""
Retourne le nombre de pièces nécessaires pour
rendre la monnaie pour somme.
Méthode gloutonne, pièces est censé être trié
dans le sens décroissant.
"""nbre=0# nombre de pièces à rendreforpieceinpieces:nbre+=somme//piecesomme=somme%piecereturnnbredefforce_brute(somme:int,pieces:list[int])->int:"""
Retourne le nombre de pièces nécessaires pour
rendre la monnaie pour somme.
Méthode force brute.
"""ifsomme==0:return0nbre_min=float("inf")forpieceinpieces:ifsomme-piece>=0:nbre_new=1+force_brute(somme-piece,pieces)ifnbre_new<nbre_min:nbre_min=nbre_newreturnnbre_mindefmemoisation(somme:int,pieces:list[int],memo:dict[int,int]={0:0})->int:"""
Retourne le nombre de pièces nécessaires pour
rendre la monnaie pour somme.
Programmation dynamique : mémoïsation.
"""ifsommenotinmemo:nbre_min=float("inf")forpieceinpieces:ifsomme-piece>=0:nbre_new=1+memoisation(somme-piece,pieces,memo)ifnbre_new<nbre_min:nbre_min=nbre_newmemo[somme]=nbre_minreturnmemo[somme]deftabulaire(somme:int,pieces:list[int])->int:"""
Retourne le nombre de pièces nécessaires pour
rendre la monnaie pour somme.
Programmation dynamique : méthode tabulaire.
Fonction enveloppe.
"""nbre_pour_somme=[float("inf")foriinrange(somme+1)]nbre_pour_somme[0]=0def_tabulaire(somme:int,pieces:List[int],nbre_pour_somme):"""
Mise en œuvre de la méthode tabulaire.
"""forsomme_a_rendreinrange(1,somme+1):forpieceinpieces:ifsomme_a_rendre-piece>=0:nbre=1+nbre_pour_somme[somme_a_rendre-piece]ifnbre<nbre_pour_somme[somme_a_rendre]:nbre_pour_somme[somme_a_rendre]=nbrereturnnbre_pour_somme[somme]return_tabulaire(somme,pieces,nbre_pour_somme)if__name__=="__main__":somme_a_rendre=60pieces=[25,20,1]nbres_pieces=glouton(somme_a_rendre,pieces)print(f"Méthode gloutonne pour rendre {somme_a_rendre} : {nbres_pieces} pieces.")nbres_pieces=force_brute(somme_a_rendre,pieces)print(f"Méthode force-brute pour rendre {somme_a_rendre} : {nbres_pieces} pieces.")nbres_pieces=memoisation(somme_a_rendre,pieces)print(f"Méthode mémoïsation pour rendre {somme_a_rendre} : {nbres_pieces} pieces.")nbres_pieces=tabulaire(somme_a_rendre,pieces)print(f"Méthode tabulaire pour rendre {somme_a_rendre} : {nbres_pieces} pieces.")
Physique, Chimie et Informatique > Terminales Spé. NSI
Les réseaux
Protocoles de routage
Dans un réseau, les routeurs jouent un rôle essentiel dans la transmission des paquets sur internet : les paquets sont routés individuellement par des algorithmes. Les pertes logiques peuvent être compensées par des protocoles reposant sur des accusés de réception ou des demandes de renvoi, comme TCP.
Au programme
Contenus
Capacités attendues
Commentaire
Protocoles de routage.
Identifier, suivant le protocole de routage utilisé, la route empruntée par un paquet.
- En mode débranché, les tables de routage étant données, on se réfère au nombre de sauts (protocole RIP) ou au coût des routes (protocole OSPF). - Le lien avec les algorithmes de recherche de chemin sur un graphe est mis en évidence.
La protection des données sensibles échangées est au cœur d’internet. Les notions de chiffrement et de déchiffrement de paquets pour les communications sécurisées sont explicitées.
Au programme
Contenus
Capacités attendues
Commentaire
- Sécurisation des communications.
- Décrire les principes de chiffrement symétrique (clef partagée) et asymétrique (avec clef privée/clef publique). - Décrire l’échange d’une clef symétrique en utilisant un protocole asymétrique pour sécuriser une communication HTTPS.
- Les protocoles symétriques et asymétriques peuvent être illustrés en mode débranché, éventuellement avec description d’un chiffrement particulier. - La négociation de la méthode chiffrement du protocole SSL (Secure Sockets Layer) n’est pas abordée.
Réseau : ensemble d’équipements interconnectés (liaisons mais aussi protocoles).
Un internet : réseau informatique dont le protocole de routage/adressage est IP (Internet Protocol).
L’Internet : réseau des réseaux —plus grand réseau internet
Tous les réseaux internet ne font pas partie de l’Internet.
Le WEB (World Wide Web) est seulement une composante de l’Internet.
Structure d’un internet
Pour transmettre des données d’un équipement vers un autre, il faut envoyer un signal sur un support de communication. Il est cependant impossible de relier directement entre eux tous les équipements qui souhaiteraient interagir, surtout dans le cadre d’un réseau mondialisé. Le nombre de liaisons serait trop important et les liaisons seraient trop longues (affaiblissement physique du signal).
L’idée retenue consiste à faire communiquer des systèmes terminaux en les connectant à une infrastructure spécifique constituée de liens de communication (câbles, paires torsadées, câbles électriques, fibres optiques ou encore l’air pour des liaisons sans fil) et des équipements spécifiques pour relayer les données (points d’accès, modem, antennes relais, routeurs, commutateurs, etc.). Ces équipements interconnectés les uns aux autres permettent ainsi de diminuer le nombre de liaisons et leur distance et d’interconnecter tous les systèmes terminaux (ou hôtes).
Chaque type de lien de communication a des caractéristiques propres en termes de débit, bande passante, résistance aux interférences électromagnétiques, facilité d’installation, coût, etc.
Commutation de paquets
Info
La communication entre ordinateurs est basée sur la commutation de paquets :
Les messages sont découpés en paquets de taille limitée ;
Chaque paquet est envoyé indépendamment des autres.
Remarque : Nous reviendrons sur la commutation de paquets plus tard.
Les composants des réseaux
L’architecture réseau définit les éléments dans un réseau, c’est-à-dire les types de nœuds dans le réseau.
Un réseau internet est composé :
De concentrateurs (network hub) (matériel obsolète) ;
De points d’accès (Wifi) ;
De commutateurs (network switch) ;
De routeurs ;
De media de transport des signaux (câbles de cuivre, fibres optiques, air, )
De machines utilisateurs (stations, serveurs, téléphones, etc.).
Protocole de communication
Qu’est-ce qu’un protocole ?
Imaginons que nous souhaitions envoyer une lettre à un ami. Quelles sont les différentes étapes pour pouvoir faire parvenir une lettre par courrier postal ?
Un protocole de communication est un accord entre deux parties sur la manière de communiquer
Info
Un protocole de communication définit :
Le format des messages échangés ;
Comment les messages sont échangés.
Qu’est-ce que cela implique pour les réseaux de communications ?
Il est nécessaire de définir :
dans quel sens la communication s’effectue ;
comment on s’assure de sa fiabilité ;
comment le séquencement des messages doit être effectué ;
comment le contrôle des erreurs peut être effectué ;
quelle doit être la longueur du message ;
quelle est la vitesse de transmission ;
etc.
Architecture logique en couches
Info
L’échange d’informations entre deux ordinateurs est un processus complexe. On décompose la tâche de transmission des données en plusieurs sous-tâches indépendantes.
Remarque : chaque sous-tâche correspond à une couche dans l’architecture en couches.
Transmission des bits sur le support physique (spécification des connecteurs, détermination des caractéristiques électriques des circuits, etc.).
Couche « Liaison de données »
Transmission fiable de trames sur une connexion physique entre deux nœuds qui partagent un même support physique.
Couche « Réseau »
Transmission des paquets/datagrammes d’une source vers une destination en passant par plusieurs nœuds intermédiaires (adressage, routage, contrôle de congestion).
Couche « Transport »
Transmission de bout-en-bout des segments, avec fiabilité et efficacité (contrôle de flux, reprise sur erreur, optimisation).
Encapsulation des protocoles
Info
L’encapsulation, en informatique et spécifiquement pour les réseaux informatiques, est un procédé consistant À inclure les données d’un protocole dans un autre protocole.
Info
Lors d’une transmission, les données traversent chacune des couches au niveau de la machine émettrice. À chaque couche, une information est ajoutée au paquet de données, il s’agit d’un en-tête, ensemble d’informations qui garanti la transmission. Au niveau de la machine réceptrice, lors du passage dans chaque couche, l’en-tête est lu, puis supprimé. Ainsi À la réception, le message est dans son état originel.
À chaque niveau, le paquet de données change d’aspect, car on lui ajoute un en-tête, ainsi les appellations changent suivant les couches :
le paquet de données est appelé message au niveau de la couche application ;
le message est ensuite encapsulé sous forme de segment dans la couche transport ;
le segment, une fois encapsulé, prend le nom de paquet dans la couche réseau ;
enfin on parle de trame au niveau de la couche liaison ;
et de signal au niveau de la couche physique.
Adressage IP
Lorsque l’on veut établir une communication, il est indispensable de posséder trois informations :
Le nom de la machine distante,
son adresse,
la route à suivre pour y parvenir.
Le nom dit « qui » est l’hôte distant, l’adresse nous dit « où » il se trouve et la route « comment » on y parvient.
Info
Les adresses IP (version 4) sont standardisées sous forme d’un nombre de 32 bits (représenté sous forme de quatre entiers de huit bits, séparés par des points) qui permet à la fois l’identification de chaque hôte et du réseau auquel il appartient. Le choix des nombres composants une adresse IP n’est pas laissé au hasard, au contraire il fait l’objet d’une attention particulière notamment pour faciliter les opérations de routage.
Chaque adresse IP contient donc deux informations, une adresse de réseau et une adresse d’hôte. La combinaison des deux désigne de manière unique une machine et une seule sur l’Internet.
Remarque : la version IPv4 du protocole IP ne permet plus de définir un nombre d’adresses utilisables suffisant. Cette version est progressivement remplacée par la version IPv6 qui ne sera pas abordée ici.
Deux types d’adressage
Par classes
C’est l’adressage historique, il est toujours utilisé sur les réseaux privés mais a disparu dans les réseaux public car il engendre la perte d’un grand nombre d’adresses.
Classe
Nbre bits du masque de sous réseau
Nbre bits de l’adresse hôte
Adresses réseau
A
8 bits commençant obligatoirement par le bit 0
24 bits
1.0.0.0 à 126.0.0.0
B
16 bits commençant obligatoirement par les bits 10
16 bits
128.0.0.0 à 191.255.0.0
C
24 bits commençant obligatoirement par les bits 110
8 bits
192.0.0.0 à 223.255.255.0
D
Non défini
Non défini
224.0.0.0 à 239.255.255.0
E
Non défini
Non défini
240.0.0.0 à 255.255.255.0
Remarques
L’adresse réseau 0.0.0.0 n’existe pas ;
Le NetID « 127 » est réservée pour les communications en boucle locale (loopback) ;
La classe D est prévue pour faire du « multicast » ou multipoint.
La classe E est une classe expérimentale.
Deux adresses hôtes ne sont pas attribuables :
tous les bits de la partie hôte à 1 : c’est l’adresse de diffusion ;
tous les bits de la partie hôte à 0 : c’est l’adresse du réseau.
Calculer le nombre de réseaux différents que l’on peut définir en fonction des classes.
Réponse
Classe A : 27=128. Le premier bit est fixé 0, on ne peut donc modifier que les sept bits suivants.
Classe B : 214=16384. Les deux premiers bits sont fixés à 10, on ne peut donc modifier que les 14 bits suivants.
Classe C : 221=209752. Les trois premiers bits sont fixés à 110, on ne peut donc modifier que les 21 bits suivants.
Calculer le nombre d’hôtes pour chaque réseau.
Réponse
Rappel : Deux configurations sont impossibles pour la partie hôte : tous les bits à 0 (adresse réseau) et tous les bits à 1 (adresse de diffusion).
Classe A : 224−2=16277214
Classe B : 216−2=65534
Classe C : 28−2=254
Sans classe (CIDR : classless interdomain routing)
Info
Le nombre de bits utilisés pour la partie réseau est accolé à l’adresse IP :
192.168.0.0/24
Comment différentier les bits utilisés pour la partie réseaux de ceux utilisés pour la partie hôte ?
Info
Un masque de sous-réseau est un masque distinguant les bits d’une adresse IPv4 utilisés pour identifier le sous-réseau de ceux utilisés pour identifier l’hôte.
L’adresse du sous-réseau est obtenue en appliquant l’opérateur ET binaire entre l’adresse IPv4 et le masque de sous-réseau.
L’adresse de l’hôte à l’intérieur du sous-réseau est quant à elle obtenue en appliquant l’opérateur ET entre l’adresse IPv4 et le complément à un du masque.
On utilise en pratique des masques constitués (sous leur forme binaire) d’une suite de 1 suivis d’une suite de 0 (il y a donc 32 masques réseau possibles).
Déterminer les adresses réseau et hôte à partir de l’adresse 192.168.1.2/24.
Réponse
Adresse hôte : soit on effectue un & logique avec le complément à 1 du masque, doit on cherche le nombre formé par les bits non retenus par la partie réseau.
L’adresse IPv4 d’un réseau est 192.168.56.0/24. Combien de bits sont-ils
dédiés à la partie réseau ? Combien de machines peut-on incorporer à ce
réseau ?
Réponse
24 bits sont réservés au réseau dans l’adresse. Une adresse IPv4 étant
composée de 32 bits, il reste 8 bits pour l’adressage des machines dans ce
réseau. Avec ces 8 bits on peut créer 28=256 adresses différentes, pour
28−2=254 ordinateurs.
Remarque : L’adresse avec tous les bits de la partie host positionnés à 0 est l’adresse du réseau et l’adresse avec tous les bits de la partie host positionnés à 1
est l’adresse de diffusion (broadcast).
Quel est le masque de réseau de l’adresse de la question 1 ?
Réponse
Masque : 255.255.255.0, traduction décimale de
11111111.11111111.11111111.00000000
Quelle est la première adresse utilisable sur le réseau de la question 1 ?
La dernière ?
Réponse
Première adresse (pour machine) : 192.168.56.1
Dernière adresse (pour machine) : 192.168.56.254.
Écrire l’adresse IPv4 222.1.1.20, de masque 255.255.255.192 en notation CIDR.
Réponse
192=(11000000)2, donc le masque s’écrit
11111111.11111111.11111111.11000000. 26 bits sont utilisés pour la partie
réseau. L’adresse s’écrit donc 222.1.1.20/26.
Écrire l’adresse IPv4 135.1.1.25, de masque 255.255.248.0 en notation CIDR.
Réponse
248=(11111000)2, donc le masque s’écrit
11111111.11111111.11111000.00000000. 21 bits sont utilisés pour la partie
réseau. L’adresse s’écrit donc 135.1.1.25/21.
Un fournisseur d’accès a alloué l’adresse réseau de classe C : 211.1.1.0 à
une compagnie. Cette dernière utilisant le masque réseau de la classe C :
255.255.255.0, combien d’ordinateurs peut-elle connecter au réseau ?
Réponse
Il reste 8 bits pour la partie hôte, donc 28−2=254 ordinateurs peuvent
être connectés au réseau.
Sur un ordinateur dont le système d’exploitation est Linux, la commande
ifconfig retourne l’adresse IPv4 172.16.20.234 et le masque 255.255.0.0.
Quelle est l’adresse réseau du réseau auquel cet ordinateur appartient ?
Réponse
Méthode pour déterminer l’adresse réseau :
Adresse :
10101100.00010000.00010100.11101010
&
Masque :
11111111.11111111.00000000.00000000
Réseau :
10101100.00010000.00000000.00000000
soit 172.16.0.0.
Combien d’ordinateurs peut-on incorporer au réseau de la question
précédente ?
Réponse
16 bits sont réservés à la partie host. On peut donc incorporer 216−2=65534 ordinateurs à ce réseau.
L’adresse IPv4 d’un ordinateur est 172.16.20.234/22. Combien d’ordinateurs
peut-on incorporer à ce réseau ?
Réponse
Il reste 10 bits pour la partie host, soit 210=1024 adresses. On peut
donc construire 1022 adresses utilisables pour des ordinateurs.
Quelle est la première adresse utilisable sur le réseau de la question
précédente ? La dernière ?
Réponse
La réponse à cette question nécessite tout d’abord de déterminer l’adresse
réseau :
Adresse :
10101100.00010000.00010100.11101010
&
Masque :
11111111.11111111.11111100.00000000
Réseau :
10101100.00010000.00010100.00000000
soit 172.16.20.0.
La première adresse utilisable est donc : 10101100.00010000.00010100.00000001, soit 172.16.20.01.
La dernière est : 10101100.00010000.00010111.11111110, soit 172.16.23.254.
Un fournisseur d’accès a alloué l’adresse réseau de classe A : 29.0.0.0 à
une compagnie. Cette dernière doit posséder au moins 20 sous-réseaux
comportant chacun au maximum 160 machines. Le responsable informatique hésite
entre les deux masques de réseau suivants pour l’adressage des sous-réseaux :
255.255.0.0 et 255.255.255.0. Ces masques conviennent-ils tous les deux ?
Réponse
Rappel : dans un réseau de classe A 8 bits sont réservés à la partie
réseau, le masque est donc 255.0.0.0.
Si le masque 255.255.0.0 est utilisé pour créer les sous-réseaux, les 8 bits réseau supplémentaires, par rapport au masque fourni par le fournisseur d’accès, permettent de créer 28=256 sous-réseaux et les 16 bits restants permettent d’intégrer 216−2=65534 machines.
Si le masque 255.255.255.0 est utilisé pour créer les sous-réseaux, les 16 bits réseau supplémentaires permettent de créer 216=65536 sous-réseaux et les 8 bits restants permettent d’intégrer 28−2=254 machines.
Les deux solutions envisagées conviennent donc.
Un fournisseur d’accès a alloué l’adresse réseau de classe B : 135.1.0.0 à
une compagnie. Cette dernière doit posséder 4 sous-réseaux comportant chacun
environ 200 machines. Déterminer le masque de réseau le plus simple
permettant de réaliser l’adressage attendu.
Réponse
Rappel : dans un réseau de classe B 16 bits sont réservés à la partie
réseau, le masque est donc 255.255.0.0.
Puisqu’il faut réserver environ 200 adresses pour les machines, 8 bits doivent être utilisés. Cela donne comme masque réseau 255.255.255.0.
À partir du masque précédent, on constate que 8 bits supplémentaire sont utilisés, par rapport au masque fourni par le fournisseur d’accès, pour les sous-réseaux. Comme 28=256>4, on peut donc bien créer les 4 sous-réseaux attendus. Le plus simple est
donc de choisir le masque : 255.255.255.0.
Un fournisseur d’accès a alloué l’adresse réseau de classe C : 205.11.2.0
à une compagnie qui doit créer 30 sous-réseaux. Quel masque de sous-réseau
permet de maximiser le nombre d’ordinateurs sur chaque sous-réseaux ?
Réponse
Le masque du réseau est : 255.255.255.0 puisqu’il s’agit d’un réseau de
classe C.
24=16 et 25=32. Il faut donc réserver 5 bits supplémentaires, pour la création des sous-réseaux. En réserver davantage diminuerait le nombre d’ordinateurs dans chacun des sous-réseaux. Le masque de sous-réseau à utiliser est donc 255.255.255.248 (les 5 bits de poids le plus importants sont positionnés à 1 : 11111111.11111111.11111111.11111000).
Combien d’ordinateurs pourront être connectés à chacun des sous-réseaux de
la question précédente ?
Réponse
Il reste 3 bits pour la partie hôte, donc 23−2=6 adresses pour des
ordinateurs.
Quelle sera l’adresse du troisième ordinateur du second
sous-réseau ?
Réponse
On applique le masque 11111111.11111111.11111111.11111000 à l’adresse de réseau 11001101.00001011.00000010.00000000.
Le premier sous-réseau a donc pour adresse 11001101.00001011.00000010.00001000 et celle du second sous réseau 11001101.00001011.00000010.00010000 soit 205.11.2.16.
L’adresse du troisième ordinateur est 11001101.00001011.00000010.00010011 soit 205.11.2.19.
Physique, Chimie et Informatique > Terminales Spé. NSI > Les réseaux
Cette séance nécessite l’utilisation du logiciel libre Wireshark. Des
versions pour Windows (il existe même une version portable qui n’a pas besoin
d’être installée), OS X et Linux sont téléchargeables à cette adresse :
https://www.wireshark.org
Rechercher pour quelles actions les protocoles http, pop3, ftp, telnet, ssh et dns sont utilisés.
Ces protocoles s’appuient-ils sur le protocole TCP ou le protocole UDP au niveau de
la couche transport du modèle OSI.
Utiliser Wireshark pour analyser les traces http.pcap, smtp.pcap, pop3.pcap, ftp.pcap, telnet.pcap, ssh.pcap, dns.pcap et remplir le tableau suivant.
Mettre le filtre de Wireshark à http, smtp, pop, ftp , telnet , ssh et dns respectivement pour afficher seulement les messages utiles.
Utilisez l’annexe de ce TP pour le format des entêtes TCP et UDP.
Protocole
Adresse IP du serveur
Numéro de port du serveur
Numéro du protocole (entête IP)
Adresse IPdu client
Numéro du port du client
http
smtp
pop
ftp
telnet
ssh
dns
Réponse
Protocole
Adresse IP du serveur
Numéro de port du serveur
Numéro du protocole (entête IP)
Adresse IPdu client
Numéro du port du client
http
10.1.1.13
80
6
10.1.1.11
47756
smtp
10.1.1.13
25
6
10.1.1.11
60506
pop
10.5.1.53
110
6
10.5.1.51
39192
ftp
10.1.1.13
21
6
10.1.1.11
54670
telnet
10.1.1.13
23
6
10.1.1.11
38283
ssh
10.1.1.13
22
6
10.1.1.11
38257
dns
10.1.1.13
53
17
132.227.61.122
34053
Après examen des numéros de port des serveurs et des clients quelle conclusion peut-on établir ?
Réponse
Les numéros de port des serveurs sont standardisés mais pas ceux des
clients. C’est tout à fait normal : un client doit connaître le numéro du
port pour s’adresser au bon service sur le serveur.De plus, les numéros des
services sont fixes et inférieurs à 1024 alors que ceux utilisés par les
clients sont dynamiques et supérieurs à cette valeur. Seul un compte «
administrateur de la machine » peut ouvrir un port inférieur à 1024.
Le côté client de la connexion effectue une ouverture active en 3 temps :
Le client envoie un segment SYN au serveur,
Le serveur lui répond par un segment SYN/ACK,
Le client confirme par un segment ACK.
Durant cet échange initial, les numéros de séquence des deux parties sont
synchronisés :
Le client utilise son numéro de séquence initial dans le champ « Numéro
de séquence » du segment SYN (x par exemple),
Le serveur utilise son numéro de séquence initial dans le champ “Numéro
de séquence” du segment SYN/ACK (y par exemple) et ajoute le numéro de
séquence du client plus un (x+1) dans le champ “Numéro d’acquittement” du
segment,
Le client confirme en envoyant un ACK avec un numéro de séquence augmenté
de un (x+1) et un numéro d’acquittement correspondant au numéro de
séquence du serveur plus un (y+1).
Utiliser la trace http.pcap. Mettre le filtre à http || tcp pour limiter les messages à afficher. Quelles sont les trames correspondant à l’établissement de la connexion TCP ?
Réponse
Rappel : L’établissement d’une connexion TCP met en œuvre le « hand
shake », un processus en trois étape : émission d’un segment avec un drapeau
SYN, puis réponse avec un drapeau SYN,ACK et pour finir une dernière
émission (avant le réel envoi des données) avec un drapeau ACK.
Pendant la phase de transferts de données, certains mécanismes clefs
permettent d’assurer la robustesse et la fiabilité de TCP. En particulier, les
numéros de séquence sont utilisés afin d’ordonner les segments TCP reçus et
de détecter les données perdues, les sommes de contrôle permettent la
détection d’erreurs, et les acquittements ainsi que les temporisations
permettent la détection des segments perdus ou retardés.
Grâce aux numéros de séquence et d’acquittement, les systèmes terminaux
peuvent remettre les données reçues dans l’ordre à l’application
destinataire.
Les numéros de séquence sont utilisés pour décompter les données dans le
flux d’octets. On trouve toujours deux de ces nombres dans chaque segment TCP,
qui sont le numéro de séquence et le numéro d’acquittement. Le numéro de
séquence représente le propre numéro de séquence de l’émetteur TCP, tandis
que le numéro d’acquittement représente le numéro de séquence du
destinataire. Afin d’assurer la fiabilité de TCP, le destinataire doit
acquitter les segments reçus en indiquant qu’il a reçu toutes les données du
flux d’octets jusqu’à un certain numéro de séquence.
Le numéro de séquence indique le premier octet des données.
Par exemple, dans le cas d’un échange de segments par Telnet :
L’hôte A envoie un segment à l’hôte B contenant un octet de données, un
numéro de séquence égal à 43 (Seq = 43) et un numéro d’acquittement
égal à 79 (Ack = 79),
L’hôte B envoie un segment ACK à l’hôte A. Le numéro de séquence de ce
segment correspond au numéro d’acquittement de l’hôte A (Seq = 79), et le
numéro d’acquittement au numéro de séquence de A tel que reçu par B,
augmenté de la quantité de données en bytes reçue (Ack = 43 + 1 = 44),
L’hôte A confirme la réception du segment en envoyant un ACK à l’hôte B,
avec comme numéro de séquence son nouveau numéro de séquence, à savoir
44 (Seq = 44) et comme numéro d’acquittement le numéro de séquence du
segment précédemment reçu, augmenté de la quantité de données reçue
(Ack = 79 + 1 = 80).
Observer en détail les messages correspondant à l’établissement de la
connexion TCP. Identifier les numéros de séquence, numéros d’acquittement et
la taille de la fenêtre de réception échangés.
Réponse
Le numéro de séquence initial du client est 0x a7 b6 4b 61 (2 831 741
921).
Le numéro de séquence initial du serveur est 0x d7 aa 92 97 (3 618 280
087).
La taille de la fenêtre de réception du client est de 5840 octets, celle
du serveur est de 5792 octets.
Continuer avec la trace http.pcap, mettre le filtre à http,
combien de trames sont-elles affichées? Ensuite, remettre le filtre à http || tcp, combien de trames sont-elles affichées ? Les nombres de trames dans les deux cas sont-ils égaux ? Pourquoi ?
Réponse
Filtre = « http » : 4 trames,
Filtre = « http or tcp » : 14 trames.
Il y a plus de trames capturées quand le filtre est http || tcp car
au niveau transport, il y a des segments de contrôle TCP (SYN, SYN-ACK, ACK, FIN) en plus des segments de données (les segments qui contiennent les messages du protocole au niveau applicatif HTTP).
Analyser maintenant la trace ftp.pcap. À quoi correspondent les trames 1
et 2 ?
Réponse
Les trames 1 et 2 constituent le dialogue initial, lorsque le client essaie de
faire correspondre une adresse MAC à une adresse IP. Ce dialogue concerne la
couche 1 du modèle OSI.
Indiquer quelle sont les adresses MAC des client et serveur.
Réponse
Client : 08:00:27:e3:ec:3b et Serveur : 08:00:27:04:56:51
Analyser maintenant la trace dns.pcap et mettre le filtre à dns,
combien de trames sont-elles affichées ? Le protocole de niveau 4 utilisé
est-il TCP ?
Ensuite, mettre le filtre à dns or udp, combien de trames sont-elles affichées ? Les nombres de trames dans les deux cas sont-ils égaux ? Pourquoi ? (Il pourra être utile de se renseigner sur le protocole UDP).
Réponse
Pour tous les deux cas : 2 trames sont affichées. Il n’y a pas de message
de contrôle dans UDP.
Physique, Chimie et Informatique > Terminales Spé. NSI > Les réseaux
Attention : Choisir la langue lors de la première ouverture du logiciel. En cas d’erreur, supprimer le dossier .filius contenant les paramètres de langues se trouvant dans C:\Users\nom d’utilisateur sur le réseau\AppData\Local\.filius (sous windows).
Construction d’un réseau local
En mode conception, créer le réseau local suivant :
Configurer chaque ordinateur : Mode conception⟶Clic droit sur l’ordinateur ⟶Configurer. Remarque : le masque de sous-réseau doit être 255.255.255.0.
Sélectionner « Utiliser l’adresse IP comme nom ».
Ralentir les animations de façon à pouvoir visualiser le chemin des trames : ramener le curseur placé juste à droite du bouton Simulation à 1 %.
Sur l’ordinateur portable installer les outils en ligne de commande : Mode simulation⟶Clic gauche⟶Installation des logiciels⟶Ligne de commande⟶Appliquer les modifications.
À quoi correspond la table arp ?
Réponse
La table arp donne la correspondance entre les adresses MAC, seules utilisées sur un réseau local, et les adresses IP, définies par les administrateurs réseau.
Lancer la commande arp -a et examiner son retour. Que nous apprend-elle ?
Réponse
Adresse IP
Adresse MAC
255.255.255.255
FF:FF:FF:FF:FF:FF
Par défaut, on a juste l'adresse MAC de diffusion (broadcast).
Lancer la commande ping 192.168.0.11. À quoi sert cette commande ?
Réponse
La commande ping permet de tester si une liaison réseau vers une machine que l’on sait allumée et fonctionnelle existe ou pas. Des paquets sont envoyés vers cette dernière ; elle les retourne alors tels quels (echo).
Décrire la circulation des trames observables lors de la simulation.
Réponse
Dans un premier temps tous les cables s’allument, ce qui témoigne d’un mécanisme de diffusion.
Par la suite, seuls les cables reliant les deux machines qui dialoguent au switch s’allument. Le switch (commutateur) permet un dialogue direct entre ces machines.
Lancer à nouveau la commande arp -a. Quelle information supplémentaire la table arp contient-elle ?
Réponse
Adresse IP
Adresse MAC
255.255.255.255
FF:FF:FF:FF:FF:FF
192.168.0.11
0C:84:62:DD:1B:C4
La table `arp` contient désormais une entrée pour l'ordinateur d'adresse IP 192.168.0.11.
Remarque.
Vous n’obtiendrez pas forcément les mêmes adresses MAC lors de votre simulation.
Visualiser l’historique du traffic : Clic droit sur l’ordinateur ⟶Afficher les échanges de données.
Décrire avec précision la méthode utilisée pour découvrir quel est l’ordinateur d’adresse IP 192.168.0.11 sur le réseau.
Réponse
L’ordinateur portable forme et envoie une trame diffusée sur tout le réseau local (broadcast) qui contient :
Pour la couche de liaison (niveau 2) :
Adresse MAC source : son adresse MAC
Adresse MAC destination : adresse MAC de diffusion (l’adresse MAC de l’ordinateur distant est encore inconnue à ce stade)
Pour la couche réseau (niveau 3) :
IP source : son adresse IP
IP destination : l’adresse IP de l’ordinateur distant
Protocole : ARP
Commentaire : Qui a pour adresse IP 192.168.0.11 ?
L’ordinateur distant forme et envoie une trame potentiellementdiffusée sur tout le réseau local (broadcast) qui contient :
Pour la couche de liaison (niveau 2) :
Adresse MAC source : son adresse MAC
Adresse MAC destination : adresse MAC de l’ordinateur portable
Pour la couche réseau (niveau 3) :
IP source : son adresse IP
IP destination : l’adresse IP de l’ordinateur portable
Protocole : ARP
Commentaire : C’est moi et mon adresse MAC est …
À ce stade de la communication, la découverte est terminée et on passe à un autre protocole.
Pourquoi voit-on, dans certains messages, une adresse MAC valant FF:FF:FF:FF:FF:FF ?
Réponse
Il s’agit de l’adresse MAC de diffusion (broadcast).
À quel niveau du modèle OSI le protocole arp intervient-il ?
Réponse
Niveau 3, couche réseau. Ce protocole fait cependant le lien entre les informations de la couche 2 et celles de la couche 3. On dit parfois que ce protocole appartient à la couche 21/2.
À quel niveau du modèle OSI intervient la commande ping ?
Réponse
Le protocole ICMP intervient au niveau 3, couche réseau.
Examiner la table SAT du switch : Clic gauche sur le switch.
Que nous apprend cette table ?
Réponse
Cette table indique quel port il faut emprunter pour accéder aux ordinateurs dont l’adresse MAC a été repérée.
Expliquer pourquoi on dit qu’« un commutateur (switch) limite le domaine de collision mais pas le domaine de diffusion ».
Réponse
À retenir
Au niveau de la couche 2 du modèle OSI, aucune notion de connexion entre deux machines n’existe ; les segments sont diffusés sur tout le réseau et sont reçus aussi bien par la machine destinataire (qui traite alors l’information) que par celles qui ne le sont pas.
Le processus de découverte de l’adresse MAC de la machine destinataire se fait forcément par diffusion. Un commutateur doit permettre ce mécanisme.
Par la suite, le switch s’assure que les segments destinés à une machine soient directement dirigés vers le port qui conduit à la machine destinataire ; il évite donc une diffusion à tout le réseau et les éventuelles collisions entre segments qui pourraient intervenir.
Reprendre les manipulations précédentes en utilisant encore la commande ping vers une nouvelle machine. Vérifier le remplissage des tables arp et SAT.
Communication entre deux réseaux
Créer le réseau local suivant :
Les masques de sous-réseau sont :
255.255.255.0 pour le sous-réseau connecté au switch A ;
255.255.0.0 pour le sous-réseau connecté au switch B.
À retenir
Pour pouvoir communiquer sur un même réseau, deux hôtes doivent avoir la même adresse réseau (IP).
Pour pouvoir communiquer entre deux réseaux différents, il faut passer par une routeur (ou passerelle), qui lui, possède plusieurs cartes réseau, et donc plusieurs adresses IP.
Lancer la commande ping depuis un ordinateur du sous-réseau A vers un ordinateur du sous-réseau B. Observer et justifier le résultat.
Réponse
Il est impossible d’atteindre un ordinateur du sous-réseau B depuis un ordinateur du sous-réseau A car ils n’appartiennent pas au même réseau et parce que le routeur n’a pas encore été configuré.
Configurer le routeur afin qu’il route les paquets entre les deux sous-réseaux et tenter à nouveau l’expérience de la question 18. La communication est-elle bien établie ?
Remarque : Choisir l’adresse 192.168.0.254 pour l’interface qui est dans le sous-réseau de gauche et 172.16.255.254 pour celle qui est dans le sous-réseau de droite.
Réponse
La communication est toujours impossible.
Afin de comprendre pourquoi la communication entre les machines des deux sous-réseaux est toujours impossible, sur l’ordinateur du sous-réseau A, lancer la commande route. Examiner le résultat et identifier le problème.
Réponse
Destination
Masque
Passerelle
Interface
192.168.0.10
255.255.255.255
127.0.0.1
127.0.0.1
192.168.0.0
255.255.255.0
192.168.0.10
192.168.0.10
127.0.0.1
255.0.0.0
127.0.0.1
127.0.0.1
L’ordinateur ne connaît pas la route vers le sous-réseau B.
Configurer l’ordinateur afin que la communication avec l’autre sous-réseau soit possible.
Réponse
Il faut ajouter à la main une nouvelle route (ce qui sera fait un peu plus tard) ou définir la « passerelle par défaut », c’est à dire la passerelle qui sera utilisée chaque fois que l’ordinateur ne saura pas quoi faire.
Lancer à nouveau la commande ping et examiner le résultat.
Réponse
La communication n’a toujours pas lieu.
Que faut-il faire pour que la communication entre les deux ordinateurs puisse enfin s’établir ?
Réponse
L’ordinateur du sous-réseau B doit lui aussi avoir une passerelle définie.
Associer une passerelle à tous les ordinateurs.
Examiner la table arp de l’ordinateur du sous-réseau A qui vient de communiquer avec l’ordinateur du sous-réseau B. Existe-t-il une entrée pour l’ordinateur du sous-réseau B ? À quel ordinateur est associée l’entrée présente dans la table ?
Réponse
Il n’existe aucune entrée pour l’ordinateur du sous-réseau B mais une entrée pour l’interface du routeur appartenant au sous-réseau A.
À retenir
La couche de liaison ne définit aucune connexion directe entre deux ordinateurs. Les ordinateurs envoient toujours des trames (niveau 2) sur le réseau local. Lorsque l’ordinateur destinataire ne se trouve pas sur le réseau local, c’est au routeur d’acheminer correctement les paquets (niveau 3).
De la même façon, examiner la table arp de l’ordinateur du sous-réseau B qui vient de communiquer avec l’ordinateur du sous-réseau A. Existe-t-il une entrée pour l’ordinateur du sous-réseau A ? À quel ordinateur est associée l’entrée présente dans la table ?
Réponse
Il n’existe aucune entrée pour l’ordinateur du sous-réseau A mais une entrée pour l’interface du routeur appartenant au sous-réseau B.
Quelle conclusion peut-on déduire des deux observations précédentes ?
Réponse
À retenir
Les trames ne traversent pas les routeurs et ne peuvent pas se propager dans des réseaux différents.
Lancer la commande traceroute vers l’ordinateur du sous-réseau B. À quoi correspond le retour de cette commande ?
Réponse
traceroute donne le chemin suivi par les paquets.
Quelle première action doit effectuer un ordinateur qui doit envoyer un paquet sur un réseau qui n’est pas celui auquel il appartient ?
Réponse
L’ordinateur doit dans un premier temps déterminer l’adresse MAC du routeur (passerelle) sur son réseau.
Cette étape nécessite la diffusion d’une trame de découverte tel qu’expliqué dans les premières étapes de ce document.
Quelles informations contiennent la trame et le paquet formés et envoyés par un ordinateur qui doit envoyer un paquet sur un réseau qui n’est pas celui auquel il appartient ?
Réponse
À retenir
Trame (couche de liaison ou niveau 2 du modèle OSI):
Addresse MAC source : son adresse MAC
Adresse MAC de destination : l’adresse MAC du routeur
Paquet (couche réseau ou niveau 3 du modèle OSI) :
Addresse IP source : son adresse IP
Addresse IP de destination : l’adresse IP de l’ordinateur appartenant à l’autre sous-réseau
Quelles actions un routeur effectue-t-il lorsqu’il reçoit une trame ?
Réponse
À retenir
Le routeur déconstruit la trame ;
Le routeur lit l’adresse IP de destination du paquet en lisant l’entête de ce paquet ;
Le routeur prend une décision de routage ;
Le routeur recontruit une trame qui encapsule le paquet et contient comme adresse MAC source son adresse MAC et comme addresse MAC de destination celle de l’ordinateur cible si ce dernier appartient au même sous-réseau que le routeur ou alors l’adresse MAC du prochain routeur.
Réseaux étendus
Info
Télécharger le fichier de configuration du
réseau étendu
Lancer la commande traceroute depuis l’ordinateur M14 vers l’ordinateur M9. Noter la route empruntée par les paquets.
Afin de simuler une panne, supprimer le câble réseau qui relie le routeur F au routeur E et lancer à nouveau la commande traceroute. Les paquets issus de M14 parviennent-ils toujours en M9 ?
Remarque.
Cela peut ne pas fonctionner du premier coup, car la mise à jour des tables de routage n’est pas immédiate. Pour remédier à cela, faire un ping entre M14 et M9, si cela ne fonctionne pas (timeout), attendre quelques secondes et recommencer.
Ouvrir les tables de routage de tous les routeurs qui sont intervenus dans la communication et expliquer le fonctionnement de ces tables.
Physique, Chimie et Informatique > Terminales Spé. NSI > Les réseaux
La responsabilité d’un protocole de routage est de fournir l’information nécessaire pour effectuer un routage, c’est-à-dire la détermination d’un chemin entre une machine émettrice et une machine réceptrice, toutes deux identifiées par leur adresse IP sur des sous-réseaux différents.
À retenir
Un routeur est un ordinateur possédant au moins deux interfaces réseaux situées sur des sous-réseaux IP différents.
Avertissement
Il faut être capable de distinguer une carte réseau d’une interface réseau.
Une carte réseau est un objet physique possédant une adresse MAC. On peut « attacher » à une carte réseau une ou plusieurs interfaces réseaux, objets virtuels, possédant toutes des adresses IP différentes.
La plupart du temps, cependant, on n’attache qu’une seule interface à chaque carte réseau.
Tous les systèmes d’exploitation, pour des raisons de fonctionnement interne qui ne seront pas développées ici, définissent une interface dite de bouclage (loopback) dont l’adresse est 127.0.0.1.
Exercice
Lancer un terminal.
Entrer la commande ipconfig /all sous Windows ou ifconfig sous Linux ou OSX. Vérifier que l’interface de loopback est bien définie.
Tapper la commande ping 127.0.0.1 et vérifier que l’interface est bien active.
Dans les faits, pour des raisons de performances, dire qu’un routeur possède plusieurs interfaces réseaux est équivalent à dire que le routeur possèdent plusieurs cartes réseaux.
Dans les tables de routage, il n’est jamais fait allusion aux cartes réseaux mais aux interfaces réseaux.
Tables de routage
Les routeurs ne sont pas les seuls ordinateurs à posséder une table de routage
Chaque ordinateur sur un réseau doit décider à qui transmettre les trames lorsqu’il doit dialoguer avec un autre ordinateur.
À l’aide du logiciel Filius, on se connecte à une machine d’adresse IP 172.12.0.2 et on clique sur « Afficher le bureau ».
On utilise la commande route dans le terminal et on obtient le résultat suivant :
Décrire le plus précisément possible cet affichage.
Réponse
Ligne 1
La machine a pour adresse IP 172.12.0.2 (on le sait grâce au masque de sous-réseau 255.255.255.255 qui est le masque d’un hôte). Tout paquet destiné à cet ordinateur émis depuis cet ordinateur doit passer par l’interface de loopback.
Ligne 2
Tout paquet à destination du sous-réseau 172.12.0.0, sous-réseau auquel appartient l’ordinateur doit transiter par l’interface attachée à cet ordinateur d’adresse 172.12.0.2. Rappel : Un ordinateur n’a pas besoin d’un routeur pour dialoguer avec un autre ordinateur appartenant au même réseau. **Les routeurs ne sont obligatoires que lorsqu’il s’agit de faire dialoguer des ordinateurs appartenant à des réseaux différents.
Ligne 3
Tout paquet à destination du réseau de loopback doit transiter par l’adresse de loopback.
Ligne 4
(Route par défaut) Tout paquet destiné à un ordinateur pour lequel aucune des décisions de routage précédentes ne convient (donc tous les paquets qui ne sont destinés ni à l’ordinateur, ni au sous-réseau auquel l’ordinateur appartient) doit transiter par l’interface d’adresse 172.12.0.2 et être adressé à l’ordinateur d’adresse 172.12.255.254 ; c’est le routeur.
Quelle est l’adresse du routeur avec lequel cet ordinateur peut directement dialoguer ?
Réponse
Le routeur de ce sous-réseau a donc pour adresse 172.12.255.254.
Tous les routeurs utilisent un routage automatique. Leur action n’est pas étudiée dans l’exercice qui suit.
À l’aide du logiciel Filius, se connecter à la machine d’adresse IP 192.168.0.10 et cliquer sur « Afficher le bureau ».
Cette machine est-elle capable d’envoyer un paquet vers la machine d’adresse 192.168.3.11 ? Justifier la réponse à partir de l’étude de la table de routage.
Réponse
L’ordinateur peut tout à fait envoyer un paquet vers l’ordinateur d’adresse 192.168.3.11 puisqu’il possède une route par défaut qui passe par le routeur R2, route qui mène au sous-réseau d’adresse 192.168.3.0.
Même question pour l’envoi d’un paquet vers la machine d’adresse 192.168.1.10.
Est-il nécessaire de formuler une hypothèse ?
Réponse
Lorsqu’on affiche la table de routage de cet ordinateur on constate qu’aucune entrée ne lui permet d’envoyer un paquet vers le réseau d’adresse 192.168.1.0/24 puisque ce réseau n’est pas le sien. Tout dépend donc de la configuration du routeur R2, passerelle par défaut pour cet ordinateur.
Si le routeur R2 n’a aucune connaissance de ce réseau, la machine ne peut pas envoyer un paquet vers celle d’adresse 192.168.1.10.
Si le routeur R2 sait comment envoyer un paquet à ce réseau, la machine peut envoyer un paquet vers celle d’adresse 192.168.1.10.
Se connecter l’ordinateur d’adresse IP 192.168.0.11. Est-il capable d’envoyer un paquet vers la machine d’adresse IP 192.168.3.11 ? Justifier la réponse à partir de l’étude de la table de routage.
Réponse
Lorsqu’on affiche la table de routage de cet ordinateur on constate qu’aucune entrée ne lui permet d’envoyer un paquet hors de son réseau (ou de son adresse loopback). Il ne sait donc pas comment envoyer un message à l’ordinateur d’adresse 192.168.3.11.
Corriger la configuration réseau de l’ordinateur d’adresse IP 192.168.0.11 de façon à ce qu’il puisse envoyer un paquet à l’ordinateur d’adresse 192.168.3.11.
Réponse
Il faut configurer la passerelle par défaut en lui attribuant l’adresse du routeur : 192.168.1.253.
L’ordinateur d’adresse 192.168.3.11 peut-il répondre à l’ordinateur d’adresse 192.168.0.10 ? Justifier la réponse à partir de l’étude de la table de routage.
Réponse
La route par défaut, dans la table de routage passe par le routeur R4 qui, sauf configuration particulière non prise en compte dans cette partie, ne sait pas comment atteindre le réseau 192.168.0.0. L’ordinateur d’adresse 192.168.3.11 ne peut donc pas répondre à l’ordinateur d’adresse 192.168.0.10.
Utiliser la commande ping pour confirmer l’étude menée jusqu’à présent.
Quelle entrée devrait posséder la table de routage de la machine d’adresse 192.168.0.10 pour pouvoir communiquer avec la machine d’adresse 192.168.1.10 ?
Destination
Masque
Passerelle
Interface
Réponse
Destination
Masque
Passerelle
Interface
192.168.1.0
255.255.255.0
192.168.0.254
192.168.0.10
Comment une décision de routage est-elle prise par un routeur ?
Algorithme de prise de décision
Un signal électrique (ou lumineux ou hertzien) parvient à l’une des cartes réseau du routeur.
Le routeur déconstruit la trame contenant toutes les informations que transporte ce signal.
Le routeur lit l’adresse MAC du destinataire dans l’entête de la trame.
Si cette adresse MAC n’est pas celle du routeur, la trame est rejetée. Si l’adresse MAC est bien celle du routeur, le routeur analyse l’adresse IP du destinataire final, présente dans l’entête du paquet contenu dans la trame.
Si l’adresse IP du destinataire final appartient à un réseau auquel le routeur est directement connecté, le routeur envoie directement l’information sur le bon réseau (il reconstruit une nouvelle trame avec comme adresse MAC source son adresse, bien sûr).
Si l’adresse IP du destinataire final appartient à un réseau qui apparaît dans la table de routage, le routeur envoie l’information à la passerelle définie.
Si l’adresse IP du destinataire final n’appartient à aucun des réseaux présents dans la table de routage, le routeur envoie l’information à la passerelle par défaut.
Quelle couche du modèle OSI est concernée par l’émission ou la réception de signaux physiques ?
Réponse
L’émission ou la réception des signaux physiques sont définies par des protocoles de la couche physique (ou couche 1).
À quelle couche appartiennent les protocoles qui définissent la structure d’une trame et qui se basent sur les adresses MAC ?
Réponse
La structure d’une trame est définie au niveau de la couche de liaison (couche 2).
Au niveau de quelle couche parle-t-on de paquets et d’adresses IP ?
Réponse
Les structure des paquets est définie au niveau de la courche réseau (couche 3).
Combien de sauts retourne la commande traceroute 192.168.3.11 lancée depuis la machine d’adresse 192.168.0.10 ?
Réponse
Le signal parvient à l’ordinateur d’adresse 192.168.3.11 en 3 sauts : 192.168.0.253, 192.168.2.2, 192.168.3.11.
Ce sont toutes les interfaces d’entrées des différentes trames.
Combien de sauts retourne la commande traceroute 192.168.0.10 lancée depuis la machine d’adresse 192.168.3.11 ? Expliquer l’origine de la différence.
Réponse
Le signal parvient à l’ordinateur d’adresse 192.168.0.10 en 4 sauts : 192.168.3.254, 192.168.3.253, 192.168.2.1, 192.168.0.10.
Ce sont toutes les interfaces d’entrées des différentes trames.
On compte dans ce sens un saut de plus car l’ordinateur d’adresse 192.168.3.11 ne sait pas s’adresser directement au routeur 192.168.3.253.
Compléter la table de routage du routeur R3 de façon à ce que n’importe quel ordinateur puisse communiquer avec n’importe quel autre ordinateur.
Ajouter aussi la passerelle par défaut, R4
Destination
Masque
Passerelle
Interface
192.168.3.253
255.255.255.255
127.0.0.1
127.0.0.1
192.168.2.2
255.255.255.255
127.0.0.1
127.0.0.1
192.168.3.0
255.255.255.0
192.168.3.253
192.168.3.253
192.168.2.0
255.255.255.0
192.168.2.2
192.168.2.2
127.0.0.1
255.0.0.0
127.0.0.1
127.0.0.1
Réponse
Destination
Masque
Passerelle
Interface
192.168.0.0
255.255.255.0
192.168.2.1
192.168.2.2
192.168.1.0
255.255.255.0
192.168.2.1
192.168.2.2
0.0.0.0
0.0.0.0
192.168.3.254
192.168.3.253
On donne ci-dessous la table de routage de base du routeur R1. Cette table doit-elle être complétée de façon à ce que tous les ordinateurs puissent communiquer avec tous les ordinateurs sur le réseau ?
Destination
Masque
Passerelle
Interface
192.168.1.254
255.255.255.255
127.0.0.1
127.0.0.1
192.168.0.254
255.255.255.255
127.0.0.1
127.0.0.1
192.168.1.0
255.255.255.0
192.168.1.254
192.168.1.254
192.168.0.0
255.255.255.0
192.168.0.254
192.168.0.254
127.0.0.1
255.0.0.0
127.0.0.1
127.0.0.1
0.0.0.0
0.0.0.0
192.168.0.253
192.168.0.254
Réponse
Cette table de routage est complète, il n’est pas nécessaire d’ajouter quoi que ce soit. Tout paquet destiné à un réseau non présent dans cette table est envoyé à la passerelle par défaut qui s’occupe de le router au-delà du périmètre d’influence de R1.
Types de routage
Si le réseau n’est pas trop étendu, il est possible de créer manuellement les tables de routage de chaque routeur (routage statique). Cependant, cette méthode n’est pas applicable sur des grands réseaux : les routeurs doivent alors mettre en œuvre des protocoles leurs permettant de construire et de partager automatiquement les tables de routage ; on parle de routage dynamique.
Intérêt d’un routage automatique
À retenir
Les protocoles de routage établissent des règles d’échange entre routeurs pour mettre à jour leurs tables selon des critères de coût comme, par exemple, la distance, l’état de la liaison, le débit. Ils améliorent ainsi l’efficacité du routage.
Les protocoles de routage ont pour objectif d’éviter les boucles de routage (le message peut « tourner en rond » dans le réseau et ne jamais atteindre son destinataire).
Les protocoles de routage doivent permettre de compenser les pannes dans le réseau : une fois une panne détectée, il faut transmettre l’information sur l’événement le plus rapidement possible pour que les différents routeurs recalculent par où faire passer leurs messages en contournant la liaison en panne.
On laisse donc les routeurs mettre eux-mêmes à jour leur table de routage grâce à la mise en œuvre de protocoles de routage.
Info
Initialement, les informations dont dispose un routeur sont celles sur ces voisins immédiats ainsi que les sous-réseaux auxquels il est connecté. En envoyant régulièrement des messages à ses voisins, et en évaluant le temps de réponse, il peut déterminer si un routeur fonctionne ou pas et en déduire si une liaison existe toujours ou est rompue. Il peut ensuite propager cette information à ses voisins qui peuvent eux-mêmes les transmettre à leurs voisins. Ainsi, de proche en proche, tous les routeurs finissent par partager les mêmes connaissances sur la topologie du réseau.
Routing Information Protocol (RIP) : algorithme à vecteur de distances
RIP est historiquement le premier algorithme de routage.
À retenir
RIP recherche le plus court chemin selon un critère de coût simple : le nombre de routeurs à traverser (hop).
Cela revient à affecter un coût unitaire à la traversée de chaque routeur.
RIP appartient à la famille des protocoles à vecteurs de distance, puisque les informations contenues dans la table de routage sont du type (adresse, distance).
adresse+distance=vecteur
Algorithme général de RIP
Lors de l’initialisation du routeur, celui-ci détermine l’adresse réseau de ses interfaces puis envoie sur chacune une demande d’informations (table RIP complète) aux routeurs voisins.
Lors de la réception d’une demande, un routeur envoie sa table complète ou partielle suivant la nature de cette demande.
Lors de la réception d’une réponse, il met à jour sa table si besoin. Trois cas peuvent se présenter :
pour une nouvelle route, il incrémente la distance, vérifie que celle-ci est strictement inférieure à 15 et diffuse immédiatement le vecteur de distance correspondant ;
pour une route existante, mais avec une distance plus faible, la table est mise à jour. La nouvelle distance et, éventuellement, l’adresse du routeur si elle diffère sont intégrées à la table ;
pour une route existante, mais avec une distance plus importante, la table est mise à jour si la nouvelle distance est émise par le même routeur voisin que précédemment.
Bien sûr, si l’appareil reçoit une route dont la distance est supérieure à celle déjà connue d’un autre voisin, RIP l’ignore.
À intervalles réguliers (toutes les 30 secondes), la table RIP est diffusée qu’il y ait ou non des modifications.
Des routes doivent être retirées de la table gérée par RIP dans deux situations :
en premier lieu, si un réseau immédiatement connecté devient inaccessible (panne de l’interface, de la ligne, modification de la topologie par l’administrateur, etc.), les routeurs RIP reliés à ce réseau affectent dans leur table une distance « infinie » (16 comme indiqué plus haut) à cette route. Elle est conservée pendant la durée d’un temporisateur de « maintien » (garbage collect) de 120 secondes puis est supprimée. Immédiatement après, le vecteur avec une distance « infinie » est diffusé. Un routeur qui reçoit un vecteur avec une distance de 16 comprend : « il faut que tu retires cette route de ta table, car elle est devenue invalide ! » De proche en proche, cette information se propage ;
en second lieu, un routeur du réseau tombe en panne. Cela veut peut-être dire que les réseaux situés derrière cet appareil sont devenus inaccessibles. Mais comment savoir si un routeur est en panne ? RIP considère qu’un routeur qui n’a pas donné de nouvelles depuis trois minutes est hors service. Pour gérer cette situation, il attribue à toutes les routes dynamiques un temporisateur initialisé à 180 secondes par défaut. À chaque réception d’un vecteur de distance déjà présent dans la table, le compteur est réinitialisé. Mais si jamais ce compteur atteint zéro, la route est considérée comme invalide. On se retrouve alors dans la situation précédente (distance infinie, temporisateur de maintien, diffusion de l’information puis suppression de la route). Maintenant, si un autre routeur connaît une route menant vers un des réseaux que l’on vient de retirer, c’est parfait ! Notre routeur intègrera cette nouvelle route dans sa table. De cette façon, RIP permet la tolérance aux pannes.
Un routeur garde donc en mémoire, pour chaque réseau IP connu, l’adresse du routeur voisin dont la distance (on dit aussi métrique) est la plus petite.
À retenir
Les trois caractéristiques principales qui distinguent l’algorithme RIP de l’algorithme OSPF sont :
La distance est mesurée en nombre de routeurs à traverser.
Aucun routeur n’a une vision globale du réseau. Les routes sont connues de proche en proche.
Le protocole est limité aux réseaux dont le plus long chemin implique quinze routeurs au maximum car la convergence des informations est très lente.
Remarque
Les situations où les routes doivent être choisies en fonction de paramètres mesurés en temps réel comme un délai, une fiabilité ou une charge, se prêtent donc mal à ce type de traitement.
Remarque
Pour déterminer quelle est la meilleure route, le protocole RIP s’appuie sur l’algorithme de Bellman et Ford qui sera étudié un peu plus tard dans l’année.
Exercice
Pour chaque sous-réseau situé entre deux routeurs, donner la première adresse utilisable pour adresser une machine et la dernière.
Attribuer aux différentes interfaces des routeurs des adresses.
Donner la table de routage du routeur R1 à son initialisation. Ajouter une colonne distance.
Destination
Masque
Passerelle
Interface
Distance
Remarque : Pour simplifier la lecture, ne rien écrire dans la colonne Passerelle si celle-ci est le routeur lui-même. De plus, ne pas prendre en compte l’adresse de loopback et la route par défaut.
Même question pour le routeur R3 et le routeur R2.
Donner la table de routage du routeur R1 si on imagine qu’il a d’abord échangé une demande RIP avec le routeur R3.
Donner la table de routage du routeur R1 si on imagine qu’il a ensuite échangé une demande RIP avec le routeur R2.
Quelle est la table de routage finale pour le routeur R1.
Quel chemin vont suivre les paquets entre PC1 et PC2 ?
Réponses
10.0.0.0/8: adresses de 10.0.0.1 à 10.255.255.254 (même chose pour tous les réseaux en x.0.0.0/8) ;
192.168.1.0/24: adresses de 192.168.1.1 à 192.168.1.254 ;
192.168.2.0/24: adresses de 192.168.2.1 à 192.168.2.254 ;
R1 : 192.168.1.254, 10.0.0.1, 20.0.0.1 ;
R2 : 20.0.0.2, 30.0.0.2, 40.0.0.2 ;
R3 : 30.0.0.1, 50.0.0.1, 70.0.0.2, 10.0.0.2 ;
R4 : 40.0.0.1, 50.0.0.2, 60.0.0.2 ;
R5 : 192.168.2.254, 60.0.0.1, 70.0.0.1.
Table de routage de R1 après initialisation :
Destination
Masque
Passerelle
Interface
Distance
192.168.1.0
255.255.255.0
192.168.1.254
1
10.0.0.0
255.0.0.0
10.0.0.1
1
20.0.0.0
255.0.0.0
20.0.0.1
1
Table de routage de R2 après initialisation :
Destination
Masque
Passerelle
Interface
Distance
40.0.0.0
255.0.0.0
40.0.0.2
1
30.0.0.0
255.0.0.0
30.0.0.2
1
20.0.0.0
255.0.0.0
20.0.0.2
1
Table de routage de R3 après initialisation :
Destination
Masque
Passerelle
Interface
Distance
50.0.0.0
255.0.0.0
50.0.0.1
1
30.0.0.0
255.0.0.0
30.0.0.1
1
70.0.0.0
255.0.0.0
70.0.0.2
1
10.0.0.0
255.0.0.0
10.0.0.2
1
Après échange RIP entre R1 et R3, table de routage de R1 :
Destination
Masque
Passerelle
Interface
Distance
192.168.1.0
255.255.255.0
192.168.1.254
1
10.0.0.0
255.0.0.0
10.0.0.1
1
20.0.0.0
255.0.0.0
20.0.0.1
1
50.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
30.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
70.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
Après échange RIP entre R1 et R2, table de routage de R1 :
Destination
Masque
Passerelle
Interface
Distance
192.168.1.0
255.255.255.0
192.168.1.254
1
10.0.0.0
255.0.0.0
10.0.0.1
1
20.0.0.0
255.0.0.0
20.0.0.1
1
50.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
30.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
70.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
40.0.0.0
255.0.0.0
20.0.0.2
20.0.0.1
2
Table de routage finale de R1 :
Destination
Masque
Passerelle
Interface
Distance
192.168.1.0
255.255.255.0
192.168.1.254
1
10.0.0.0
255.0.0.0
10.0.0.1
1
20.0.0.0
255.0.0.0
20.0.0.1
1
50.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
30.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
70.0.0.0
255.0.0.0
10.0.0.2
10.0.0.1
2
40.0.0.0
255.0.0.0
20.0.0.2
20.0.0.1
2
60.0.0.0
255.0.0.0
20.0.0.2
20.0.0.1
3
192.168.2.0
255.255.255.0
10.0.0.2
10.0.0.1
3
Les paquets vont traverser les routeurs R1, R3 et R5.
Open Shortest Path First (OSPF) : algorithme à état de liaison
À retenir
L’algorithme SPF (Shortest Path First) calcule le plus court chemin vers toutes les destinations de la zone ou du système autonome, en partant du routeur où s’effectue le calcul (à partir de sa base de données topologiques). Il calcule le plus court chemin, selon un critère de coût où interviennent de multiples paramètres : l’état des liens, l’encombrement du réseau et des mémoires des routeurs intermédiaires.
Le calcul du plus court chemin est effectué de manière indépendante par tous les routeurs qui possèdent donc la même information : une vision globale de tout le réseau.
Chaque réseau peut être schématisé par un graphe dans lequel les routeurs et les switchs sont les sommets, leurs liaisons sont les arêtes, les étiquettes des arêtes sont les coûts.
Le protocole OSPF définit les règles et les formats de messages entre routeurs.
Remarque
L’algorithme utilisé par le protocole SPF est l’algorithme de Dijkstra (cet algorithme sera étudié un peu plus tard dans l’année) pour obtenir les routes les moins coûteuses et sans cycle. Chaque routeur devient alors la racine d’un arbre qui contient les meilleures routes.
Exercice
Reprendre l’exercice précédent en prenant en compte que les débits des liaisons éthernet sont très supérieurs aux débits des liaisons séries. Le protocole OSPF conduit-il selon vous à la même conclusion que le protocole RIP quant au chemin le plus court pour se déplacer de PC1 à PC2 ?
Réponse
Les débits de transmission sur les liaisons séries sont bien plus petits que ceux sur les liaisons éthernet. Si le protocole OSPF est utilisé la meilleure route annoncée sera donc R1⟶R2⟶R3⟶R4⟶R5.
Technologie
BP descendante
BP montante
Modem
56kbit/s
48kbit/s
Bluetooth
3Mbit/s
3Mbit/s
Ethernet
10Mbit/s
10Mbit/s
Wi-Fi
11Mbit/s à 10Gbit/s
11Mbit/s à 10Gbit/s
ADSL
13Mbit/s
1Mbit/s
4G
100Mbit/s
50Mbit/s
Satellite
50Mbit/s
1Mbit/s
FastEthernet
100Mbit/s
100Mbit/s
FFTH (fibre optique)
10Gbit/s
10Gbit/s
Notion de coût d’une liaison
La notion de coût est directement liée au débit des liaisons entre les routeurs. Le débit correspond au nombre de bits de données qu’il est possible de faire passer dans un réseau par seconde. Le débit est donc donné en bits par seconde (bps) ou dans l’une des unités multiples.
Connaissant le débit d’une liaison, il est possible de calculer le coût d’une liaison à l’aide de la formule suivante :
Couˆt=Deˊbit108
avec le débit en bits par seconde.
Remarque
Pour obtenir la métrique d’une route, il suffit d’additionner les coûts de chaque liaison.
Exercice
Soit le réseau dont la topologie est la suivante :
Les adresses IP des routeurs sont les suivantes :
A :
eth0 : 172.18.255.254
eth1 : 192.168.1.1
eth2 : 192.168.2.1
B :
eth0 : 192.168.1.2
eth1 : 192.168.3.1
eth2 : 172.16.255.254
C :
eth0 : 192.168.2.2
eth1 : 192.168.3.2
eth2 : 172.17.255.254
Établir la table de routage du routeur A si on suppose que le protocole RIP est utilisé.
Utiliser le nom des interfaces (eth0, eth1, eth2) à la place des adresses IP dans la table de routage.
Réponse
Destination
Masque
Passerelle
Interface
Distance
172.18.0.0
255.255.0.0
eth0
1
192.168.1.0
255.255.255.0
eth1
1
192.168.2.0
255.255.255.0
eth2
1
172.17.0.0
255.255.0.0
192.168.2.2
eth2
2
192.168.3.0
255.255.255.0
192.168.1.2
eth1
2
172.16.0.0
255.255.0.0
192.168.1.2
eth1
2
Quel est, d’après la table de routage ci-dessus, le chemin qui sera emprunté par un paquet pour aller d’une machine ayant pour adresse IP 172.18.1.1/16 à une machine ayant pour adresse IP 172.16.5.3/16 ?
Réponse
La route que suivront les paquets est : A⟶B.
Établir la table de routage du routeur A si on suppose que le protocole OSPF est utilisé.
On donne les débits suivants :
Liaison routeur A - routeur B : 1 Mbps ;
Liaison routeur A - routeur C : 10 Mbps ;
Liaison routeur C - routeur B : 10 Mbps ;
Liaisons routeurs - switch : 10 Mbps.
Réponse
Destination
Masque
Passerelle
Interface
Distance
172.18.0.0
255.255.0.0
eth0
10
192.168.1.0
255.255.255.0
eth1
100
192.168.2.0
255.255.255.0
eth2
10
172.17.0.0
255.255.0.0
192.168.2.2
eth2
20
192.168.3.0
255.255.255.0
192.168.2.2
eth2
20
172.16.0.0
255.255.0.0
192.168.2.2
eth2
30
Quel est, d’après la table de routage ci-dessus, le chemin qui sera emprunté par un paquet pour aller d’une machine ayant pour adresse IP 172.18.1.1/16 à une machine ayant pour adresse IP 172.16.5.3/16 ?
Réponse
La route que suivront les paquets est : A⟶C⟶B.
Physique, Chimie et Informatique > Terminales Spé. NSI > Les réseaux
Réalisation d'un chiffrement symétrique
L’objectif de ce document est d’illustrer un exemple de chiffrement symétrique, basique mais très utilisé dans les débuts de l’informatique car son implémentation est très simple..
Principe de la méthode
Rechercher le codage binaire du mot mon papa. C’est le message à chiffrer.
Réponse
Pour déterminer le codage binaire d’un caractère il faut :
Rechercher son code sous forme décimale ;
Déterminer l’écriture binaire du code décimal.
On choisit le mot bar comme clé de chiffrement. Rechercher le codage binaire de ce mot.
Réponse
01100010 01100001 01110010
Le chiffrement est effectué à l’aide d’une opération logique : on effectue un XOR bit à bit entre les bits du message à chiffrer et ceux de la clé.
Rappeler la table de vérité du XOR (OU exclusif).
Réponse
La clé est plus courte que le message. La dupliquer autant de fois que nécessaire (si la taille du message n’est pas un multiple entier de celle de la clé, ne prendre que quelques bits de cette dernière, en commençant par la gauche).
Réponse
Définir la fonction codage dont la spécification est
defcodage(a:int)->str:"""
Détermine l'écriture binaire de l'entier
a passé en argument et la retourne sous
forme d'une chaîne de 8 caractères 0 ou 1.
Hypothèse : les caractères sont codés sur un octet.
"""
Réponse
defcodage(a:int)->str:"""
Détermine l'écriture binaire de l'entier
a passé en argument et la retourne sous
forme d'une chaîne de 8 caractères 0 ou 1.
Hypothèse : les caractères sont codés sur un octet.
"""inv_chaine_bin=""# Chaîne binaire inverséewhilea!=0:inv_chaine_bin+=str(a%2)a=a//2octet=8# Formation d'octetsiflen(inv_chaine_bin)<octet:inv_chaine_bin+="0"*(octet-len(inv_chaine_bin))chaine_bin=""# Inversion de la chaîneforiinrange(len(inv_chaine_bin)-1,-1,-1):chaine_bin+=inv_chaine_bin[i]returnchaine_bin
Définir la fonction codage_chaine dont la spécification est
defcodage_chaine(texte:str)->str:"""
Convertit la chaîne de caractères passée
en argument en une chaîne de caractères
formés de 0 et de 1.
Les 0 et 1 constitue le codage binaire
de chacun des caractères de la chaîne
initiale.
Hypothèse : les caractères sont codés sur un octet.
"""
La fonction codage_chaine utilise les fonctions codage et ord.
Réponse
defcodage_chaine(texte:str)->str:"""
Convertit la chaîne de caractères passée
en argument en une chaîne de caractères
formés de 0 et de 1.
Les 0 et 1 constitue le codage binaire
de chacun des caractères de la chaîne
initiale.
Hypothèse : les caractères sont codés sur un octet.
"""rep=""forcarintexte:valeur=ord(car)# Valeur décimalechaine_bin=codage(valeur)rep+=chaine_binreturnrep
Vérifier que la fonction codage_chaine retourne bien le même codage que celui établi à la question 1. dans la partie principale du programme.
Obtenir le code de la clé utilisée à la question 2.
Réponses aux deux questions précédentes
if__name__=="__main__":# texte_a_chiffrer = input("Texte à chiffrer : ")texte_a_chiffrer="papa"texte_code=codage_chaine(texte_a_chiffrer)print(f"Code du texte :\n{texte_code}")# cle = input("Clé de chiffrement : ")cle="bar"cle_code=codage_chaine(cle)print(f"Code de la clé :\n{cle_code}")
Définir la fonction ajustement_cle dont la spécification est
defajustement_cle(code_cle:str,longueur_chaine:int)->str:"""
Ajuste la longueur du code de la clé à celle du
code de la chaîne à chiffrer, de longueur
longueur_chaine.
"""
Réponse
defajustement_cle(code_cle:str,longueur_chaine:int)->str:"""
Ajuste la longueur du code de la clé à celle du
code de la chaîne à chiffrer, de longueur
longueur_chaine.
"""iflen(code_cle)>=longueur_chaine:rep=code_cle[:longueur_chaine]else:rapport=longueur_chaine//len(code_cle)rep=code_cle*rapportrep+=code_cle[:longueur_chaine-len(rep)]returnrep
Définir la fonction chiffrement dont la spécification est
defchiffrement(chaine:str,cle:str)->str:"""
Réalise la chiffrement de chaine à l'aide de
la clé.
Méthode : chaine xor cle
"""
La fonction chiffrement utilise la fonction ajustement_cle.
Remarque : l’opérateur, en Python, permettant de réaliser le xor est ^à la condition que les opérandes soient des entiers.
Réponse
defchiffrement(chaine:str,cle:str)->str:"""
Réalise la chiffrement de chaine à l'aide de
clé.
Méthode : chaine xor cle
"""cle=ajustement_cle(cle,len(chaine))code_texte_chiffre=""foriinrange(len(chaine)):valeur=int(chaine[i])^int(cle[i])code_texte_chiffre+=str(valeur)returncode_texte_chiffre
Définir la fonction decodage dont la spécification est
defdecodage(car_code:str)->str:"""
Décode le caractère dont le code est passé en
argument.
Hypothèse : les caractères sont codés sur un octet
"""
Réponse
defdecodage(car_code:str)->str:"""
Décode le caractère dont le code est passé en
argument.
Hypothèse : les caractères sont codés sur un octet
"""valeur_code=0octet=8foriinrange(len(car_code)):valeur_code+=int(car_code[i])*2**(octet-(i+1))returnchr(valeur_code)
Définir la fonction decodage_chaine dont la spécification est
defdecodage_chaine(chaine_code:str)->str:"""
Décode la chaine dont le code est passé
en argument.
Hypothèse : les caractères sont codés sur un octet
"""
Définir la fonction dechiffrement dont la spécification est
defdechiffrement(code_chaine_chiffree:str,cle:str)->str:"""
Réalise la déchiffrement de chaine (codée) à l'aide de
la clé.
Méthode : chaine xor cle
"""
Physique, Chimie et Informatique > Terminales Spé. NSI
Les systèmes d'exploitation
Toute machine est dotée d’un système d’exploitation qui a pour fonction de charger les programmes depuis la mémoire de masse et de lancer leur exécution en leur créant des processus, de gérer l’ensemble des ressources, de traiter les interruptions ainsi que les entrées-sorties et enfin d’assurer la sécurité globale du système.
Au programme de la classe de première
Contenus
Capacités attendues
Commentaire
Systèmes d’exploitation
- Identifier les fonctions d’un système d’exploitation. - Utiliser les commandes de base en ligne de commande. - Gérer les droits et permissions d’accès aux fichiers.
- Les différences entre systèmes d’exploitation libres et propriétaires sont évoquées. - Les élèves utilisent un système d’exploitation libre. - Il ne s’agit pas d’une étude théorique des systèmes d’exploitation.
Au programme de la classe de terminale
Contenus
Capacités attendues
Commentaire
Composants intégrés d’un système sur puce.
Identifier les principaux composants sur un schéma de circuit et les avantages de leur intégration en termes de vitesse et de consommation.
Le circuit d’un téléphone peut être pris comme un exemple : microprocesseurs, mémoires locales, interfaces radio et filaires, gestion d’énergie, contrôleurs vidéo, accélérateur graphique, réseaux sur puce, etc.
Gestion des processus et des ressources par un système d’exploitation.
- Décrire la création d’un processus, l’ordonnancement de plusieurs processus par le système. - Mettre en évidence le risque de l’interblocage (deadlock).
- À l’aide d’outils standard, il s’agit d’observer les processus actifs ou en attente sur une machine. - Une présentation débranchée de l’interblocage peut être proposée.
À l’aide d’un éditeur de texte, écrire le programme Python suivant :
fromos.pathimportgetsizefromtkinter.filedialogimportaskopenfilenamefichier=askopenfilename()iffichier:print("Fichier a pour taille {} octets".format(str(getsize(fichier))))
Exécuter le programme.
À l’aide de la fonction help préciser le rôle des fonctions getsize du module os et askopenfilename du module tkinter.filedialog.
Réponse
askopenfilename du module tkinter.filedialog crée une boite de dialogue permettant de sélectionner un fichier.
Plus précisément, cette fonction retourne une chaîne de caractères contenant le chemin du fichier à ouvrir.
La chaîne de caractères est vide si aucun fichier n’est sélectionné.
getsize du module os retourne la taille en octets du fichier passé en argument.
Ce petit programme permet d’illustrer les différentes fonctionnalités d’un système d’exploitation. Nous allons les découvrir à travers quelques questions.
L’éxécution de ce programme empêche-t-elle d’utiliser en même temps d’autres programmes ?
Le comportement précédent est-il du à un effort particulier du programmeur (vous donc) ?
Le programme précédent est-il toujours utilisable si le fichier se trouve sur une clé USB ? Sur une autre partition du disque dur ?
La durée de réponse du programme dépend-elle de la taille du fichier sélectionné ?
Le fonctionnement du programme dépend-il de la taille de l’écran, du fait d’utiliser une souris ou un pavé tactile ?
Actuellement, sur votre ordinateur, le nombre de programmes en cours d’exécution est :
Plus grand que le nombre de processeurs ;
Égal au nombre de processeurs ;
Inférieur au nombre de processeurs.
Essayer de résumer les quelques fonctionnalités que les questions précédentes ont essayé de faire émerger.
Réponse
Info
Pendant l’exécution du programme, le système continu de fonctionner, un mécanisme semble donc permettre à plusieurs programmes de s’exécuter en parallèle.
Le nombre de programmes qui s’exécute à un instant donné est supérieur au nombre de processeurs présents sur la machine.
Tous les composants matériels (stockage, affichage, entrées) sont accessibles sans que le programmeur du programme ait à se préoccuper de quoi que ce soit.
Des informations (méta-données) semblent accompagner les fichiers. L’accès à leur taille, par exemple, est indépendant de leur contenu.
Système d’exploitation
À retenir
Un système d’exploitation est un programme ou un ensemble de programmes dont la fonction est la gestion des ressources matérielles et logicielles d’un ordinateur.
Un système d’exploitation permet :
l’exécution de processus ;
la lecture et l’écriture d’informations ;
la manipulation de fichiers ;
à plusieurs usagers et processus de se partager les ressources de l’ordinateur « simultanément » ;
la communication entre ordinateurs ;
…
À retenir
Parmi les différents composants logiciels que l’on trouve dans un système d’exploitation, on identifie :
L’ordonnanceur, qui « décide » quel processus est exécuté à un instant donné par un processeur.
Le gestionnaire de mémoire, qui répartit la mémoire vive entre les différents processus en cours d’exécution.
Le gestionnaire du système de fichiers, qui définit comment sont organiser les informations sur les supports physiques.
La pile réseau qui implémente, entre autres, les protocoles tels que Ethernet, IP, TCP, …
Le gestionnaire de périphériques qui gère les accès au matériel (carte graphique, disques durs, clavier, souris, écran, imprimante, …)
Un logiciel est dit libre si son code est couvert par une licence autorisant :
l’utilisation du logiciel ;
l’accès public au code source ;
la modification et la redistribution publique de ces modifications.
Introduction
Il est possible de commander les systèmes d’exploitation de la famille UniX et leurs dérivés (tels OS X et Linux) grâce à un logiciel appelé shell, en ligne de commandes. À l’ère de l’interface graphique et des écrans tactiles, on peut se demander pourquoi continuer à taper des commandes, processus qui semble beaucoup plus long et nécessite un apprentissage préalable. En fait, une fois les commandes maîtrisées, utiliser la ligne de commande s’avère beaucoup plus efficace pour réaliser des tâches non élémentaires.
Exemple de tâche
Se rendre dans un répertoire contenant une multitude d’images dans différents formats, compter le nombre de celles qui sont au format jpeg et stocker le résultat dans un fichier.
cd /chemin/vers/repertoire; ls -l | grep jpeg | wc -l > nbre_jpg.txt
Essayez de faire le même enchaînement d’opérations depuis une interface graphique, cela prendra sûrement plus de temps.
Invite de commande, commandes et paramètres des commandes
Invite de commande
On appelle Invite de commande le message qui « invite » à entrer une commande dans la console/terminal :
mats@serveur-ubuntu:~$
Ici, il faut comprendre que l’utilisateur mats est connecté à la machine de nom serveur-ubuntu et qu’il se situe, dans l’arborescence des fichiers, dans son dossier personnel (représenté par le symbole ~).
Avertissement
Le symbole dollar $ final signifie que l’utilisateur mats n’est pas l’administrateur de la machine. Lorsqu’on utilise la machine en tant qu’administrateur, appelé root sous UniX, le symbole terminal est #.
Commandes
L’invite de commande permet d’entrer des commandes. Le comportement de chacune de ces commandes peut être modifié ou précisé à l’aide d’options*.
Le résultat de la commande, la liste de ses options, leur emploi, etc. font l’objet d’une entrée dans la documentation déjà installée sur le système.
man ls # lecture de la page de documentation de la commande ls
date # Retourne la date du jourdate +%Y-%m-%d # Retourne la date du jour dans le format Année-Mois-Jourls # Liste tous les fichiers et dossiers du dossier courantls -l -a -R # Liste tous les fichiers et dossiers du dossier courant # avec des options supplémentaires : affichage long de tous les# fichiers (cachés ou pas) récursif
Remarque
Lorsque plusieurs options sont utilisées, il est possible de condenser l’écriture de la commande. Par exemple, la commande ls -l -a -R peut s’écrire : ls -laR. L’ordre de ces options n’a aucune importance.
De nombreuses aide à la saisie existent :
Rappel des dernières commandes entrées : utiliser la touche ↑ du clavier.
Autocomplétion des commandes :
entrer les premiers caractères d’une commande et taper la touche⇥deux foix : la liste des commandes commençant par ces caractères apparaît.
entrer les premiers caractères d’une commande, si cette chaîne est suffisante pour que le système puisse identifier de façon certaine la commande, un appui sur ⇥ complète la commande.
Sélection multiple de fichiers : le caractère *, appelé joker est très utilisé.
ls -l *.jpeg # liste tous les fichiers dont l'extension est .jpeg
Quelques raccourcis clavier utiles :
CTR + L : efface le contenu du terminal
CTRL + A : ramène le curseur au début de la commande
CTRL + E : ramène le curseur à la fin de la ligne de commandes
CTRL + U : supprime tout ce qui est à gauche du curseur
CTRL + K : supprime tout ce qui est à droite du curseur
CTRL + W : supprimer le premier mot situé à gauche du curseur
CTRL + Y : si du texte a été supprimé à l’aide d’une des commandes précédentes, ce texte est copié à l’endroit où se trouve le curseur.
Les fichiers
Qu’est-ce qu’un fichier ?
À retenir
Les fichiers servent à stocker des informations de manière permanente, entre deux exécutions d’un programme.
Rappel
Le contenu des variables disparaît à chaque fin d’exécution d’un programme (ou du bloc d’instructions dans lequel la variable est définie). Les fichiers sont stockés sur des périphériques à mémoire de masse (disquette, disque dur, CD Rom, clé USB, etc.).
À retenir
En informatique, on utilise le terme fichier pour décrire trois notions bien distinctes :
Le fichier physique, succession de 0 et de 1 sur un support physique (disque dur, disque optique, etc.).
Le fichier logique, objet informatique que nous présente le système d’exploitation. Cet objet est une image du fichier physique. Les fichiers logiques sont organisés sous forme d’une arborescence qui dépend du système d’exploitation utilisé, et sont repérés par un nom auquel on accole une extension (.py pour un fichier source Python, .jpeg pour une image au format JPEG (acronyme de Joint Photographic Experts Group), .exe pour un fichier
exécutable, etc.).
Généralement, un fichier logique possède des attributs gérés par le système d’exploitation (qui a le droit de le lire, de le modifier, de le détruire, etc.).
L’objet qui, dans un langage de programmation, est associé au fichier logique. Nous avons tel objet en Python.
Fichier physique
À retenir
Un périphérique à mémoire de masse stocke simplement des informations binaires (bits). À ce niveau, aucune distinction entre une image, un texte, un son, etc. n’existe : un fichier physique est un regroupement de 0 et de 1, stockés sur ce périphérique.
Info
Un système d’exploitation (Windows, Linux, OS X, FreeBSD, etc.) sait quels blocs physiques il faut réunir pour former un fichier logique (fichier image, fichier texte, fichier son, etc.).
Le nombre de bits qu’un périphérique de masse peut stocker est appelé sa capacité. Un disque d’un téraoctet (symbole To) peut stocker 240 mots de 8 bits.
Organisation des fichiers logiques en une arborescence
Les fichiers logiques sont organisés sous forme d’une arborescence :
graph TD
A(".") --> B("bin")
A --> C("boot")
A --> D("dev")
A --> E("etc")
A --> F("home")
A --> G("lib")
A --> H("media")
A --> I("root")
A --> J("sbin")
A --> K("tmp")
A --> L("usr")
A --> M("var")
F --> FA("user1")
F --> FB("LLM")
FB --> FBA("student1")
FB --> FBB("student2")
FB --> FBC("student3")
FBB --> FBBA("Documents")
FBB --> FBBB("Images")
FBB --> FBBC("Musique")
FBB --> FBBD("Bureau")
FBB --> FBBE("Téléchargements")
FBB --> FBBF("Vidéos")
FBBA --> FBBAA("NSI")
FBBA --> FBBAB("PC")
Chemin d’un fichier
Repérer un fichier logique dans l’arborescence consiste à donner son chemin dans cette arborescence :
Chemin absolu d’un fichier.
Dans une arborescence, le chemin (absolu) d’un fichier est la liste des noms des nœuds de la branche qui va de la racine de l’arborescence jusqu’au fichier en question.
/home/LLM/student2/Images/chaton.jpeg
Chemin relatif d’un fichier.
Lorsque le chemin qui conduit au fichier ne débute pas au niveau de la racine mais depuis l’endroit dans lequel on se trouve dans l’arborescence, le chemin est dit relatif.
Sous Unix, tout n’est que fichier : en particulier, un dossier est un fichier qui contient la liste des fichiers placés plus bas que lui dans l’arborescence. On exprime donc le chemin d’un dossier de la même façon que celle d’un fichier.
Quelques commandes de déplacement dans l’arborescence des fichiers et de manipulation des fichiers
pwd (print working directory) : affiche le chemin absolu de l’endroit où l’on se trouve dans l’arborescence du système de fichiers.
which nom_commande : affiche le chemin absolu de l’emplacement de la commande nom_commande dans le système de fichiers.
ls : liste le contenu du dossier courant.
Options utiles :
a (all) : les fichiers cachés sont inclus dans l’affichage ;
l (long) : affiche toutes les informations (droits, types, etc.) ;
F: ajoute un / à la fin des noms des dossiers afin de les mettre en évidence ;
h (human readable) : utilisé avec l’option l exprime les tailles en multiples d’octets ;
S : trie le résultat final par taille des fichiers décroissante ;
t : trie les fichiers par date de dernière modification ;
r : renverse l’ordre de tri des deux paramètres précédents ;
R (recursive) : affiche le contenu des sous-dossiers.
cd (change directory) : permet de se déplacer dans l’arborescence. Le chemin passé en argument peut être absolu ou relatif.
du (disk usage) : donne la taille occupée par les répertoires situés plus bas dans l’arborescence que le point d’où est lancée la commande.
Options utiles :
h (human readable) : les tailles sont affichées en multiples d’octets ;
a : les dossiers et les fichiers sont pris en compte ;
s : seul le résultat final est affiché.
cat : affiche le contenu d’un fichier texte à l’écran.
less : affiche le contenu d’un fichier texte à l’écran, page par page. Taper sur la touche Espace pour passer à la page suivante, la touche b pour passer à la page précédente et la touche q pour quitter.
touch : permet de créer un fichier vide (ou de mettre à jour la date de modification).
mkdir (make directory) : crée le dossier dont le nom est passé en argument.
Option utile :
p : créé un sous-dossier et tous les sous-dossiers intermédiaires si nécessaire.
cp (copy) : copie un fichier ailleurs dans l’arborescence.
Option utile :
r : permet de copier un dossier et les fichiers contenus dans ce dernier.
mv (move) : déplace un fichier ou un dossier dans l’arborescence.
mv : renomme un fichier ou un dossier.
rm (remove) : supprime un fichier.
Options utiles :
i : demande confirmation avant toute action ;
f (force) : la suppression est effectuée quoi qu’il arrive ;
v (verbose) : affiche toutes les informations ;
r (recursive) : supprime un dossier et tout son contenu.
rmdir (remove directory) : supprime un dossier vide.
Méta-données d’un fichier logique
La commande ls -l permet d’obtenir un certain nombre d’informations sur les fichiers (ou dossiers) :
ubuntu@serveur-ubuntu:~/Images$ ls -lh t2png-2.gif
-rw-rw-r-- 1 ubuntu ubuntu 74K Dec 9 18:40 t2png-2.gif
ubuntu@serveur-ubuntu:~$ ls -lh
total 4.0K
drwxrwxr-x 2 ubuntu ubuntu 4.0K Dec 9 18:41 Images
On peut décomposer cette sortie de la sorte :
-
rw-
rw-
r--
1
ubuntu
ubuntu
74K
Dec 9 18:40
t2png-2.gif
1
2
3
8
4
6
7
8
9
10
À retenir
Type de fichier : - ordinaire, d répertoire, l lien symbolique.
Droits de l’utilisateur propriétaire (généralement le créateur du fichier) : rwx droits de lecture (read), d’écriture (write) et d’exécution (execute) si programme.
Droits du groupe propriétaire (généralement celui du créateur du fichier) : rwx droits de lecture (read), d’écriture (write) et d’exécution (execute) si programme.
Droits de tous les utilisateurs de l’ordinateur : rwx droits de lecture (read), d’écriture (write) et d’exécution (execute) si programme.
Nombre de liens « durs ». C’est le nombre de noms de fichiers qui référencent ce fichier.
Identifiant du propriétaire du fichier.
Identifiant du groupe propriétaire du fichier.
Taille du fichier en octets.
Date de dernière modification du fichier.
Nom du fichier.
Travail
Notions de base
Soit l’invite de commande suivante :
toto@einstein:~/Documents/Photos
Quelles informations nous fournit cette invite de commande ?
Comment rappeler la dernière commande saisie au clavier ?
Un programme exécutable est-il un fichier spécial ?
Les extensions des fichiers ont-elles une signification particulière sous Linux ?
Dans la liste suivante, indiquer les chemins absolus :
Où que l’on se situe dans le système de fichiers, quel est l’effet de la commande :
cd ~
Pour lister de manière récursive tous les fichiers — sans exception — présents dans /usr, quelle commande faut-il taper ?
Dans un répertoire contenant une multitude de fichiers, comment afficher la liste détaillée des fichiers, les derniers modifiés apparaissant en dernier dans cette liste (en bas de l’écran) ?
Pour créer le plus simplement possible, dans son dossier personnel, des sous-dossiers formant le chemin suivant : programmes/python/backup, il faut taper :
Déplacez-vous dans le répertoire dossier1en utilisant un chemin absolu et créez-y le fichier vide fichier1.
Copiez le fichier fichier1 dans le répertoire dossier3en utilisant un chemin relatif.
Déplacez-vous dans le dossier dossier2en utilisant un chemin relatif.
Copiez le fichier fichier1 dans le répertoire dossier5 en le renommant fichier2.
Déplacez le fichier fichier2 dans le répertoire dossier4 en le renommant fichier3.
Supprimez le fichier fichier1 du répertoire dossier3.
Retournez dans votre dossier personnel et supprimez tous les fichiers et dossiers qui viennent d’être créés.
À la recherche du texte perdu
Le répertoire MetaCaracteres vous est fourni. Avec la commande ls MetaCaracteres, vous constaterez alors que ce répertoire contient de très nombreux fichiers. Les méta-caractères permettent de définir des motifs à partir desquels une sélection des éléments affichés peut être effectuée.
Motifs possibles
* : représente n’importe quelle suite de caractères (vide ou non) ;
? : représente n’importe quel caractère (exactement un) ;
[liste de caractères] : représente n’importe quel caractère de la liste (exactement un). La liste peut-être un intervalle (a-z par exemple), le code ASCII des caractères est pris en considération pour définir les caractères appartenant à l’intervalle ;
[^liste de caractères] : représente n’importe quel caractère qui n’est pas dans la liste (exactement un).
Exemples
ls img*.jpg # liste tous les noms de fichiers qui commencent par img et se terminent par .jpg avec 0 ou plusieurs caractères entre les deux motifs.ls img?.jpg # liste tous les noms de fichiers qui commencent par img et se terminent par .jpg avec exactement un caractère entre les deux motifs.ls img[1234].jpg # liste img1.jpg, img2.jpg, img3.jpg, img4.jpg s'ils existent.ls [^abc]* # liste tous les noms de fichiers qui ne commencent ni par a, ni par b, ni par c.ls [^A-Z]* # liste tous les noms de fichiers qui ne commencent pas par une majuscule.ls img?*[23].jpg # liste tous les noms de fichiers qui commencent par img, se terminent par .jpg avec entre un ou plusieurs caractères suivis d'un 2 ou d'un 3.
Exercice
Donner la signification de chacun des motifs suivants :
*.jpg
[0-9]*[a-z]
*.???
*[^A-Z]*
?????
?*?
*[^.]???
Tester les réponses dans un terminal. Pour ce faire, créer dans un dossier un certain nombre de fichiers vides à l’aide de la commande touch nom_fichier (utiliser tous les noms possibles et imaginables).
Réponses
Tous les noms qui se terminent par .jpg.
Tous les noms qui commencent par un chiffre et se terminent par une lettre en minuscule.
Tous les noms qui possèdent une extension (après le .) composée de trois caractères exactement.
Tous les noms qui en contiennent aucune lettre en majuscule.
Tous les noms formés de cinq caractères.
Tous les noms formés d’au moins deux caractères.
Tous les noms formés d’au moins quatre caractères et dont le quatrième caractère en partant de la droite n’est pas un point.
Déterminez les éléments du répertoire MetaCaracteres dont le nom correspond à chacun des motifs suivants et expliquez brièvement les caractéristiques des éléments affichés.
Prompt$ ls *
Prompt$ ls ?
Prompt$ ls [a-c]?
Prompt% ls [ac]?
Prompt% ls [a-c]*
Prompt% ls *.txt
L’énoncé de cette question se trouve dans le fichier MetaCaracteres/questionTP1.txt. La commande cat suivie d’un nom de fichier vous permettra d’afficher le contenu du fichier, et donc de pouvoir le lire et de suivre les indications que vous y trouverez.
Physique, Chimie et Informatique > Terminales Spé. NSI > Les systèmes d'exploitation
Gestion des processus et des ressources
L’objectif de ce document est d’essayer de faire comprendre les idées mises en œuvre lors de l’écriture des système d’exploitation afin qu’un nombre de programmes plus important que le nombre de processeurs puisse fonctionner « simultanément ».
L’ordonnanceur
Rappel sur l’exécution d’un programme
À retenir
Un programme est un fichier contenant une suite d’instructions écrites en langage machine. C’est une suite d’octets que le processeur est capable de décoder et d’exécuter.
Actions du système d’exploitation au lancement d’un programme :
Le contenu du fichier contenant le programme est copié dans la mémoire vive (RAM), à une certaine adresse a.
Le système d’exploitation écrit l’adresse a dans le registre IP (instruction pointer).
Au cycle d’horloge du processeur suivant, ce dernier lit l’instruction qui se trouve dans le registre IP et l’exécute. Par la suite, il exécute la deuxième instruction puis les suivantes.
Remarque
L’exécution d’une instruction par le processeur se décompose en en plusieurs sous-étapes : le chargement (récupération de l’instruction en mémoire), le décodage (quelle action est codée par la suite d’octets) et l’exécution.
Interruptions
La description précédente est correcte mais incomplète : elle laisse penser qu’une fois un programme lancé le processeur se focalise sur son exécution, au détriment de l’exécution de tout autre programme.
À retenir
Une interruption est un signal envoyé au processeur lorsqu’un évènement se produit.
Il existe plusieurs types d’interruptions :
les interruptions générées par le matériel (un disque dur signale qu’il a fini d’écrire un octet, une carte réseau signale qu’une trame vient d’arriver, …)
les interruptions d’horloges générées par le processeur (historiquement toutes les 55ms, toutes les 100ns de nos jours).
Lorsqu’un processeur reçoit une interruption il interrompt son exécution à la fin de l’instruction courante et exécute un programme se trouvant à une adresse prédéfinie.
Ce programme, le gestionnaire d’interruption, reçoit une copie des valeurs courante des registres, ainsi qu’un code numérique lui permettant de savoir quel est le type de l’interruption qui a stoppé le processeur.
Info
On utilise les interruptions, principalement dans deux buts :
permettre des communications non bloquantes avec des périphériques externes ;
commuter entre les tâches dans un ordonnanceur.
Les interruptions constituent le fondement de l’exécution concurrente des programmes.
Vocabulaire
À retenir
Exécutable
Fichier binaire contenant des instructions en langage machine directement exécutables par le processeur de la machine.
Processus
Instance du programme en cours d’exécution. Un système d’exploitation identifie généralement les processus par un numéro unique.
Un processus est décrit par :
L’ensemble de la mémoire allouée par le système d’exploitation pour l’exécution du programme (instructions codées et données manipulées, qu’elles soient contenues dans la pile ou sur le tas) ;
L’ensemble des ressources utilisées par le programme (fichiers ouverts, connexions réseau, etc.) ;
Les valeurs stockées dans tous les registres du processeur.
Thread ou tâche
Éxécution d’une suite d’instructions démarrée par un processus. Deux processus sont l’exécution de deux programmes différents (traitement de texte et navigateur web, par exemple). Deux threads sont l’exécution concurrente de deux suites d’instructions d’un même processus (téléchargement d’une page web et affichage d’une page web).
Exécution concurrente
Deux processus ou threads s’exécutent de manière concurrente s’ils se partagent l’accès à un processeur. Ils ne s’exécutent donc pas au même moment.
Exécution parallèle
Deux processus ou threads s’exécutent en parallèle s’ils s’exécutent au même instant. Plusieurs processeurs dans l’ordinateur sont donc nécessaires à une exécution parallèle.
Avertissement
Les processus sont isolés par le système d’exploitation, ils ne partagent pas la même zone de la mémoire alors que les threads issus d’un même processus peuvent accéder aux variables globales du programme et occupent le même espace mémoire.
Nom
Description
PID
Process ID, l’identifiant numérique du processus
État
L’état dans lequel se trouve le processus
Registres
La valeur des registres lors de la dernière interruption
Mémoire
Zone mémoire (plage d’adresses) allouée par le processus lors de son exécution
Ressources
Liste des fichiers ouverts, connexions réseau en cours d’utilisation, etc.
Informations pour la description d’un Processus.
Ordonnanceur du système d’exploitation
À retenir
Le système d’exploitation utilise des interruptions pour « reprendre la main » et décider quel programme en cours d’exécution doit avoir accès au processeur.
Exemple
Le processus « traitement de texte » a accès au processeur. Il est en cours d’exécution.
Une interruption d’horloge se déclenche.
Le code du gestionnaire d’interruption est appelé. Il reçoit comme arguments les valeurs de tous les registres avant le déclenchement de l’interruption (donc tout ce qui concerne le processus ayant accès au processeur).
Le gestionnaire d’interruption sauvegarde ces valeurs à un endroit particulier de la mémoire.
Le gestionnaire d’interruption choisit dans la liste des processus un processus en attente, par exemple celui correspondant à un navigateur web.
Il restaure les valeurs des registres qu’il avait sauvegardés lors de la dernière interruption du navigateur web.
Parmi ces registres, il y a en particulier IP, le pointeur d’instruction, qui contient l’adresse de la prochaine instruction à exécuter.
Le gestionnaire d’interruption a fini son travail et « rend la main ». Le processeur exécute le code du processus lié au navigateur web jusqu’à la prochaine interruption.
Info
On appelle commutation de contexte l’action d’interrompre un processus et de sauvegarder son état. C’est l’ordonnanceur qui est en charge de cette tâche.
Afin de pouvoir décider à quel processus donner la main, l’ordonnanceur utilise une structure de données telle qu’une file pour stocker la liste des processus et ainsi partager les tâches.
États d’un processus
Info
Les interruptions ne se limitent pas aux interruptions d’horologes, un processus peut être en attente d’une action d’un utilisateur, de la réception d’une trame, du résultat de la recherche d’une information sur un disque dur, etc. Un processus peut donc être interrompu et mis en attente par le système d’exploitation qui favorise alors d’autres processus.
À retenir
La plupart des systèmes d’exploitation définissent différents états pour les processus :
Nouveau
État d’un processus en cours de création. Le système d’exploitation vient de copier le code exécutable en mémoire.
Prêt
Le processus est dans la file des processus à exécuter et attend d’être choisi par l’ordonnanceur.
En exécution
Le processus est en train d’être exécuté.
En attente
Le processus est en interrompu et en attente d’un évènement externe (entrée/sortie, allocation mémoire, etc).
Terminé
Le processus est terminé. Le système d’exploitation est en train de désallouer les ressources que le processus utilisait.
> Cycle de vie d'un processus
Info
Les états Nouveau et Terminé sont temporaires. Normalement l’état d’un processus varie entre Prêt, En attente et En exécution.
L’ordonnancement
Plusieurs processus peuvent donc être dans l’état prêt : comment choisir celui qui sera élu ?
À retenir
L’ordonnanceur (scheduler) classe les processus prêts dans une file et le répartiteur (dispatcher) alloue quant à lui un processeur à l’élu dans le cas d’une architecture multiprocesseur.
Info
Il existe plusieurs politiques d’ordonnancement dont le choix va dépendre des objectifs du système.
Quelques exemples :
Premier arrivé, premier servi : simple, mais peu adapté à la plupart des situations.
Plus court d’abord : très efficace, mais il est la plupart du temps impossible de connaître à l’avance le temps d’exécution d’un processus.
Priorité : le système alloue un niveau de priorité aux processus (SCHED_FIFO sur Linux). Cependant des processus de faible priorité peuvent ne jamais être élus.
Tourniquet : un quantum de temps est alloué à chaque processus (SCHED_RRsous Linux). Si le processus n’est pas terminé au bout de ce temps, il est mis en bout de file en état prêt.
Un système hybride entre tourniquet et priorité qu’on retrouve dans les systèmes Unix.
Commandes Unix de gestion des processus
Info
ps (process status) est la commande de base pour lister tous les processus en cours. Options utiles :
a: tous les processus ;
u : nom des utilisateurs qui ont lancé le processus ;
x : fait aussi apparaître les processus qui n’ont pas été lancés depuis la ligne de commande.
R (Running ou Runnable) : le processus est dans l’état Prêt ou En exécution.
S(Sleeping) : le processus est En attente.
Info
top permet en temps réel les processus en cours.
ubuntu@serveur-ubuntu:~$ top
top - 07:12:34 up 15 min, 1 user, load average: 0.00, 0.05, 0.14
Tasks: 113 total, 1 running, 111 sleeping, 1 stopped, 0 zombie
%Cpu(s): 0.0 us, 0.2 sy, 0.0 ni, 99.8 id, 0.0 wa, 0.0 hi, 0.0 si, 0.0 st
MiB Mem : 1983.9 total, 678.0 free, 142.0 used, 1163.9 buff/cache
MiB Swap: 0.0 total, 0.0 free, 0.0 used. 1648.7 avail Mem
PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND
935 ubuntu 2001480860484564 S 0.3 0.3 0:00.18 sshd
8441 ubuntu 2001186440883424 R 0.3 0.2 0:00.03 top
1 root 200169776132808796 S 0.0 0.7 0:07.13 systemd
2 root 200000 S 0.0 0.0 0:00.01 kthreadd
3 root 0 -20 000 I 0.0 0.0 0:00.00 rcu_gp
4 root 0 -20 000 I 0.0 0.0 0:00.00 rcu_par_gp
6 root 0 -20 000 I 0.0 0.0 0:00.00 kworker/0:0H-kblockd
9 root 0 -20 000 I 0.0 0.0 0:00.00 mm_percpu_wq
Le processus qui monopolise le plus le processeur apparaît dans la première ligne.
À retenir
Un système d’exploitation en fonctionnement est constitué par un ensemble de processus. Au démarrage de la machine, un processus père est lancé (historiquement c’est le processus init ou systemd sur Linux). Son rôle est par la suite de démarrer tous les autres processus.
Info
La hiérarchie des processus peut être visualisée grâce à la commande pstree.
L’exemple précédent montre que l’utilisateur ubuntu a accédé au serveur ubuntu par ssh et a lancé depuis le terminal (en ligne de commande donc) deux commandes qui s’exécutent en parallèle pstree et top. Les processus ont été créés par le processus bash.
Info
kill envoie un signal de terminaison aux processus dont le PID est passé en argument.
ubuntu@serveur-ubuntu:~$ kill8419
Programmation concurrente
Processus concurrents
Remarque : cette partie nécessite une bonne compréhension des sections 1.4, 1.5 et 1.6 de ce document.
La fonction getpid retourne le PID du processus qui la lance.
À quoi sert la fonction flush() ?
Réponse
La fonction flush donne un ordre d’écriture immédiate des caractères dans le fichier.
Prévoir ce que doit contenir le fichier.
Lancer le programme et vérifier la correction de la prédiction.
Réponse
Le fichier est constitué de 1000 lignes de la forme PID : i.
La première ligne est par exemple 418 : 0
La dernière ligne du même fichier est alors 418 : 999.
Depuis la console (shell), lancer trois fois le programme en une commande, en plaçant l’exécution de ces programmes en arrière plan (c’est le rôle de l’esperluette &).
Examiner le contenu du fichier test.txt et recommencer plusieurs fois l’opération. Quelles remarques peut-on faire ? Essayer de justifier ce comportement.
Réponse
On a l’impression que certaines lignes n’ont été écrites que par certains des processus et le choix du processus qui a écrit la ligne en question semble être aléatoire. Ils semblent s’être réparti les travaux d’écriture alors qu’ils fonctionnent indépendamment les uns des autres !!!
Justification. Chaque processus, lors de l’ouverture du fichier, enregistre la position du curseur d’écriture. À chaque écriture de caractères, ce curseur est avancé du nombre de caractères (octets en fait) correspondant.
Chaque fois qu’un processus est interrompu par l’ordonnanceur, il conserve en mémoire son état, en particulier la position du curseur au moment de l’interruption. Lorsqu’il est à nouveau appelé par la suite il reprend donc depuis cette position… et peut donc écraser les entrées des autres processus si ces derniers étaient plus avancés.
À retenir
Le fonctionnement multitâches d’un système d’exploitation est un avantage la plupart du temps mais soulève des problèmes lorsque des processus partagent des ressourcescar un processus ne sait pas qu’il est interrompu et reprend son travail dans l’état même dans son état au moment de l’interruption sans prendre en compte ce l’action des autres processus sur la ressource partagée.
Interblocage
Exemple 1
Trois élèves doivent réaliser lors d’un cours de math un travail à l’aide d’une règle et d’une équerre. Le premier élève n’a apporté qu’une règle, le deuxième qu’une équerre et le troisième a oublié toutes ses affaires.
Que devront-ils faire pour réaliser le travail demandé par le professeur ?
Des processus peuvent-ils procéder de la sorte (s’il n’ont pas été programmés pour) ?
Réponses
Les élèves doivent discuter et se mettre d’accord sur une stratégie d’utilisation du matériel.
Un processus d’enregistrement du son qui utilise une carte fonctionne de façon indépendante d’un processus qui diffuse du son à travers cette même carte réseau. Aucun dialogue n’existe entre les deux.
Exemple 2
Sur une route à deux sens, des travaux occupent la moitié de la route. Des véhicules roulant dans les deux sens se sont engagés simultanément et se retrouvent face à face. Plusieurs véhicules les ont suivis ; plus personne ne peut reculer. Le véhicule venant de la gauche occupe la partie de la route dont l’accès serait nécessaire au véhicule venant de la droite et inversement.
Exercice 3
Le même blocage peut intervenir dans un rond-point lorsque le traffic est dense si personne ne souhaite sortir à la première sortie mais plutôt à la sortie en face de l’entrée.
À retenir
On appelle interblocage (deadlock) la situation dans laquelle deux processus se bloquent mutuellement : le premier attend l’accès à une ressource mobilisée par le second qui lui-même attend l’accès à une ressource mobilisée par le premier.
L’origine de l’interblocage est l’accès exclusif à certaines ressources.
Exemple d’interblocage
Un processus p1 possède un accès exclusif à la ressource R1 alors qu’un processus p2 possède un accès exclusif à une ressource R2.
Le processus p1 a alors besoin d’un accès à la ressource R2 avant de pouvoir libérer R1. Comme la ressource R2 est occupée, ce processus est placé dans l’état En attente.
Le processus p2 passe dans l’état En exécution et essaie d’accéder à la ressource R1, sans avoir encore libéré R2. Comme R1 n’a pas encore été libéré par p1, la ressource n’est pas accessible et p2 est placé En attente.
Le processus p1 passe dans l’état En exécution et essaie d’accéder à la ressource R2. cette dernière n’est pas accessible et p1 est placé En attente.
Le processus p2 passe dans l’état En exécution et essaie d’accéder à la ressource R2. cette dernière n’est pas accessible et p2 est placé En attente.
….
Illustration d’une situation d’interblocage en Python
Écrire le programme suivant :
importthreadingdefhello(n):foriinrange(5):print("Je suis le thread {} et ma valeur est {}".format(n,i))print("Fin du Thread {}".format(n))forninrange(4):t=threading.Thread(target=hello,args=[n])t.start()
Étudier le programme. Expliquer le rôle des deux dernières lignes.
Réponse
Ce programme utilise des threads pour réaliser l’exécution en parallèle de la fonction hello.
Exécuter le programme. L’affichage est-il surprenant ?
Réponse
Comme pour les processus, les threads alternent leur exécution en fonction des commutations de contexte. L’ordre dans lequel sont démarrés les threads ne donne aucune indication sur l’ordre dans lequel ils peuvent se terminer.
Écrire le programme suivant :
importthreadingCOMPTEUR=0defincr():globalCOMPTEURforcinrange(100000):v=COMPTEURCOMPTEUR=v+1th=[]forninrange(4):t=threading.Thread(target=incr,args=[])t.start()th.append(t)fortinth:t.join()print("Valeur finale : {}".format(COMPTEUR))
Expliquer le rôle de l’instruction global COMPTEUR.
Réponse
COMPTEUR est une variable globale, accessible depuis une fonction mais non modifiable.
Pour outrepasser ce comportement, il faut utiliser le mot clé globla. On peut alors modifier la valeur de la variable depuis la fonction.
Expliquer le rôle de l’instruction t.join().
Réponse
Attend que le fil d’exécution se termine. Ceci bloque le fil appelant jusqu’à ce que le fil dont la méthode join est appelée se termine – soit normalement, soit par une exception non gérée – ou jusqu’à ce que le délai optionnel timeout soit atteint.
Exécuter le programme. L’affichage est-il surprenant ?
Réponse
Comme on a démarré 4 threads et que chacun d’eux effectue 100 000 tours de boucles, on pouvait s’attendre à ce que la valeur finale soit égale à 400 000. Ce n’est pas le cas.
Expliquer la valeur finale obtenue.
Réponse
Lorsqu’un thread est interrompu par la commutation de contexte, son état est conservé. Lorsque ce thread reprend son travail, il utilise la valeur de COMPTEUR lors de son arrêt et ne prend pas en compte les incrémentations réalisées par les autres threads alors qu’il était dans l’état En attente.
Info
Un verrou est un objet que l’on peut essayer d’acquérir. Si on est le premier à faire cette demande, on acquiert le verrou. On peut le rendre à tout moment. Si en revanche quelqu’un d’autre détient le verrou, on est bloqué jusqu’à ce que ce verrou soit libéré.
Écrire le programme suivant :
importthreadingverrou=threading.Lock()COMPTEUR=0defincr():globalCOMPTEURforcinrange(100000):verrou.acquire()v=COMPTEURCOMPTEUR=v+1verrou.release()th=[]forninrange(4):t=threading.Thread(target=incr,args=[])t.start()th.append(t)fortinth:t.join()print("Valeur finale : {}".format(COMPTEUR))
Expliquer pourquoi on obtient bien maintenant la valeur 400000.
Quelle situation essaie-t-il d’illustrer ? Justifier la réponse.
Exécuter le programme plusieurs fois. La situation prévue à la question précédente intervient-elle vraiment ? Pourquoi ?
Ajouter les lignes
foriinrange(100000):continue
au dessous de l’instruction print("Section critique 1.1").
Expliquer pourquoi le comportement du programme a été modifié.
À retenir
À retenir
Les systèmes d’exploitation multitâches sont la norme. Ils permettent d’exécuter de façon concurrente plusieurs programmes. L’exécution d’un programme s’appelle un processus. C’est le système d’exploitation, et en particulier l’ordonnanceur, qui determine quel processus s’exécute à un instant donné. Le fait pour un processus d’être interrompu s’appelle une commutation de contexte. Plusieurs processus s’exécutant de façon concurrente peuvent s’interbloquer s’ils attendent un accès à une même ensemble de ressources en accès exclusif. Les threads ou processus légers sont des « sous-processus » s’exécutant de manière concurrente. L’accès à des ressources par plusieurs threads peut être protégé par des verrous.
Physique, Chimie et Informatique > Terminales Spé. NSI > Les systèmes d'exploitation
Gestion des processus et des ressources : Annales
Exercice 1
Dans un bureau d’architectes, on dispose de certaines ressources qui ne peuvent pas être utilisées simultanément par plus d’un processus, comme l’imprimante, la table traçante, le modem. Chaque programme, lorsqu’il s’exécute, demande l’allocation des ressources qui lui sont nécessaires. Lorsqu’il a fini de s’exécuter, il libère ses ressources.
On appelle p1, p2 et p3 les processus associés respectivement aux programmes 1, 2 et 3.
Les processus s’exécutent de manière concurrente.
Justifier qu’une situation d’interblocage peut se produire.
Réponse
Pour passer à l’état exécution, le processus p1 doit pouvoir accéder au modem alors que celui-ci est monopolisé par le processus p2. Il doit donc attendre que p2 libère le modem.
Pour passer à l’état exécution, le processus p2 doit pouvoir accéder à l’imprimante alors que celle-ci est monopolisée par le processus p3. Il doit donc attendre que p3 libère l’imprimante.
Pour passer à l’état exécution, le processus p3 doit pouvoir accéder à la table traçante alors que celle-ci est monopolisée par le processus p1. Il doit donc attendre que p1 libère la table traçante, ce qu’il ne fera pas car il est bloqué, dans l’attente d’un accès au modem.
La situation décrite constitue donc bien un interblocage.
Modifier l’ordre des instructions du programme 3 pour qu’une telle situation ne puisse pas se produire. Aucune justification n’est attendue.
Réponse
Il faut que le processus p2 puisse achever sa tache et libérer le modem pour que p1 puisse s’executer. Comme p3 a aussi besoin de la table traçante, comme p1, il faut faire en sorte qu’il soit immédiatement bloqué sans monopoliser aucune ressource :
L’imprimante n’est alors plus bloquée par p3, ce qui permet à p2 de s’exécuter complètement et de libérer les ressources que p1 peut alors utiliser. Pour finir, une fois p1 terminé, p3 peut s’exécuter.
Supposons que le processus p1 demande la table traçante alors qu’elle est en cours d’utilisation par le processus p3. Parmi les états suivants, quel sera l’état du processus p1 tant que la table traçante n’est pas disponible :
a. élu
b. bloqué
c. prêt
d. terminé
Correction
Le processus sera bloqué.
Exercice 2
Un constructeur automobile utilise des ordinateurs pour la conception de ses véhicules.
Ceux-ci sont munis d’un système d’exploitation ainsi que de nombreuses applications parmi lesquelles on peut citer :
un logiciel de traitement de texte ;
un tableur ;
un logiciel de Conception Assistée par Ordinateur (CAO) ;
un système de gestion de base de donnée (SGBD).
Chaque ordinateur est équipé des périphériques classiques : clavier, souris, écran et est relié à une imprimante réseau.
Ce constructeur automobile intègre à ses véhicules des systèmes embarqués, comme par exemple un système de guidage par satellites (GPS), un système de freinage antiblocage (ABS).
Ces dispositifs utilisent des systèmes sur puces (SoC : Système on a Chip).
Citer deux avantages à utiliser ces systèmes sur puces plutôt qu’une architecture classique d’ordinateur.
Réponse
Une grande partie de l’énergie est perdue lors des transferts des données entre les composants. Comme tous les composants d’un SoC sont connectés entre eux sur des distances très petites, et de manière interne sans câblage énergivore, les gains d’énergie sont très importants.
La faible consommation énergétique implique aussi une très faible perte de chaleur qui évite de recourir à un ventilateur pour refroidir la puce. Les SoC sont donc silencieux.
Le prix d’un système sur puce est très petit si on le compare à celui d’une carte mère rassemblant les mêmes composants (automatisation du processus de fabrication).
Le circuit d’un SoC est conçu de manière globale, tant pour la partie hardware que pour celle des programmes intégrés dans les différents composants qui leur permettent d’assurer leurs fonctions. Cette vue d’ensemble du système, sans aucune possibilité d’ajouter ou changer les composants, est un avantage important pour garantir la sécurité du système.
Un ingénieur travaille sur son ordinateur et utilise les quatre applications citées au début de l’énoncé.
Pendant l’exécution de ces applications, des processus mobilisent des données et sont en attente d’autres données mobilisées par d’autres processus.
On donne ci-dessous un tableau indiquant à un instant précis l’état des processus en cours
d’exécution et dans lequel D1, D2, D3, D4 et D5 sont des données.
La lettre M signifie que la donnée est mobilisée par l’application ; la lettre A signifie que l’application est en attente de cette donnée.
Lecture du tableau : le logiciel de traitement de texte mobilise (M) la donnée D1 et est en attente (A) de la donnée D2.
D1
D2
D3
D4
D5
Traitement de texte
M
A
-
-
-
Tableur
A
-
-
-
M
SGBD
-
M
A
A
-
CAO
-
-
A
M
A
Montrer que les applications s’attendent mutuellement.
Comment s’appelle cette situation ?
Réponse
Les application SGBD et CAO attendent mutuellement la Donnée D3. Il y a donc un interblocage. D2, D4 et D5 ne pourront pas être libérées. Le traitement de texte ne pourra obtenir D2. Le tableur ne pourra obtenir D5.
Ce constructeur automobile possède six sites de production qui échangent des documents entre eux. Les sites de production sont reliés entre eux par six routeurs A, B, C, D, E et F.
On donne ci dessous les tables de routage des routeurs A à F obtenus avec le protocole RIP :
Déterminer à l’aide de ces tables le chemin emprunté par un paquet de données envoyé du
routeur A vers le routeur F.
Réponse
ABEF.
On veut représenter schématiquement le réseau de routeurs à partir des tables de routage.
Recopier sur la copie le schéma ci-dessous :
En s’appuyant sur les tables de routage, tracer les liaisons entre les routeurs.
Correction
Exercice 3
Les états possibles d’un processus sont : prêt, élu, terminé et bloqué.
Expliquer à quoi correspond l’état élu.
Réponse
Un processus dans l’état élu est un processus qui a accès au processeur. Il est donc en cours d’exécution.
Proposer un schéma illustrant les passages entre les différents états.
Réponse
Cf. Cours.
On suppose que quatre processus C1, C2, C3 et C4 sont créés sur un ordinateur, et qu’aucun autre processus n’est lancé sur celui-ci, ni préalablement ni pendant l’exécution des quatre processus.
L’ordonnanceur, pour exécuter les différents processus prêts, les place dans une structure de données de type file. Un processus prêt est enfilé et un processus élu est défilé.
Parmi les propositions suivantes, recopier celle qui décrit le fonctionnement des entrées/sorties dans une file :
Premier entré, dernier sorti
Premier entré, premier sorti
Dernier entré, premier sorti
Réponse
Une file est une structure de données dans laquelle la donnée la plus ancienne sort la première. La réponse est donc : Premier entré, premier sorti.
On suppose que les quatre processus arrivent dans la file et y sont placés dans l’ordre C1, C2, C3 et C4.
Les temps d’exécution totaux de C1, C2, C3 et C4 sont respectivement 100ms, 150ms, 80ms et 60ms.
Après 40ms d’exécution, le processus C1 demande une opération d’écriture disque, opération qui dure 200ms. Pendant cette opération d’écriture, le processus C1 passe à l’état bloqué.
Après 20ms d’exécution, le processus C3 demande une opération d’écriture disque, opération qui dure 10ms. Pendant cette opération d’écriture, le processus C3 passe à l’état bloqué.
Sur la frise chronologique les états du processus C2 sont donnés.
Recopier la frise et la compléter avec les états des processus C1, C3 et C4.
Réponse
On trouvera ci- dessous deux programmes rédigés en pseudo-code.
Verrouiller un fichier signifie que le programme demande un accès exclusif au fichier et l’obtient si le fichier est disponible.
Programme 1
Programme 2
- Verrouiller fichier_1 - Calculs sur fichier_1 - Verrouiller fichier_2 - Calculs sur fichier_1 - Calculs sur fichier_2 - Calculs sur fichier_1 - Déverrouiller fichier_2 - Déverrouiller fichier_1
- Verrouiller fichier_2 - Verrouiller fichier_1 - Calculs sur fichier_1 - Calculs sur fichier_2 - Déverrouiller fichier_1 - Déverrouiller fichier_2
En supposant que les processus correspondant à ces programmes s’exécutent simultanément (exécution concurrente), expliquer le problème qui peut être rencontré.
Réponse
P1 verrouille le fichier_1 et P2 verrouille le fichier_2.
P1 attend le fichier_2 avant de pouvoir effectuer les calculs (et donc libérer le fichier_1).
P2 attend le fichier_1 avant de pouvoir effectuer les calculs (et donc libérer le fichier_2).
Il existe donc une situation d’interblocage.
Proposer une modification du programme 2 permettant d’éviter ce problème.
Réponse
Il faut inverser les 2 premières actions pour le programme 2 :
Verrouiller fichier_1
Verrouiller fichier_2
Physique, Chimie et Informatique > Terminales Spé. NSI
Bases de données
Le développement des traitements informatiques nécessite la manipulation de données de plus en plus nombreuses. Leur organisation et leur stockage constituent un enjeu essentiel de performance. Le recours aux bases de données relationnelles est aujourd’hui une solution très répandue. Ces bases de données permettent d’organiser, de stocker, de mettre à jour et d’interroger des données structurées volumineuses utilisées simultanément par différents programmes ou différents utilisateurs. Cela est impossible avec les représentations tabulaires étudiées en classe de première.
Des systèmes de gestion de bases de données (SGBD) de très grande taille (de l’ordre du pétaoctet) sont au centre de nombreux dispositifs de collecte, de stockage et de production d’informations. L’accès aux données d’une base de données relationnelle s’effectue grâce à des requêtes d’interrogation et de mise à jour qui peuvent par exemple être rédigées dans le langage SQL (Structured Query Language). Les traitements peuvent conjuguer le recours au langage SQL et à un langage de programmation.
Il convient de sensibiliser les élèves à un usage critique et responsable des données.
- Identifier les concepts définissant le modèle relationnel.
- Ces concepts permettent d’exprimer les contraintes d’intégrité (domaine, relation et référence).
- Base de données relationnelle.
- Savoir distinguer la structure d’une base de données de son contenu. Repérer des anomalies dans le schéma d’une base de données.
- La structure est un ensemble de schémas relationnels qui respecte les contraintes du modèle relationnel. - Les anomalies peuvent être des redondances de données ou des anomalies d’insertion, de suppression, de mise à jour. - On privilégie la manipulation de données nombreuses et réalistes.
- Système de gestion de bases de données relationnelles.
- Identifier les services rendus par un système de gestion de bases de données relationnelles : persistance des données, gestion des accès concurrents, efficacité de traitement des requêtes, sécurisation des accès.
- Il s’agit de comprendre le rôle et les enjeux des différents services sans en détailler le fonctionnement.
- Langage SQL : requêtes d’interrogation et de mise à jour d’une base de données.
- Identifier les composants d’une requête. - Construire des requêtes d’interrogation à l’aide des clauses du langage SQL : SELECT, FROM, WHERE, JOIN. - Construire des requêtes d’insertion et de mise à jour à l’aide de : UPDATE, INSERT, DELETE.
- On peut utiliser DISTINCT, ORDER BY ou les fonctions d’agrégation sans utiliser les clauses GROUP BY et HAVING.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Introduction aux bases de données
Qu’est-ce qu’une base de données ?
Le nombre d’informations disponibles et les moyen de les diffuser sont en constante progression. La croissance du Web a encore accru ce développement en fournissant l’accès à des bases de données gigantesques et très diverses par l’intermédiaire d’une interface commune (Amazon, Google, Facebook, ...).
Notion de base de données
Tout le monde a une idée naturelle de ce que peut être une base de donnée, nous stockons, sur nos disques durs, non seulement des fichiers musicaux, mais aussi des informations relatives à ces derniers : noms des
artistes, des albums, dates d’enregistrements, noms et numéros des morceaux, parfois noms des musiciens, ...
On remarque qu’une caractéristique des données contenues dans une base de données est qu’elles doivent posséder un lien entre elles. En effet, des données choisies au hasard ne peuvent clairement pas constituer une base de données. Une base de données est donc une représentation partielle et (très) simplifiée du monde réel, obtenue par un processus de modélisation.
À retenir
Une base de données est un ensemble d’informations
structurées et organisées, mémorisées sur un support permanent.
Info
La définition d’une base de données n’indique pas comment sont stockées les informations, une organisation consistant en l’utilisation de
fichiers pourrait tout à fait convenir. Cependant, bien que simple à mettre en œuvre, cette solution pose de nombreux problèmes :
Lourdeur d’accès aux données
En pratique, pour chaque accès aux données (lecture ou écriture), il faut écrire un programme.
Manque de sécurité
Si tout programmeur peut accéder aux données, il est impossible d’assurer leur intégrité.
Pas de contrôle de concurrence
Si plusieurs utilisateurs accèdent au mêmes fichiers, en même temps, des problèmes de concurrence d’accès se posent : quelle modification sera retenue ? quelle valeur sera lue ?
Pour manipuler une base de données, on utilise donc généralement un logiciel spécialisé : un SGBD (Système de Gestion de Bases de Données)[^2].
À retenir
On appelle SGBD (Système de Gestion de Bases de
Données) un logiciel complexe, de haut niveau, qui permet de manipuler les informations stockées dans une base de données.
À retenir
On appelle « Système d’information » l’ensemble
composé par les bases de données et le SGBD.
Utilisation d’une base de données
La création d’une base de données s’effectue avec un objectif : elle doit permettre de retrouver de l’information par son contenu en se fondant sur des critères de recherche. Par exemple, en 1959, dans
quels morceaux et quel(s) album(s) de Miles Davis apparaît John Coltrane ?
Info
La grande différence entre une base de données et un programme écrit pour lire des information dans des fichiers, est qu’une base de donnée doit permettre de répondre à des questions auxquelles ses concepteurs
n’avaient pas forcément pensé.
À retenir
Une base de données doit permettre d’assurer
l’indépendance entre les données et leur traitement.
Pour réaliser l’indépendance annoncée dans la définition précédente, on associe à la base de données une description que l’on appelle métadonnée (ou catalogue). Cette description décrit la structure
interne de la base de données[^3]. En plus de la structure et du type des données, on stocke également à cet endroit les informations concernant les règles de cohérence des données (cf. section suivante sur la qualité d’une base de données).
NumCD
Titre
Interprète
Label
Année
1
Bring On the Night
Sting
1986
3
Superstition
Stevie Wonder
Motown
1972
2
Paranoid Android
Radiohead
Parlophone
1997
Extrait d’une base de données pour une collection de CD musicaux.
Dans l’exemple donné dans le Tableau 1., en plus des informations, la base de données contiendrait les métadonnées suivantes :
« NumCD » est un nombre entier supérieur à 1 ;
« Titre » est une chaîne de caractères de taille 50 ;
« Interprète » est une chaîne de caractères de taille 30 ;
« Label » est une chaîne de caractères de taille 20 ;
« Année » est un nombre entier supérieur à 1900 et inférieur à l’année en cours.
Remarque
On note que tous les « champs » ne sont pas forcément renseignés dans l’exemple donné.
À retenir
On doit donc retenir que l’utilisateur ou l’application utilisatrice du système d’information ne doit pas avoir connaissance de la structure interne de ce dernier pour l’interroger, on réalise une abstraction des données. C’est la raison pour laquelle on utilise une description des données sous la forme d’un modèle pour permettre une restitution la plus efficace possible de l’information.
Qualité d’une base de données
Info
L’un des objectifs de création d’une base de données est de pouvoir retrouver les données par leur contenu. Il faut donc s’assurer que ces dernières sont de « bonne qualité ».
Cohérence des données contenues dans la base
Par exemple, si un champ doit contenir la qualité d’une personne sous la forme « Monsieur », « Madame », « Mademoiselle », l’entrée de « M. » doit être impossible de façon à ne pas induire des erreurs de recherche sur ce Champ.
Absence de redondance
Dans un carnet d’adresses le stockage du nom de la ville et du code postal pour chaque personne représente une redondance : la même information est stockée plusieurs fois, ce qui consomme de la place inutilement.
Le modèle relationnel des données s’accompagne d’outils qui permettent de détecter, dans une certaine mesure, les problèmes présentés dans cette section.
Modèles de données
À retenir
Les modèles de données correspondent à la manière
de structurer l’information dans une base de données.
Ces modèles reposent sur des recherches initiées à partir des années 1960. Parmi tous les modèles développés et utilisés, on ne présentera ici (très succinctement) que deux modèles : le modèle hiérarchique et le modèle relationnel.
Modèle hiérarchique
Avertissement
Ce modèle n’est présenté ici qu’à des fins historiques. Il n’est pas au programme.
Ce modèle est l’un des plus anciens modèles. À l’époque de sa définition, le traitement de l’information était encore très lié à l’organisation des fichiers sur une machine. Les modèles conceptuels des données étaient donc des graphes ou des arbres.
Le modèle « hiérarchique » propose donc une classification arborescente des données, à la manière d’une classification scientifique. Dans ce modèle, chaque enregistrement n’a qu’un seul possesseur, ce qui limite les modélisations de la réalité possibles.
Des SGBD de type « hiérarchique » ou « réseau » (extension du modèle précédent permettant des relations transversales) sont toujours utilisés, pour des raisons d’efficacité, lorsque la structure de données s’y prête.
Le système d’exploitation Windows utilise « une base de registre » pour stocker tous les paramètres de configuration (système et logiciels). Le modèle de données choisi est le modèle « hiérarchique ».
La donnée Favoris, par exemple, a pour chemin : HKEY_CURRENT_USER\Software\Microsoft\Windows\CurrentVersion\Applets\Regedit\Favorite (on peut accéder à cette donnée grâce au logiciel Regedit).
Modèle relationnel
Ce modèle a été proposé en 1970 par E. F. Codd dans un article resté célèbre : « A Relational Model of Data for Large Shared Data Banks ». Il cherchait à créer un langage d’interrogation de bases de données plus
proche du langage naturel. Dans cette optique, il a fondé sa recherche sur des concepts mathématiques rigoureux, tels que la théorie des ensembles et la logique du premier ordre.
Info
Le modèle « relationnel » permet de modéliser les informations contenues dans les bases de données en utilisant des relations, c’est à dire un ensemble d’attributs.
Présentation du modèle relationnel
Qu’est-ce qu’une relation ?
À retenir
On appelle relation unobjet de la vie réelleauquel on attache un ensemble d’attributs.
Par exemple, un employé possède un nom, un prénom, un matricule, travaille dans un service et a été embauché à une certaine date.
Chaque instance d’une relation est appelée un tuple ou n-uplet (en français).
Les relations sont d’ordinaire représentées sous la forme de tables à deux dimensions, et on confond les deux concepts. On confond de même ligne dans la table et tuple.
Par définition, chaque tuple d’une relation est unique, et est identifié par un attribut ou une combinaison de plusieurs attributs qui forme la clef primaire.
L’ordre des tuples dans la relation n’est pas significatif.
Le nombre de champs de la relation s’appelle le degré de la relation tandis que le nombre de tuples dans la relation s’appelle la cardinalité de la relation.
Exemple
Base de données formée par deux relations.
Titre
Directeur
Acteur
Casablanca
M. Curtiz
Humphrey Bogart
Casablanca
M. Curtiz
Peter Lore
Les 400 coups
F. Truffaut
J.-P. Leaud
Star Wars
G. Lucas
Harrison Ford
Relation Film
Titre
Salle
Heure
Casablanca
Lucernaire
19:00
Casablanca
Studio
20:00
Les 400 coups
Sel
20:30
Star Wars
Sel
22:15
Relation Séance
Quelle est la cardinalité de la relation Film ?
Réponse
La cardinalité d’une relation est le nombre de tuples (ou de lignes) qu’elle renferme. Ici la cardinalité est égale à 4.
Quel est le degré de la relation Séance ?
Réponse
Le degré d’une relation est le nombre de champs qui la définissent. Ici, c’est 3.
Quels sont les attributs (champs) de la relation Film ?
Réponse
Les attributs de la relation Film sont : Titre, Directeur, Acteur.
Indiquer un tuple de la relation Séance.
Réponse
LA cardinatlité de la relation étant égale à 4, on a le choix entre 4 réponses. (Casablanca, Lucernaire, 19:00) fait partie de ces réponses possibles.
Qu’est-ce que le calcul relationnel ?
Info
On accède aux données en utilisant comme langage le calcul relationnel. Le calcul relationnel (très fortement inspiré de la logique du premier ordre en mathématique) s’appuie sur des variables, des prédicats, des connecteurs logiques (Et, Ou, Implique, ...) et des quantificateurs existentiels (Il existe, Pour tout, ...).
Exemple
Existe-t-il un film ayant pour acteur Humphrey Bogart diffusé au cinéma Studio ?
Existe-t-il au moins un film de M. Curtiz projeté au cinéma Sel ?
F. Truffaut a-t-il fait tourner l’acteur Harrison Ford ?
Qu’est-ce qu’une vue ?
Les relations constituant la base de données sont complétées à l’aide de vues :
À retenir
Une vue est une relation, qui au lieu d’être
stockée dans la base de données, est le résultat d’une requête.
Une vue peut ensuite être réutilisée exactement comme s’il s’agissait d’une relation stockée dans la base de données.
Quelles sont les films, les salles et les horaires des séances dans lesquels on peut trouver l’acteur Humphrey Bogart ?
Réponse
La réponse à cette requête est une vue :
Casablanca
Lucernaire
19:00
Casablanca
Studio
20:00
Qu’est-ce que le langage SQL ?
Toujours dans le cadre de sa recherche, Codd a mis au point, en même temps que le modèle de données relationnel, un langage d’interrogation des données SEQUEL, qui est par la suite devenu SQL (Structured Query Language). La normalisation du langage SQL, dès 1986 par l’ANSI (institut de normalisation américain), puis par l’ISO (organisation internationale de la normalisation) a assuré, pour une grande partie, le
succès du modèle relationnel. Les requêtes écrites pour un SGBD fonctionnent en général sans trop de modifications avec un autre SGBD.
Exemple
Traduction en langage SQL de l’interrogation de la question 5.
Les SGBD sont des systèmes complexes qu’il n’est pas question de décrire en détail.
Rendre efficace la recherche d’une information dans un fichier informatique n’est pas simple
Comme on l’a déjà vu cette année, lorsqu’on utilise un fichier pour stocker de l’information, il est nécessaire de prévoir un découpage de celui-ci par enregistrements, souvent de taille fixe.
Pour passer d’un enregistrement à l’autre, il faut alors avancer la « tête de lecture » de la taille d’un enregistrement.
Info
Dans une base de données, on recherche les données par leur contenu. Pour retrouver l’une d’entre elles, il faut donc parcourir tous les enregistrements un à un (recherche séquentielle) et en examiner le contenu, ce qui est relativement peu efficace.
Une alternative à ce parcours séquentiel est la construction de tables descriptives afin d’accélérer l’accès aux données :
Une première table permet l’accès direct à un enregistrement par une « clé » associée à l’adresse mémoire de l’enregistrement.
Une seconde table contient l’ordre relatif des enregistrements ordonnés suivant les valeurs d’un champ : on appelle cette table un index. Cette seconde table permet d’employer des méthodes de recherche par le contenu du champ indexé beaucoup plus performantes. La recherche dichotomique est l’une d’entre elles.
On voit, à travers ce simple exemple de recherche du contenu d’un enregistrement, qu’un SGBD doit implémenter des algorithmes sophistiqués.
Fonctionnalités d’un SGBD
Pour concevoir et organiser les fonctionnalités d’un SGBD on peut s’appuyer sur un modèle en trois-couches dont l’objectif est d’obtenir, une indépendance entre les données et les traitements :
Info
Niveau interne ou physique
C’est le niveau le plus proche du matériel. À ce niveau, on gère :
le stockage dans les fichiers des données, du schéma, des index, ... ;
le partage des données et la gestion de la concurrence d’accès ;
la reprise sur panne (fiabilité) ;
la distribution des données et l’interopérabilité (accès aux réseaux).
Niveau conceptuel ou logique
À ce niveau, on :
définit la structure des données : Langage de Description des Données (LDD) ;
définit comment les données peuvent être consultées et mises à jour : Langage de Requêtes (LR) et Langage de Manipulation des Données (LMD) ;
gère la confidentialité (sécurité, droits d’accès aux données à travers le réseau, ...) ;
maintient l’intégrité des données.
Niveau externe
Le niveau externe sert à décrire les « vues » des utilisateurs, c’est à dire le schéma de visualisation des données, qui est différent pour chaque catégorie d’utilisateur. C’est à ce niveau qu’on retrouve le langage SQL.
Ce découpage permet de modifier un sous-niveau sans toucher aux deux autres.
Transactions
À retenir
On appelle transaction toute opération de
modification des données dans la base de données.
À retenir
Une transaction relationnelle garantit qu’une
séquence d’opérations se réalise correctement, par exemple en empêchant qu’une somme d’argent ne s’évanouisse dans la nature (avec un compte en
banque débité sans qu’un autre ne soit crédité). Même une panne ne doit pas pouvoir conduire à une exécution incorrecte.
Info
Les transactions doivent posséder les propriétés suivantes :
Atomicité
Une transaction est effectuée en totalité ou abandonnée.
Cohérence
Une transaction doit s’effectuer d’un état cohérent de la base vers un autre état cohérent.
Isolement
Des transactions différentes ne doivent pas interférer.
Durabilité
La transaction a des effets permanents, même en cas de panne.
Architectures
Info
Architecture à deux niveaux Client/Serveur
L’architecture à deux niveaux, appelée architecture 2-tiers
(tier signifie niveau, étage en anglais), caractérise les systèmes Clients/Serveurs dans lesquels le client demande une ressource que le serveur fournit directement.
La relation est donc directe entre le serveur et le client.
Architecture à trois niveaux
Dans l’architecture à 3 niveaux, appelée architecture 3-tiers,
il existe un niveau intermédiaire, c’est-à-dire que l’on a généralement une architecture partagée entre :
Le client, qui demande les ressources ;
Le serveur d’application (Middleware), qui reçoit les demandes, interroge le serveur et retourne les réponses (après avoir éventuellement effectué un traitement) ;
Le serveur secondaire (généralement le SGBD), qui répond aux requêtes du serveur d’application.
Dans l’architecture à 3 niveaux, chaque serveur (niveaux 1 et 2) ffectue une tâche (un service) spécialisée. Ainsi, un serveur peut utiliser les services d’un ou plusieurs autres serveurs afin de fournir son propre service. Par conséquent, l’architecture à trois niveaux est potentiellement une architecture à N niveaux.
Comparaison des deux types d’architectures
L’architecture à deux niveaux est donc une architecture Client/Serveur dans laquelle le serveur est polyvalent, c’est-à-dire qu’il est capable de fournir directement l’ensemble des ressources demandées par le client.
Dans l’architecture à trois niveaux par contre, les applications au niveau serveur sont délocalisées, c’est-à-dire que chaque serveur est spécialisé dans une tâche (serveur web et serveur de base de données par
exemple).
Info
Ainsi, l’architecture à trois niveaux permet :
une plus grande flexibilité/souplesse ;
une plus grande sécurité (la sécurité peut être définie au niveau de chaque service) ;
de meilleures performances (les tâches sont partagées).
Étapes de la conception de bases de données
Info
On peut décomposer le processus de conception d’une base de données en plusieurs étapes :
Analyse du système du monde réel à modéliser ;
Mise en forme du modèle pour l’intégrer dans le SGBD ;
Création effective dans le SGBD des structures et leur remplissage.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Le modèle Entités/Associations
Avertissement
Le modèle Entités/Associations en tant que tel n’est pas au programme. Par contre il me semble utile afin de vous faire comprendre comment on modèle le réel et on parvient au final à un schéma relationnel.
L’objectif de ce chapitre n’est donc pas la conception de schémas E/A mais plutôt leur compréhension et leur interprétation.
Ce chapitre présente la première étape du processus de modélisation du
monde réel. On commence par recueillir les informations à intégrer dans
la base de donnée puis on les transcrit sous une forme qui nous
permettra, dans le prochain chapitre, à passer au modèle relationnel
(choix de la structure de la base, clés, ...).
Principes généraux
Dans un schéma E/A, on distingue les entités qui constituent la base
de données, et les associations entre ces entités. Pour illustrer le
besoin de cette distinction, on commence traditionnellement par
illustrer les problèmes qui ne manquent pas de survenir lorsqu’on traite
une base relationnelle comme un simple fichier texte, sans se soucier de
lui donner une structure correcte.
Problèmes lorsque la structure de la base n’a pas été pensée
On commence généralement par créer et étudier une base se
limitant à la table suivante :
titre
annee
nom_realisateur
prenom_realisateur
annee_naissance
Alien
1979
Scott
Ridley
1943
Vertigo
1958
Hitchcock
Alfred
1899
Psychose
1960
Hitchcock
Alfred
1899
Kagemusha
1980
Kurosawa
Akira
1910
Volte-face
1997
Woo
John
1946
Pulp Fiction
1995
Tarantino
Quentin
Titanic
1997
Cameron
James
1954
Sacrifice
1986
Tarkovski
Andrei
1932
Inglourious Basterds
2009
Tarantino
Quentin
1963
Reservoir Dogs
1992
Tarantino
1963
Avatar
2009 Cameron
James
1954
Arizona Dream
1993
Kusturica
Emir
Le Ruban blanc
2009
Haneke
Michael
1942
Table FilmSimple.
Info
La conception de cette base soufre de graves défauts :
Anomalies lors d’une insertion
Qu’est-ce qui distingue deux films différents ?
La conception de cette base ne permet pas de répondre à cette
question puisqu’on peut insérer deux films de même nom mais de
réalisateurs différents, par exemple.
Une bonne conception
nécessiterait un choix : Deux films peuvent-ils avoir le même
titre ? Si non, un film peut-être repéré par son titre, si oui, il
reste à définir ce qui identifiera un film.
Anomalies lors d’une modification
Les données sont incohérentes car il manque une date de naissance et
un prénom. Toute modification de la table peut conduire à une telle
incohérence. De plus, ces modifications doivent être effectuées
plusieurs fois, sans contrôle de cohérence.
Pour finir, le Tarantino de « Reservoir Dogs » est-il le même que
celui de « Pulp Fiction » ?
Anomalies lors d’une destruction
Toute destruction d’un enregistrement retire les renseignements sur
le film et sur le réalisateur : supprimer l’entrée de
« Volte-face » efface tout renseignement sur John Woo.
On remarque que c’est la présence de la même information à plusieurs
endroits qui est à l’origine de pratiquement tous les problèmes.
Un exemple de structure de base pensée
Info
Pour éviter les anomalies énumérées ci-dessus, il faut :
Être capable de représenter individuellement les films et les
réalisateurs, de manière à ce qu’une action sur l’un n’entraîne pas
systématiquement une action sur l’autre ;
Définir une méthode d’identification d’un film ou d’un
réalisateur, qui permette d’assurer que la même information est
représentée une seule fois ;
Préserver le lien entre les films et les réalisateurs, mais sans
introduire de redondance.
Les deux premièrs problèmes nécessitent, pour être résolus, d’effectuer
des choix. Par exemple : deux films ne peuvent pas avoir le même titre mais deux
réalisateurs peuvent avoir le même nom. Afin de pouvoir identifier les
réalisateurs, on doit alors leur attribuer un identifiant unique.
titre
annee
Alien
1979
Vertigo
1958
Psychose
1960
Kagemusha
1980
Volte-face
1997
Pulp Fiction
1995
Titanic
1997
Sacrifice
1986
Inglourious Basterds
2009
Reservoir Dogs
1992
Avatar
2009
Arizona Dream
1993
Le Ruban blanc
2009
Table des films
id
nom_realisateur
prenom_realisateur
annee_naissance
1
Scott
Ridley
1943
2
Hitchcock
Alfred
1899
3
Kurosawa
Akira
1910
4
Woo
John
1946
5
Tarantino
Quentin
1963
6
Cameron
James
1954
7
Tarkovski
Andrei
1932
8
Kusturica
Emir
1954
9
Haneke
Michael
1942
Table des réalisateurs
Dans les tables ci-dessus, les identifiants (ou clés) sont
représentés en gras.
Premier progrès
Il n’y a maintenant plus de redondance dans la base de données.
Problème
Il n’existe aucun lien entre les deux tables. Comment savoir qui a réalisé « Le Ruban blanc » ?
On ajoute alors un attribut dans la table Films :
titre
annee
id_rea
Alien
1979
1
Vertigo
1958
2
Psychose
1960
2
Kagemusha
1980
3
Volte-face
1997
4
Pulp Fiction
1995
5
Titanic
1997
6
Sacrifice
1986
7
Inglourious Basterds
2009
5
Reservoir Dogs
1992
5
Avatar
2009
6
Arizona Dream
1993
8
Le Ruban blanc
2009
9
Table des films
id
nom_realisateur
prenom_realisateur
annee_naissance
1
Scott
Ridley
1943
2
Hitchcock
Alfred
1899
3
Kurosawa
Akira
1910
4
Woo
John
1946
5
Tarantino
Quentin
1963
6
Cameron
James
1954
7
Tarkovski
Andrei
1932
8
Kusturica
Emir
1954
9
Haneke
Michael
1942
Table des réalisateurs
Cette représentation est correcte : la redondance est réduite au minimum
puisque seule la clé identifiant un réalisateur apparaît dans deux
tables (on parle de clé primaire dans la cas de la table des
réalisateurs et de clé étrangère dans le cas de la table des films). On
peut vérifier que les anomalies relevées dans la section précédente ont
disparu : on sait ce qui identifie un film, on sait ce qui identifie un réalisateur ; toute modification n’affecte que l’instance visée ; on peut détruire l’entrée
d’un film sans affecter celle de son réalisateur.
Info
La modélisation E/A offre une méthode simple pour parvenir au résultat
ci-dessus sans avoir à écrire les tables, même dans des cas bien plus
complexes que celui présenté ici.
Le modèle E/A : présentation informelle
Info
Un schéma E/A réalise une abstraction de l’application étudiée, pertinente relativement aux objectifs visés et choix effectués. On distingue :
des entités, représentées par des rectangles, ici Film, Artiste, Internaute et Pays ;
des associations entre entités représentées par des liens entre ces rectangles
Chaque entité est caractérisée par un ensemble d’attributs, parmi lesquels un ou plusieurs forment l’identifiant unique (souligné sur la figure ci-dessus).
Info
Les associations sont caractérisées par des cardinalités. La notation « 0,* » sur le lien Réalise du côté de l’entité Film signifie qu’un artiste peut réaliser 0 ou plusieurs films. La
cardinalité est essentielle même si elle est forcément discutable puisque résultat d’un choix de conception.
Les cardinalités sont notées à l’aide de deux chiffres : celui de droite indique la cardinalité maximale (elle vaut généralement 1 ou *), celui de gauche indique la cardinalité minimale.
La notation « 0,1 » pour l’association Réalise indique que l’on s’autorise à ne pas connaître le réalisateur du film, « 1,1 » entre Film et Pays indique, au contraire, que l’on doit toujours connaître le pays
producteur du film.
Il existe quelques raccourcis :
La notation « * » est équivalente à « 0,* » ;
La notation « 1 » est équivalente à « 1,1 ».
Info
Un schéma E/A est totalement indépendant de tout choix
d’implémentation. Il n’est pas question de type, de structure de données, d’algorithme, de langage, ... C’est, en théorie, la partie la plus stable d’une application utilisant des bases de données.
Le modèle
Le modèle E/A, conçu en 1976, est à la base de la plupart des méthodes de conception. La syntaxe utilisée ici est celle de la méthode UML.
Entités, attributs et identifiants
La première étape d’une conception consiste à identifier les entités tiles.
À retenir
On désigne par entité tout objet identifiable et pertinent pour l’application.
La notion d’identité est primordiale, c’est elle qui permet de distinguer les entités les unes des autres, et donc de dire qu’une information est redondante ou qu’elle ne l’est pas. Il est indispensable de prévoir un moyen technique pour pouvoir effectuer cette distinction entre entités au niveau de la base de données : on parle
d’identifiant ou de clé.
Attributs
Les entités sont caractérisées par des propriétés ou attributs : le titre (du film), le nom (de l’acteur), sa date de naissance, ... Un attribut est désigné par un nom et prend ses valeurs dans un domaine énumérable, comme les entiers, les chaînes de caractères, les dates,
etc.
Il est important de noter que, selon cette définition, un attribut prend une valeur et une seule. On dit que les attributs sont atomiques.
Types d’entités
Il est maintenant possible de décrire plus précisément les entités par leur type :
À retenir
Le type d’une entité est composé des éléments
suivants :
son nom ;
la liste de ses attributs avec (optionnellement) le domaine où l’attribut prend ses valeurs : les entiers, les chaînes de caractères, ... ;
l’indication de (ou des) attribut(s) permettant d’identifier l’entité : ils constituent la clé.
À retenir
Une clé est un sous-ensemble d’attributs minimal d’une entité permettant d’identifier de manière unique cette entité.
Un internaute est caractérisé par plusieurs attributs : son email, son nom, son prénom, ... L’émail constitue une clé naturelle puisqu’on ne trouve pas, en principe, deux internautes ayant la même adresse
électronique. L’identification par nom est impossible, mais on pourrait cependant utiliser la paire (nom,preˊnom). Il est cependant conseillé d’éviter d’utiliser une telle structure de clé car elle pose
des problèmes de performances et complique les manipulations SQL par la suite.
Il est possible d’avoir plusieurs clés pour un même ensemble d’entités.
Dans ce cas, on en choisit une comme clé primaire, et les autres, comme clés secondaires.
À retenir
Les caractéristiques d’une clé primaire devraient être :
Sa valeur doit apparaître de façon évidente dans le schéma E/A ;
On ne doit jamais avoir à ressentir le besoin de modifier cet attribut ;
Pour des raisons de performance, sa taille de stockage doit être la plus petite possible.
Remarque
Dans la conception choisie, dans l’exemple de la base Film, il a été décidé que deux films ne pouvaient pas avoir le même titre : ce dernier est donc un bon candidat pour être la clé de la table. Quelle clé aurait-il
fallu choisir si l’on avait accepté que deux films aient le même titre ? Il aurait été nécessaire d’introduire un champ abstrait, nommé par exemple, destiné à tenir le rôle de clé.
Associations binaires
À retenir
Une association binaire lie deux entités.
On remarque, sur la schéma ci-dessus, que :
certains réalisateurs mettent en scène plusieurs films ;
inversement, un film est mis en scène par un réalisateur, au maximum.
L’association, pour être la plus explicite possible, doit donc faire apparaître ces différences.
À retenir
La cardinalité d’une association est une paire [min,max] telle que :
Le symbole max(cardinalité maximale) désigne le nombre maximal de fois où une entité peut intervenir dans l’association.
En général, ce nombre est 1 (au plus une fois) ou n (plusieurs fois, nombre indéterminé), noté par le symbole « * ».
Le symbole min(cardinalité minimale) désigne le nombre minimal de fois où une entité peut intervenir dans la relation. En général, ce nombre est 1 (au moins une fois) ou 0.
Les cardinalités maximales sont plus importantes que les cardinalités minimales ou, plus précisément, elles s’avèrent plus difficiles à remettre en cause, une fois que le schéma de base est constitué. Les cardinalités n’expriment pas une vérité absolue, mais des choix de
conception.
Info
Dans la notation UML, on indique les cardinalités aux deux extrémités d’un lien d’association entre deux types d’entités TA et TB. Les cardinalités de TA sont placées à l’extrémité du liant allant de TA vers TB alors que les cardinalités pour TB sont placées à
l’extrémité du lien allant de TB vers TA.
L’association Réalise se lit : un réalisateur réalise zéro, un ou plusieurs films ; un film est réalisé par zéro ou au maximum un réalisateur.
Remarque
Le schéma ci-dessus ne fait pas apparaître l’entité Réalisateur mais l’entité Artiste. De plus deux associations relient ces entités.
Quelle conception a pu entraîner un tel schéma ? En réalité, un réalisateur peut être acteur dans un film ; il est donc préférable de regrouper les acteurs et les réalisateurs dans type d’entité plus
général : Artiste. L’association Réalise ne peut donc plus modéliser le lien entre les entités Film et Artiste ; il est alors nécessaire de créer l’association Joue. On obtient le schéma ci-dessous :
Remarque
Dans le cas d’associations avec des cardinalités multiples de chaque côté, on peut être obligé de lier des attributs à une association (par exemple l’association Joue a pour attribut le rôle). En effet, un attribut ne pouvant prendre qu’une et une seule valeur, on ne peut pas associer l’attribut rôle à l’entité Artiste puisqu’un acteur
peut jouer dans plusieurs films (il existe fort peu de chances qu’il tienne toujours le même rôle !). Seules les associations ayant des cardinalités multiples de chaque côté peuvent porter des attributs.
Une association étant définie par un ensemble de couples d’entités, on peut donc se demander comment la caractériser.
À retenir
La clé d’une association (binaire) entre un type
d’entité E1 et un type d’entité E2 est le couple constitué de la clé c1 de E1 et de la clé c2 de E2.
En pratique, cette définition est trop contraignante car on peut vouloir
autoriser deux entités à être liées plus d’une fois dans une
association. Par exemple, un internaute peut être amené à noter
plusieurs fois un film, en conservant l’historique de ces notations. Une
association binaire entre Internaute et Film est impossible : on ne
peut définir qu’un seul lien entre un film donné et un internaute donné !
Pour résoudre ce problème, il est nécessaire d’introduire des types fictifs et des associations multiples, ... ce que nous ne ferons pas dans ce cours.
Exercice
Exercice 1 : choix d’un identifiant
On considère l’entité ci-après, qui décrit des salles de cinémas. Les attributs de cette entité sont les suivants :
nom de la salle ;
nom du cinéma ;
ville du cinéma ;
nombre de places ;
taille de l’écran.
Que peut-on proposer comme identifiant (clé) pour cette entité ?
Exercice 2 : identification des entités et des associations
On veut modéliser l’activité de vente de billets pour un théâtre. Quelles entités et quelles associations pourrait-on créer ?
Proposer des attributs et les identifiants (clés) pertinents pour décrire ces entités et ces associations.
Exercice 3 : description du monde réel à partir des cardinalités
On donne le schéma E/A d’un séminaire.
Quelle description peut-on faire du lien entre les différentes entités à partir des cardinalités ?
Exercice 4 : cardinalités
On donne le schéma E/A d’une bibliothèque.
Quelles questions faut-il poser aux utilisateurs de la base de données pour déterminer les cardinalités des associations ? Proposer une réponse à ces questions et en déduire les cardinalités pour chaque entité.
Exercice 5 : tournoi de tennis
Le schéma suivant représente des rencontres dans un tournoi de tennis :
Peut-on jouer des matchs de double ?
Un joueur peut-il gagner un match sans y avoir participé ?
Peut-il y avoir deux matchs sur le même terrain à la même heure ?
Connaissant un joueur, peut-on découvrir sur quels terrains il a joué ?
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Du schéma entités/associations au schéma relationnel
Concepts relationnels
Modèle relationnel
Le modèle relationnel tire son nom de la notion de relation
mathématique entre les éléments. Chacun de ces éléments peut prendre des
valeurs dans un ensemble défini.
Par exemple, les appareils électroménagers d’une cuisine peuvent être
contenus dans l’ensemble des valeurs suivantes : {Réfrigérateur,
Cuisinière, Hotte, Robot, Lave-vaisselle}. On peut, par ailleurs,
aussi considérer l’ensemble des couleurs que peuvent prendre ces
appareils : {Rouge, Vert, Bleu, Jaune, Blanc, Noir, Rose}.
Les combinaisons possibles entre les appareils et les couleurs sont au
nombre de 35. Parmi toutes ces combinaisons possibles, on effectue une
sélection qui représente la description d’une cuisine :
Cet ensemble de couples de valeurs liées entre elles, que l’on nomme
tuples dans le modèle relationnel, représente la
relation entre les éléments « Appareil » et « Couleur ». On
désigne les éléments constitutifs de ces tuples par les termes
attributs (ou champs).
On peut écrire formellement la relation à partir de son schéma
relationnel : ma_cuisine(Appareil, Couleur). Cette écriture représente le schéma relationnel de
la relation ma_cuisine. Les valeurs énoncées précédemment pour les champs
représentent leurs domaines, c’est à dire les ensembles de toutes
les valeurs possibles pour un champ.
On voit, à partir de cet exemple, qu’il est nécessaire de préciser les
concepts qui seront utilisés dans la suite de ce chapitre.
À retenir
Un schéma relationnelR est formé par un
ensemble fini de n attributs U={u1,…,un}. On le note
R[u1,…,un] ou R[U].
Quel est le schéma relationnel de la relation ma_cuisine ?
Réponse
Le schéma relationnel de la relation ma_cuisine est ma_cuisine(Appareil, Couleur).
À retenir
L’arité (ou degré) d’un schéma relationnel R est égale à sonnombre d’attributs*.*
Quelle est l’arité du schéma ma_cuisine(Appareil, Couleur) ?
Réponse
L’arité du schéma ma_cuisine(Appareil, Couleur) est 2.
À retenir
Un schéma de base de donnéeRB est un ensemble
fini de p schémas relationnels. On le note
RB{R1[U1],…,Rp[Up]}.
::: {.definition}
Definition 5. Un n-uplet (ou tuple) u sur U est une
fonction de U dans \ensuremathdom. Si u est un
n-uplet sur U et AϵU, u(A) est la valeur de u pour
l’attribut A.
L’écriture d’un n-uplet peut préciser les attributs : (Appareil :
Robot, Couleur : Mauve).
:::
::: {.definition}
Definition 6. Une relation, ou instance d’un schéma
relationnelR[U], est un ensemble fini I de n-uplets sur U. La
cardinalité de la relation est égale à celle de l’ensemble I.
Une relation est donc totalement décrite par :
le schéma relationnel ;
les domaines des différents champs ;
les tuples ou n-uplets qui la constituent.
On représente une relation par une table, correspondant à la notion de
tableau. Les tuples correspondent aux lignes et les attributs de la
relation aux colonnes.
Une relation étant constituée d’un ensemble de n-uplets, ceux-ci
doivent y être tous différents.
:::
La relation (cf. tableau 1) est d’arité 2 et de cardinalité 4.
::: {.definition}
Definition 7. Une base de donnéesB, ou instance d’un
schéma de base de donnéesRB, est une fonction, dont l’ensemble de
définition est un schéma de base de données RB, telle que pour tout
rϵRB, B(r) est une relation.
Une base de données est donc un ensemble de relations reliées entre
elles par des liens sémantiques.
:::
Notion de clé d’une relation et dépendance fonctionnelle
Lorsqu’on utilise une base de données, il est nécessaire d’accéder à un
enregistrement par le contenu d’un ou de plusieurs champs. On nomme
clé d’une relation un champ, ou un ensemble de champs, qui permet
d’identifier précisément un enregistrement. Une relation peut
comprendre plusieurs clés possibles ; ce sont les clés candidates.
::: {.definition}
Definition 8. On appelle clé primaire d’une relation la clé
minimale parmi toutes les clés candidates de la relation. Une clés
primaire doit toujours contenir une valeur et celle-ci doit être unique
pour chacun des enregistrements de la relation
:::
Dans l’exemple de la relation , le choix de la clé n’est pas simple
car :
Plusieurs appareils différents peuvent être de même couleur ;
Une cuisine peut comporter plusieurs réfrigérateurs, robots, ...
Pourrait-on envisager d’utiliser le couple (appareil, couleur) comme clé
? La réponse est toujours négative, les réfrigérateurs présents dans la
pièce peuvent être de même couleur.
Pour désigner une clé (primaire), il faut donc prendre en compte le «
sens » des données contenues dans la relation. Si aucun champ ne peut
constituer une clé, il est nécessaire d’introduire un champ formel, tel
qu’un identifiant numérique.
::: {.definition}
Definition 9. Une dépendance fonctionnelle existe entre deux
ensembles de champs si les valeurs contenues dans l’un des ensembles de
champs permettent de déterminer les valeurs contenues dans l’autre
ensemble.
:::
Les dépendances fonctionnelles expriment la relation de hiérarchie qui
existe entre les champs.
1 Henri 10 Paris Université Sorbonne
2 Stanislas 34 Paris Université Jussieu
3 Henriette 44 Lyon CHU Bron
4 Dominique 19 Nancy Université Poincaré
5 Isabelle 56 Nancy INPL
6 Olivier 51 Marseille Université Saint Charles
7 Henri 98 Paris Université Sorbonne
8 Jérôme 23 Nancy INPL
9 Laurence 34 Bordeaux Université Victor Segalen
10 Christian 41 Paris ENS
11 Antoine 16 Marseille Université Saint Charles
12 Laurence 34 Paris Université Jussieu
Si l’on examine les données de la relation , Tableau
1{reference-type=“ref”
reference=“relation-lecteur”}., on remarque :
qu’il ne peut y avoir de dépendance fonctionnelle entre les
ensembles (Ville, Etablissement) et (Nom, Age). En effet, le couple
(Laurence, 34) correspond aux deux couples (Paris, Université de
Jussieu) et (Bordeaux, Université Victor Segalen).
À un couple (Ville, Etablissement) ne correspond donc pas un unique
couple (Nom, Age).
que si l’on suppose qu’un établissement n’est situé que dans une
seule ville, il existe une dépendance fonctionnelle entre le champ «
Etablissement » et le champ « Ville ».
À une valeur du champ « Etablissement » correspond une et une seule
valeur du champ « Ville ». Cette valeur n’est cependant pas unique.
La valeur du champ « Numero_carte » est unique pour chacun des
enregistrements. Ses valeurs sont identifiantes pour tous les champs
de la relation. Chaque champ dépend fonctionnellement de ce champ.
Ses valeurs ne sont jamais vides, c’est une clé candidate !
Comme c’est aussi la seule clé de la relation, ce champ constitue la
clé primaire.
Tous les champs qui ne font pas partie d’une clé candidate d’une
relation possèdent des dépendances fonctionnelles avec cette clé.
On indique la clé primaire d’un schéma relationnel en soulignant le
champ, dans le schéma relationnel : lecteur([Numero_carte]{.ul}, Nom,
Age, Ville, Etablissement).
Langage SQL
SQL est un langage déclaratif qui permet d’interroger une base de
données par l’intermédiaire d’un SGBD sans se soucier de la
représentation interne (physique) des données, de leur localisation, des
chemins d’accès ou des algorithmes nécessaires. À ce titre, il s’adresse
à une large communauté d’utilisateurs potentiels, pas seulement aux
informaticiens. On peut l’utiliser de manière interactive, mais
également en association avec des interfaces graphiques, ou des langages
de programmation (comme Python).
Le langage SQL est composé de différents sous-ensembles :
LMD
Langage de Manipulation des données (DML, Data Manipulation
Language).
Il permet la manipulation et la mise à jour des tables, et est
composé de quatre ordres fondamentaux : , , , .
LDD
Langage de Définition des Données (DDL, Data Definition Language).
Il permet la définition et la mise à jour du schéma relationnel
de la base de données (mode administration). Il est composé des
ordres suivants : , , , , , , .
LCD
Langage de Contrôle des Données (DCL, Data Control Language).
Il permet de définir les contraintes d’intégrité, de gérer les accès
et les autorisations (administration). Il est composé des ordres : ,
, .
Le programme cette année se limite au langage de manipulation des
données et plus particulièrement à l’ordre .
Opérations de l’algèbre relationnelle et traductions en langage SQL
La manipulation de données dans le modèle relationnel se fait à l’aide
d’opérations formelles reposant sur des concepts mathématiques issus de
la théorie des ensembles : c’est l’algèbre relationnelle.
::: {.definition}
Definition 10. L’algèbre relationnelle consiste en un petit
nombre d’opérations de base qui, appliquées à des relations,
produisent de nouvelles relations. Ces opérations peuvent être
composées pour construire des expressions algébriques de plus en plus
complexes.
:::
Opérations relationnelles de base
Projection
::: {.definition}
Definition 11. La projection consiste à filtrer certains
attributs de la relation, ce qui donne au résultat une relation de
degré inférieur à celui de la relation de départ.
Pour I une relation de schéma relationnel I[A1,…,An], si 1⩽i<j⩽n,
πAi,…,Aj(I)={(Ai:t(Ai),…,Aj:t(Aj))∣tϵI}
:::
**Nom** **Ville**
Henri Paris
Stanislas Paris
Henriette Lyon
Dominique Nancy
Isabelle Nancy
Olivier Marseille
Henri Paris
Jérôme Nancy
Laurence Bordeaux
Christian Paris
Antoine Marseille
Laurence Paris
::: {.definition}
Definition 12. La sélection consiste à filtrer des
enregistrements de la relation en fonction d’une condition. Le
résultat d’une sélection est une relation de même degré mais de
cardinalité différente.
Pour I une relation de schéma relationnel I[A1,…,An] et aϵ\ensuremathdom(Ai),
σAi=a(I)={tϵI∣t(Ai)=a}
:::
Numero_carteNomAgeVilleEtablissement
5 Isabelle 56 Nancy INPL
6 Olivier 51 Marseille Université Saint Charles
7 Henri 98 Paris Université Sorbonne
: Selection σAge>50(lecteur)
Numero_carteNomAgeVilleEtablissement
1 Henri 10 Paris Université Sorbonne
7 Henri 98 Paris Université Sorbonne
: Selection σNom=”Henri”(lecteur)
Intuitivement, dans une représentation de type table, une sélection
conserve uniquement les enregistrements vérifiant la condition.
Affichage de tous les enregistrements d’une relation
Composition d’une sélection et d’une projection
Une sélection sur une relation formant une nouvelle relation, il est
possible de « passer » cette dernière en argument d’une opération de
projection. La composition se note :
πchamps(σcontrainte(relation))
NomVille
Isabelle Nancy
Olivier Marseille
Henri Paris
: Combinaison d’une sélection et d’une projection
πNom,Ville(σAge>50(lecteur))
Opérateurs de comparaison et connecteurs logiques de SQL
Ci-dessous sont présentés quelques opérateurs et connecteurs qui
apparaissent très fréquemment dans les requêtes SQL. Pour une liste plus
exhaustive et davantage d’exemples, consulter http://sql.sh.
OpérateurSignification
$=$ Égal
$< >$ Différent
\< Inférieur
$>$ Supérieur
$< =$ Inférieur ou égal
$> =$ Supérieur ou égal
**Signification**
Appartient à un intervalle
Appartient à un ensemble
Teste si le champ contient une donnée
Compare des chaînes de caractères
**Nom** **Instrument**
Jaco Pastorius Basse électrique
Bill Evans Piano
Appareil Couleur Nom Instrument
Réfrigérateur rouge Jaco Pastorius Basse électrique
Réfrigérateur rouge Bill Evans Piano
Robot mauve Jaco Pastorius Basse électrique
Robot mauve Bill Evans Piano
Cuisinière jaune Jaco Pastorius Basse électrique
Cuisinière jaune Bill Evans Piano
: ma_cuisine×musicien
L’exemple précédent a été choisi de façon à illustrer que le résultat
d’un produit cartésien peut n’avoir aucun sens dans la réalité.
En langage SQL
il n’est pas nécessaire d’utiliser un quelconque mot clé ; il faut
requérir toutes les colonnes depuis les deux tables.
Division Cartésienne
La division cartésienne est le pendant du produit cartésien, tout comme
la division euclidienne est le pendant du produit sur des entiers : si
on note A et B deux relations (ou tables), alors A÷B est la
« plus grande » relation (au sens de l’inclusion) telle que le produit
cartésien avec B redonne (presque) A. Formellement, c’est la plus
grande relation telle qu’il existe une relation C vérifiant :
[(A÷B)×B]∪C=A et [(A÷B)×B]∩C=∅
Il n’existe pas en langage SQL
d’opérateur permettant d’implémenter directement la division
cartésienne.
Création d’un alias, renommage
Il peut être pénible d’utiliser, dans les requêtes, des noms de champs
définis de manière complexe, ou, tout simplement, nommés de façon pas
très parlante. On peut alors définir un alias pour renommer
temporairement un champ (et même une table).
::: {.definition}
Definition 13. Un renommage pour un ensemble fini d’attributs U est
une fonction injective de U dans l’ensemble att que l’on notera
A1→B1,...,An→Bn.
L’opération de renommage
ρA1→B1,...,An→Bn transforme une relation I sur A1,...,An en une relation
sur B1,...,Bn de de telle sorte que :
ρA1→B1,...,An→Bn(I)={vsurB1,…,Bn∣∃uϵI,v(Bi)=u(Ai)pour tout iϵ[1,n]}
:::
La création d’un alias permet de faciliter grandement la lecture d’une
requête. Cette opération se note :
BadgeNomVille
7 Henri Paris
6 Olivier Marseille
5 Isabelle Nancy
on utilise le mot clé , immédiatement après le nom du champ, pour
introduire l’alias.
Dans l’exemple précédent, on a illustré l’utilisation de la clause « »
qui permet de trier les résultats suivant l’ordre (par défaut
ascendant) défini par certains champs (ici le mot clé indique que c’est
l’ordre descendant qui a été choisi).
Jointure
La jointure est l’opération fondamentale de l’algèbre relationnelle
qui permet d’exprimer le sens du lien entre les relations, dans le monde
réel. Conformément au programme, on ne présente ici que l’opération de
jointure symétrique.
::: {.definition}
Definition 14. Une jointure permet d’associer plusieurs
relations dans une même requête. Le résultat de cette requête est une
relation de degré supérieur aux degrés de chacune des relations de
départ. L’opération de jointure est symétrique et associative.
La liaison entre les relations s’effectue par le contenu commun d’un
champ (champs de jointure).
La jointure des relations et selon une certaine contrainte se note :
table1⊳⊲contraintetable2 ou table1[\ensuremathcontrainte]table2
:::
Il est bien évidemment possible d’associer une jointure à une
projection et une sélection. Ces associations doivent être prises en
compte lors de la détermination du degré et de la cardinalité de
la relation finale.
Même si l’on ne dispose pas du modèle conceptuel associé, on constate
que l’on peut relier les deux relations par le champ « ». Les
informations concernant l’établissement de la relation « » sont
stockées dans la relation « » dont la clé est le champ « ». Pour
obtenir la liste des lecteurs ainsi que les informations concernant leur
établissement, on effectue une jointure entre ces relations sur le champ
« ».
Schéma de la base de données prenant en compte la jointure : Dans la
relation l’attribut est une clé étrangère.
Le champ « » figure deux fois dans la relation résultat de la jointure
car la première occurrence provient de la relation « » alors que la
seconde provient de la relation « ».
Afin de ne conserver qu’une occurrence des champs de jointure, on
peut réaliser une projection :
Cette opération, jointure+projection, est parfois
appelée jointure naturelle.
Les champs de jointure ne doivent pas nécessairement être nommés à
l’identique. Nous verrons comment les différentier dans la partie « En
langage SQL », page .
On peut considérer l’opération de jointure comme une sélection sur le
produit cartésien des deux relations. On ne conserve que les lignes
dont le contenu du champ sur lequel s’effectue la jointure est égal.
1 Henri 1 1 Paris Université Jussieu
1 Henri 1 2 Lyon CHU Bron
1 Henri 1 3 Nancy Université Poincaré
1 Henri 1 4 Paris Université Sorbonne
2 Stanislas 2 1 Paris Université Jussieu
2 Stanislas 2 2 Lyon CHU Bron
2 Stanislas 2 3 Nancy Université Poincaré
2 Stanislas 2 4 Paris Université Sorbonne
3 Henriette 1 1 Paris Université Jussieu
3 Henriette 1 2 Lyon CHU Bron
3 Henriette 1 3 Nancy Université Poincaré
3 Henriette 1 4 Paris Université Sorbonne
: Lecteur_bis⊳⊲Num_Etablissement=Num_EtablissementEtablissementLes lignes grisées sont celles qui sont
sélectionnées lors d’une jointure.
En langage SQL
il existe deux façons de réaliser une opération de jointure en SQL :
la première est basée sur l’idée qu’une opération de jointure
peut être considérée comme une sélection sur le produit
cartésien des deux relations :
Avec une projection :
Le traitement de la requête n’est cependant pas, dans ce cas,
optimal au niveau du SGBD.
la seconde méthode utilise l’opérateur de jointure :
Avec une projection :
On remarque qu’un champ est défini de façon unique grâce à la
concaténation du nom de la relation et de celui du champ :
.[
champ−nom−unique
]{#champ-nom-unique label=“champ-nom-unique”}
Si les champs portent des noms différents, il n’est pas nécessaire
de préciser de quelle relation ils sont issus.
Fonctions de calculs et d’agrégation
Une règle, dans le domaine des bases de données, est que tout ce qui
peut se calculer ne doit pas être stocké dans la base. On évite ainsi
la perte de place et l’incohérence qui peut découler du stockage
d’informations redondantes.
Fonctions de calculs
Le langage SQL ne possède pas d’instruction d’itération ; il possède
cependant des fonctions simples de traitement des données d’une
colonne (les calculs plus complexes doivent être effectués à l’aide
d’un langage de programmation comme Python).
FonctionOpération
Comptage du nombre d'enregistrements de la table
Maximum des éléments d'une colonne
Minimum des éléments d'une colonne
Moyenne des éléments d'une colonne
Somme des éléments d'une colonne
: Fonctions statistiques de SQL
Détermination de l’age moyen des lecteurs
:
Comptage du nombre de lecteurs
Dans le cas de la fonction , il n’est pas nécessaire de préciser le
champ puisque cette fonction s’applique à la relation toute entière.
Agrégats ou groupage
::: {.definition}
Definition 15. Les opérations d’« agrégation » (ou de groupage)
regroupent les enregistrements d’une relation par valeurs contenues dans
une colonne.
On applique généralement des opérations de calcul sur les
« sous-tables » ainsi créées.
:::
NumVoitMarqueTypeCouleur
1 Peugeot 404 Rouge
2 Citroen SM Noire
3 Opel GT Blanche
4 Peugeot 403 Blanche
5 Renault Alpine Rose
6 Renault Floride Bleue
7 Peugeot 806 Blanche
: Relation Voiture(NumVoit,Marque,Type,Couleur)
Affichage des différentes marques
Pour réaliser cette opération avec SQL, on utilise le mot clé suivi
du nom de la colonne sur laquelle s’effectue l’agrégat.
: Comptage du nombre de voitures, pour chaque marque
Affichage de l’age moyen des lecteurs, par université de la relation
:
Restriction sur le résultat d’une requête agrégative
Le résultat de l’opération de groupage peut lui-même être filtré : on
effectue une sélection des lignes par rapport au contenu des colonnes
obtenues dans la table résultat de la recherche groupée.
Calcul du nombre de voitures par marque dont le nombre est supérieur à 1
: Comptage du nombre de voitures, pour chaque marque, si le nombre
est supérieur à 1
Le mot clé permet d’effectuer une sélection sur le résultat de
l’opération de groupage. Le mot clé opère une sélection sur les
enregistrements de la table avant l’opération de groupage.
Calcul du nombre de voitures, par marque, dont la couleur n’est pas « Rouge »
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Le langage SQL : Le langage de manipulation de données (LMD)
Introduction
Info
Le langage SQL est composé de différents sous-ensembles :
LMD : Langage de Manipulation des données (DML, Data Manipulation Language)
Permet la manipulation et la mise à jour des tables, composé de quatre ordres fondamentaux : SELECT, UPDATE, INSERT, DELETE.
LDD : Langage de Définition des Données (DDL, Data Definition Language)
Permet la définition et la mise à jour du schéma relationnel de la base de données (mode administration). Composé des ordres suivants : CREATE TABLE, CREATE INDEX, CREATE VIEW, DROP TABLE, DROP INDEX, DROP VIEW, ALTER TABLE.
LCD : Langage de Contrôle des Données (DCL, Data Control Language)
Permet de définir les contraintes d’intégrité, de gérer les accès et les autorisations (administration). Composé des ordres : GRANT, REVOKE, LOCK. Recouvre les déclencheurs (triggers), procédures cataloguées.
Le programme se limite au sous-ensemble LMD. Nous serons tout de même obligés d’utiliser l’ordre de création de table CREATE TABLE.
SQLite
Dans ce cours nous utiliserons SQLite depuis l’interface de
Repl.it
.
SQLite est un moteur de base de données relationnelle (sous-ensemble d’un SGBD) accessible par le langage SQL. Contrairement aux serveurs de bases de données traditionnels, comme MySQL ou PostgreSQL, sa particularité est de ne pas reproduire le schéma habituel client-serveur mais de fonctionner sans serveur (on parle de base de données « standalone » ou « embarquée »). L’intégralité de la base de données (déclarations, tables, index et données) est stockée dans un fichier indépendant de la plateforme.
Remarque
On peut accéder à SQLite depuis de nombreux langages de programmation. Nous utiliserons dans un premier temps une interface en ligne de commande (CLI) et par la suite Python.
SQLite est le moteur de base de données le plus utilisé au monde.
Indiquer la signification de chaque ligne de la commande.
Incorporer la commande au fichier celebrites.sql et l’exécuter.
Afin de vérifier que la commande a bien créé une table dans la base de données qui réside pour l’instant dans la RAM, ajouter la commande suivante au fichier main.sql
-- Énumérations des tables
.tables
Relancer l’exécution des commandes et observer le résultat dans la console.
Afin d’examiner la structure de la table Celebrites, ajouter l’une des commandes suivantes au fichier main.sql.
-- Structure de la table Celebrites
.schema'Celebrites'
ou
-- Structure de la table Celebrites
pragmatable_info('Celebrites');
La commande permettant d’intégrer le tuple ("Hanks", "Tom", "Homme", "USA", 64) à la relation Celebrites est :
La commande, telle qu’elle est donnée ici, impose le respect de l’ordre des informations dans le tuple.
Intégrer la commande précédente au fichier celebrites.sql. Exécuter cette commande. La sortie fait-elle apparaître le résultat de cette commande ?
Afin de vérifier que les informations ont bien été ajoutées à la base de données, ajouter la commande suivante dans le fichier main.sql
SELECT*FROMCelebrites;
Exécuter cette commande.
Ajouter maintenant au fichier celebrites.sql toutes les commandes permettant de peupler la base de données.
Exécuter ces commandes.
La base de données réside toujours en mémoire et n’a, pour l’instant, pas été sauvegardée dans un fichier. Ajouter la commande suivante à la fin du fichier celebrites.sql
.save"cinema.sqlite"
Vérifier que le fichier cinema.sqlite a bien été créé.
Info
Désormais, à la prochaine utilisation de la base de données il ne sera plus nécessaire de relancer toute la création de la base de données (ce qui pourrait être très très long dans le cas d’une base conséquente) mais seulement la commande
.open"cinema.sqlite"
au début du fichier main.sql (qui ne devra alors plus lire le fichier celebrites.sql).
Premières requêtes : Projection
Avertissement
Toutes les commandes à venir devront être entrées dans le fichier main.sql après la commande de lecture du fichier celebrites.sql (ou après la commande de lecture du fichier cinema.sqlite).
La commande SELECT * FROM Celebrites; est une requête. Que signifie le caractère * dans cette commande ?
Réponse
Le caractère * indique que l’on souhaite que la relation retournée par la commande SELECT contienne tous les attributs (champs).
À retenir
Une projection consiste à filtrer certains
attributs d’une relation. Le résultat d’une projection est une relation de
degré inférieur à celui de la relation de départ.
Adapter la commande précédente de façon à obtenir tous les noms des acteurs présents dans la base de données.
Réponse
SELECTNomFROMCelebrites;
Adapter la commande précédente de façon à obtenir tous les noms et sexes des acteurs présents dans la base de données.
Réponse
SELECTNom,SexeFROMCelebrites;
Premières requêtes : Sélection
Sélections simples
À retenir
La sélection consiste à filtrer des
enregistrements d’une relation en fonction d’une condition. Le
résultat d’une sélection est une relation de même degré mais de
cardinalité différente.
Une sélection s’effectue en langage SQL à l’aide de la clause WHERE.
Écrire la commande qui retourne toutes les informations relatives aux femmes présentes dans la base de données.
Réponse
SELECT*FROMCelebritesWHERESexe="Femme";
Adapter la commande précédente de façon à obtenir tous les noms et prénoms des femmes présentes dans la base de données.
Réponse
SELECTNom,prenomFROMCelebritesWHERESexe="Femme";
Opérateurs de comparaison
Quels sont les noms de tous les acteurs (sans distinction de sexe) qui n’ont pas pour pays d’origine les USA.
Réponse
SELECTNomFROMCelebritesWHEREPays!="USA";
Quels sont les noms des acteurs (sans distinction de sexe) qui ont plus de 40 ans ?
Réponse
SELECTNomFROMCelebritesWHEREAge>40;
Quels sont les noms et prénoms des acteurs (sans distinction de sexe) qui ont plus de 40 ans ?
Réponse
SELECTNom,PrenomFROMCelebritesWHEREAge>40;
Quels sont les noms des acteurs (sans distinction de sexe) qui ont au plus 36 ans ?
Réponse
SELECTNomFROMCelebritesWHEREAge<=36;
Quels sont les noms des actrices françaises ?
Réponse
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Donner le schéma relationnel de la base de données.
Afficher les noms de tous les sportifs.
Afficher les noms et prénoms de tous les sportifs.
Afficher les noms, prénoms et sports de tous les sportifs.
Afficher le nom des sportifs nés au mois de décembre.
Afficher les noms et prénoms des sportifs nés en juin.
Afficher les noms et prénoms des sportifs nés en 1981.
Afficher les noms et prénoms des sportifs pratiquant le football.
Instagram
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Donner le schéma relationnel de la base de données.
Afficher toutes les informations relatives aux utilisateurs qui ne sont pas des footballeurs.
Afficher toutes les informations relatives aux utilisateurs qui ont plus de 200 million followers.
Afficher toutes les informations relatives des utilisateurs qui ont au plus 200 million followers.
Afficher toutes les informations relatives des utilisateurs qui ont au moins 200 million followers.
Afficher les prénoms, noms et « Instagram handle » des comptes qui ont au maximum 155 millions de followers.
Afficher toutes les informations pour les comptes qui correspondent à des chanteurs et qui ont plus de 200 millions de followers.
Afficher toutes les informations pour les comptes qui correspondent à des footballeurs ou qui ont moins de 150 millions de followers.
Première requêtes : Ordres SQL
Info
On reprend, dans cette partie, l’étude de la relation Celebrites.
À retenir
L’opérateur ORDER BY est utilisé pour trier le résultat d’une projection. Par défaut ce tri s’effectue par ordre croissant (lexicographique ou numérique). Pour trier par ordre décroissant, il faut ajouter le mot clé DESC, pour trier par ordre croissant on utilise ASC.
Rechercher toutes les informations sur les acteurs, triées par age croissant.
Réponse
SELECT*FROMCelebritesORDERBYAge;
Rechercher toutes les informations sur les acteurs, triées par pays d’origine (par ordre décroissant).
Réponse
SELECT*FROMCelebritesORDERBYPaysDESC;
Rechercher les noms et prénoms des acteurs triés par age et nom croissants.
Réponse
SELECTNom,PrénomFROMCelebritesORDERBYAge,Nom;
Rechercher les noms et prénoms des acteurs triés par age décroissant et nom croissant.
Réponse
Rechercher les noms et prénoms des acteurs dont le pays d’origine commence par un a.
Réponse
SELECTNom,PrenomFROMCelebritesWHEREPaysLIKE'a%';
Rechercher les noms et prénoms des acteurs dont le pays d’origine se termine par un l.
Réponse
SELECTNom,PrenomFROMCelebritesWHEREPaysLIKE'%l';
Rechercher les noms et prénoms des acteurs dont le pays d’origine comporte un a.
Réponse
SELECTNom,PrenomFROMCelebritesWHEREPaysLIKE'%a%';
Exercice d’application : base Animaux
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Rechercher toutes les informations sur les animaux dont le nom commence par la lettre p.
Rechercher toutes les informations sur les animaux dont le nom se termine par la lettre e et qui sont En danger.
Rechercher toutes les informations sur les animaux dont le nom comporte la lettre a et qui sont Vulnérable. Le résultat doit être trié par nom (ascendant).
Afficher le nom de tous les animaux et leur état de préservation.
Afficher le nom de tous les animaux vulnérables par ordre décroissant de la vitesse de déplacement.
Afficher le nom et la durée de vie moyenne des animaux dont le nom comporte un e. L’affichage doit être effectué par durée de vie moyenne croissante.
Afficher les nom, durée de vie moyenne et vitesse de déplacement des animaux dont le nom comporte un o, par vitesse de déplacement décroissante.
Modification des entrées d’une base de données
Info
On reprend, dans cette partie, l’étude de la relation Celebrites.
À retenir
L’ordre UPDATE permet de modifier un enregistrement dans une table. La clause WHERE est utilisée pour sélectionner l’enregistrement.
Faire en sorte que l’age de l’actrice Margot Robbie soit égal à 29 ans.
Réponse
UPDATECelebritesSETAge=29WHERENom="Robbie";
Vérifier que la modification a bien été effectuée.
Modifier le fichier contenant la base de données de façon à ce que la modification, uniquement effectuée en mémoire vive pour l’instant, soit enregistrée de façon permanente.
Le vrai nom de Tom Cruise est Thomas Cruise Mapother IV. Modifier l’entrée dans la base de données.
Réponse
L’ordre DELETE permet de supprimer un enregistrement d’une table. Si aucune clause WHERE n’est utilisée, tous les enregistrements de la table sont supprimés.
Supprimer l’acteur Tom Holland de la table Celebrites.
Réponse
DELETEFROMCelebritesWHERENom="Holland";
Exercice d’application : base Superhereos and Villains
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Écrire une requête qui affiche tous les enregistrements de la table « Superheroes and Villains ».
Écrire une requête qui affiche la structure de la table « Superheroes and Villains ».
Écrire une requête qui affiche les noms des superheroes femmes.
Écrire une requête qui affiche les noms et types (gentil ou méchant) des films X-Men ou Guardians of the Galaxy.
Écrire une requête qui affiche tous les noms des personnages par ordre alphabétique.
Écrire une requête qui affiche les types des personnages et leurs noms par ordre alphabétique croissant pour les types mais ordre alphabétique décroissant pour les noms.
Écrire une requête qui affiche les noms des personnages commençant par la lettre M.
Écrire une requête qui affiche les noms des personnages se terminant par la lettre N.
Écrire une requête qui affiche les noms des personnages contenant la lettre I.
Écrire une requête qui modifie le nom du personnage Groot. Le nouveau nom est Baby Groot. Afficher le résultat de cette requête.
Écrire une requête qui supprime l’enregistrement dont le nom est Queen of Hearts. Afficher la table pour vérifier le résultat de la requête.
Exercice d’application à partir de données réelles et conséquentes
La base de donnée contient tous les indicateurs des lycées français présentés sur le site de l’éducation nationale et dont les données sont en accès “libre” sur
data.gouv.fr
. La notice descriptive est fournie.
Écrire 10 requêtes qui vous semblerons utiliser au mieux cette base de données.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Le langage SQL : Le langage de manipulation de données (LMD), Compléments
Notion de clé d’une relation et dépendance fonctionnelle
Lorsqu’on utilise une base de données, il est nécessaire d’accéder à un
enregistrement par le contenu d’un ou de plusieurs champs. On nomme
clé d’une relation un champ, ou un ensemble de champs, qui permet
d’identifier de façon unique un enregistrement. Une relation peut
comprendre plusieurs clés possibles ; ce sont les clés candidates.
À retenir
On appelle clé primaire d’une relation la clé
minimale parmi toutes les clés candidates de la relation. Une clé
primaire doit toujours contenir une valeur et celle-ci doit être unique
pour chacun des enregistrements de la relation
Pour désigner une clé (primaire), il faut donc prendre en compte le «
sens » des données contenues dans la relation. Si aucun champ ne peut
constituer une clé, il est nécessaire d’introduire un champ formel, tel
qu’un identifiant numérique.
À retenir
Une dépendance fonctionnelle existe entre deux
ensembles de champs si les valeurs contenues dans l’un des ensembles de
champs permettent de déterminer les valeurs contenues dans l’autre
ensemble.
Les dépendances fonctionnelles expriment la relation de hiérarchie qui
existe entre les champs.
Si l’on examine les données de la relation, on remarque :
qu’il ne peut y avoir de dépendance fonctionnelle entre les
ensembles (Ville, Etablissement) et (Nom, Age). En effet, le couple
(Laurence, 34) correspond aux deux couples (Paris, Université de
Jussieu) et (Bordeaux, Université Victor Segalen).
À un couple (Ville, Etablissement) ne correspond donc pas un unique
couple (Nom, Age).
que si l’on suppose qu’un établissement n’est situé que dans une
seule ville, il existe une dépendance fonctionnelle entre le champ «
Etablissement » et le champ « Ville ».
À une valeur du champ « Etablissement » correspond une et une seule
valeur du champ « Ville ». Cette valeur n’est cependant pas unique.
La valeur du champ « Numero_carte » est unique pour chacun des
enregistrements. Ses valeurs sont identifiantes pour tous les champs
de la relation. Chaque champ dépend fonctionnellement de ce champ.
Ses valeurs ne sont jamais vides, c’est une clé candidate !
Comme c’est aussi la seule clé de la relation, ce champ constitue la
clé primaire.
Tous les champs qui ne font pas partie d’une clé candidate d’une
relation possèdent des dépendances fonctionnelles avec cette clé.
À retenir
On indique la clé primaire d’un schéma relationnel en soulignant le
champ, dans le schéma relationnel : Relation lecteur(Numero_carte, Nom, Age, Ville,
Etablissement)
Jointure de deux relations
Qu’est-ce qu’une jointure ?
À retenir
La jointure est l’opération fondamentale de l’algèbre relationnelle
qui permet d’exprimer le sens du lien entre les relations, dans le monde
réel. Conformément au programme, on ne présente ici que l’opération de
jointure symétrique.
À retenir
Une jointure permet d’associer plusieurs
relations dans une même requête. Le résultat de cette requête est une
relation de degré supérieur aux degrés de chacune des relations de
départ. L’opération de jointure est symétrique et associative.
La liaison entre les relations s’effectue par le contenu commun d’un
champ (champs de jointure).
Info
Il est bien évidemment possible d’associer une jointure à une
projection et une sélection. Ces associations doivent être prises en
compte lors de la détermination du degré et de la cardinalité de
la relation finale.
Même si l’on ne dispose pas du modèle conceptuel associé, on constate
que l’on peut relier les deux relations par le champ Numero_Etablissement. Les
informations concernant l’établissement de la relation Lecteur_bis sont
stockées dans la relation Etablissement dont la clé est le champ Num_Etablissement. Pour
obtenir la liste des lecteurs ainsi que les informations concernant leur
établissement, on effectue une jointure entre ces relations sur le champ
Numero_Etablissement.
Schéma de la base de données prenant en compte la jointure : Dans la
relation l’attribut est une clé étrangère.
Numero_carte
Nom
Num_Etablissement
Num_Etablissement
Ville
Nom_Etablissement
1
Henri
1
1
Paris
Université Jussieu
2
Stanislas
2
2
Lyon
CHU Bron
3
Henriette
1
1
Paris
Université Jussieu
Résultat de la jointure des relations Lecteur_bis et Etablissement.
Le champ Num_Etablissement figure deux fois dans la relation résultat de la jointure
car la première occurrence provient de la relation Lecteur_bis alors que la
seconde provient de la relation Etablissement.
Afin de ne conserver qu’une occurrence des champs de jointure, on
peut réaliser une projection :
Numero_carte
Nom
Num_Etablissement
Ville
Nom_Etablissement
1
Henri
1
Paris
Université Jussieu
2
Stanislas
2
Lyon
CHU Bron
3
Henriette
1
Paris
Université Jussieu
Résultat de la jointure des relations Lecteur_bis et Etablissement après projection.
Cette opération, jointure+projection, est parfois
appelée jointure naturelle.
Les champs de jointure ne doivent pas nécessairement être nommés à
l’identique.
Comment effectuer une jointure en langage SQL ?
Il existe deux façons de réaliser une opération de jointure en SQL :
la première est basée sur l’idée qu’une opération de jointure
peut être considérée comme une sélection sur le produit
cartésien des deux relations :
On remarque qu’un champ est défini de façon unique grâce à la concaténation du nom de la relation et de celui du champ. Si les champs portent des noms différents, il n’est pas nécessaire de préciser de quelle relation ils sont issus.
Fonctions de calculs
Une règle, dans le domaine des bases de données, est que tout ce qui
peut se calculer ne doit pas être stocké dans la base. On évite ainsi
la perte de place et l’incohérence qui peut découler du stockage
d’informations redondantes.
Le langage SQL ne possède pas d’instruction d’itération ; il possède
cependant des fonctions simples de traitement des données d’une
colonne (les calculs plus complexes doivent être effectués à l’aide
d’un langage de programmation comme Python).
Fonction
Opération
COUNT
Comptage du nombre d’enregistrements de la table
MAX
Maximum des éléments d’une colonne
MIN
Minimum des éléments d’une colonne
AVG
Moyenne des éléments d’une colonne
SUM
Somme des éléments d’une colonne
Exemples
Détermination de l’age moyen des lecteurs
SELECTAVG(Age)ASAge_MoyenFROMlecteur;
Comptage du nombre de lecteurs
SELECTCOUNT(*)ASNombre_LecteursFROMlecteur;
Dans le cas de la fonction , il n’est pas nécessaire de préciser le champ puisque cette fonction s’applique à la relation toute entière.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Gestion d'une salle de cinéma
L’objectif de cette séance est de mettre en œuvre tous les concepts du chapitre.
La base de donnée accessible à
cette adresse
simule de façon simplifiée la gestion d’un cinéma.
Étudier la structure de chacune des relations de la base et établir son schéma relationnel.
En particulier, faire apparaître les clés primaires et les clés étrangères.
Réponse
Quelles sont les tables de la base ?
.tables
Quelle est la structure de chacune de ces relations ?
On souhaite maintenant ajouter l’attribut tarif à la relation projection. Exécuter la commande suivante :
ALTERTABLEprojectionADDtariffloat;
Vérifier que la structure de la relation projection a bien été modifiée.
On fait la supposition que le tarif des films dépend du film, de la salle, de la séance et de la date de projection. Le tarif exprime le tarif de base.
Mettre à jour la table projection en fixant un tarif de base à 5 € pour la salle nord, 8 € pour la salle centrale, 6.5 € pour la salle sud.
Réponse
Mettre à jour la table projection en ajoutant 1 € au prix des films dont les séances sont à 14h50 et 2 € au prix des films dont les séances sont à 19h30.
Réponse
A crime has taken place and the detective needs your help. The detective gave you the crime scene report, but you somehow lost it. You vaguely remember that the crime was a murder that occurred sometime on Jan.15, 2018 and that it took place in SQL City. All the clues to this mystery are buried in a huge database, and you need to use SQL to navigate through this vast network of information. Your first step to solving the mystery is to retrieve the corresponding crime scene report from the police department’s database. Take a look at the SQL reference to learn how to do this! From there, you can use your SQL skills to find the murderer.
If you’re new to SQL, you may want to start at our
walkthrough
. It won’t teach you everything about SQL, but it should teach you all that you need to solve the mystery.
Entity Relationship Diagram of the database
Checking the Solution
Write the following queries in your SQL environment to check whether you’ve found the right murderer:
INSERTINTOsolutionVALUES(1,"Insert the name of the person you found here");SELECTvalueFROMsolution;
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
La base de données correspond à la modélisation d’emprunt de livres dans un CDI :
Chaque élève d’un lycée peut emprunter des livres au CDI, les données concernants ces livres et les emprunts en cours sont stockés dans une base de données.
Les auteurs ainsi que les éditeurs figurent également dans cette base.
Travail préalable
Déterminer la structure de la base de données et indiquer son schéma relationnel.
Requêtes simples
Donner le code SQL de chacune des requêtes suivantes.
Afficher tous les noms des auteurs.
Afficher le titre de tous les livres.
Afficher les noms des classes du lycée sans doublon.
Afficher les titres des livres et les annees d’édition classés selon les années.
Quels sont les livres dont le titre contient le mot Astérix ?
Expressions et fonctions
Donner le code SQL de chacune des requêtes suivantes.
Afficher les noms et prénoms des élèves de la classe 1-G1.
Afficher les titres des livres publiés après 2000.
Afficher les isbn des livres dont la date retour est déjà passée (au 25 octobre 2020).
Combien d’auteurs sont présents dans la base de données ?
Quelle est l’annee d’édition du ou des livre(s) le(s) plus ancien(s) ?
Requêtes imbriquées
Donner le code SQL de chacune des requêtes suivantes.
Afficher les titres des livres empruntés.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre avec une date retour dépassée (au 25 octobre 2020).
Quels sont les editeurs à avoir édité un livre contenant Astérix dans le titre ?
Quel est le titre du ou des livre(s) le(s) plus ancien(s) ?
Jointures
Donner le code SQL de chacune des requêtes suivantes en utilisant la clause JOIN.
Afficher les titres des livres empruntés.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre avec une date retour dépassée (au 25 octobre 2020).
Qui est l’auteur du livre 1984 ?
Afficher les titres des livres écrit par Pierre Boulle.
Combien de livres ont été écrit par Isaac Asimov ?
Afficher les noms des editeurs ayant édité un écrit par Barjavel.
Physique, Chimie et Informatique > Terminales Spé. NSI
Physique, Chimie et Informatique > Terminales Spé. NSI > Quelques projets à coder
Etiquetage en composante connexe
Introduction
L’étiquetage en composante connexe est une technique utilisée en traitement d’image pour regrouper ensemble des pixels ou des régions qui sont connectés et partagent des propriétés similaires. En d’autres termes, il s’agit de trouver et d’étiqueter des zones d’une image qui sont liées de manière directe ou indirecte.
Pour simplifier :
Pixels Connexes : On regarde les pixels qui se touchent ou sont directement voisins (horizontalement, verticalement, ou en diagonale).
Propriétés Similaires : On examine les valeurs des pixels ou d’autres caractéristiques, comme la couleur ou la luminosité, et on groupe les pixels ayant des valeurs similaires.
Étiquetage : On attribue une étiquette (un numéro ou une autre identification) à chaque groupe de pixels connexes partageant des propriétés similaires.
Cette technique est utilisée dans divers domaines, tels que la vision par ordinateur, la détection d’objets, la segmentation d’image, etc. Elle permet de distinguer et d’identifier des régions distinctes dans une image en se basant sur la connectivité et la similarité des pixels.
Physique, Chimie et Informatique > Terminales Spé. NSI > Quelques projets à coder
Lé Démineur
Info
Le Démineur est un jeu vidéo de réflexion dont le but est de localiser des mines cachées dans une grille représentant un champ de mines virtuel, avec pour seule indication le nombre de mines dans les zones adjacentes.
L’objectif de cette séance est la construction de la grille représentant le champ de mines.
Les fonctions développées ci-dessous devront appartenir à un module demineur.
Créer ce module.
Le plateau à deux dimensions (m lignes et n colonnes) du jeu sera défini à la question 3. par une liste de listes contenant des valeurs booléennes. La présence d’une bombe correspondra à la valeur True tandis que l’absence d’une bombe à la valeur False. Les bombes seront placées aléatoirement avec une probabilité de 1/p.
Dans le module demineur, définir la fonction contient_bombe dont la spécification est :
defcontient_bombe(p:int)->bool:"""
Fonction qui détermine si une case contient une bombe ou pas.
Cette détermination est aléatoire, de probabilité 1/p.
"""
Remarque. Utiliser la fonction randint du module random pour effectuer le tirage aléatoire et décider que la présence d’une bombe correspond à la valeur 1 (c’est arbitraire).
Dans le module demineur, définir la fonction initialisation_jeu dont la spécification est :
definitialisation_jeu(m:int,n:int,p:int)->List[List[bool]]:"""
Initialise le Jeu en construisant un plateau de dimensions m x n cases,
contenant des bombes dont la probabilité d'apparition est de 1/p.
La présence d'une bombe correspond à la valeur True, l'absence d'une
bombe correspond à la valeur False.
"""
Remarque. En fait, il est plus pratique (la raison sera développée plus tard) de créer un plateau de m + 2 lignes et de n + 2 colonnes. Les première et dernière lignes, ainsi que les première et dernière colonnes ne devront contenir aucune bombe.
Dans le module demineur, définir la fonction affichage dont la spécification est :
defaffichage(p:List[List[bool]])->None:"""
Affiche le plateau du jeu dans la console.
Une astérisque représente une bombe, un point représente une cellule
« sure ».
"""
Dans le fichier principal, importer le module demineur,
définir les variables M, N et p en demandant à l’utilisateur leurs valeurs,
initialiser le jeu,
afficher le plateau.
Dans le module demineur, définir la fonction nombre_bombes dont la spécification est :
defnombre_bombes(p:List[List[bool]],i:int,j:int)->int:"""
Retourne le nombre de bombes au voisinage de la
cellule (i, j) du plateau p.
"""
Remarque. Le fait d’avoir choisi une liste de listes de dimensions (m + 2) x (n + 2) facilite l’écriture de cette fonction.
Dans le module demineur, définir la fonction dont la spécification est :
defaffichage_nbre_bombes(p:List[List[bool]])->None:"""
Affiche le plateau du jeu dans la console.
Une astérisque représente une bombe, les cellules « sures » contiennent
le nombre de bombes adjacentes.
"""
Appeler la fonction affichage_nbre_bombes depuis le fichier principal.
Physique, Chimie et Informatique > Terminales Spé. NSI > Quelques projets à coder
Analyse des résultats du Loto
Le LOTO de la Française des Jeux est un jeu de hasard et d’argent apparu en 1976 en France. Dans sa première version (jusqu’en 2008), les joueurs devaient choisir 6 numéros dans une grille contenant tous les nombres entiers de 1 à 49 (inclus).
Sur le site de la Française des Jeux
https://www.fdj.fr/jeux/jeux-de-tirage/loto/statistiques
il est possible de télécharger un fichier contenant les résultats de tous les tirages1, noyés parmi un grand nombre d’informations, depuis le tout début de ce jeu. La quantité d’informations contenues dans le fichier est tellement importante que l’utilisation d’un programme pour les analyser prend tout son sens.
L’objectif du programme est, au minimum, de compter le nombre d’apparitions de chacun des numéros entre 1976 et 2008.
Le résultat, dans la console, doit au minimum fournir les informations suivantes2 :
Lors des 4858 tirages :
le 1 est apparu 710 fois
le 2 est apparu 681 fois
le 3 est apparu 674 fois
le 4 est apparu 720 fois
le 5 est apparu 702 fois
...
Le programme devra être découpé en fonctions. Chaque fonction devra être accompagnée de sa spécification.
En réalité il existe deux fichiers car la formule du jeu a été modifiée en 2008. Nous ne traiterons que les résultats des tirages entre 1976 et 2008 ! ↩︎
Vous pourrez en fournir d’autres qui vous paraitraient pertinentes. ↩︎
Physique, Chimie et Informatique > Terminales Spé. NSI
Écrire une fonction recherche qui prend en paramètres un tableau tab de nombres entiers triés par ordre croissant et un nombre entier n, et qui effectue une recherche dichotomique du nombre entier n dans le tableau non vide tab.
Cette fonction doit renvoyer un indice correspondant au nombre cherché s’il est dans le tableau, -1 sinon.
Exercice 2 (1/3 des points)
On considère la fonction separe ci-dessous qui prend en argument un tableau tab dont les éléments sont des 0 et des 1 et qui sépare les 0 des 1 en plaçant les 0 en début de tableau et les 1 à la suite.
On considère la fonction insere ci-dessous qui prend en argument un entier a et un tableau tab d’entiers triés par ordre croissant. Cette fonction insère la valeur a dans le tableau et renvoie le nouveau tableau. Les tableaux seront représentés sous la forme de listes python.
definsere(a,tab):l=list(tab)# l contient les mêmes éléments que tabl.append(a)i=...whilea<...and...>=...:l[i+1]=...l[i]=ai=...returnl
Un professeur de NSI décide de gérer les résultats de sa classe sous la forme d’un dictionnaire :
les clefs sont les noms des élèves ;
les valeurs sont des dictionnaires dont les clefs sont les types d’épreuves et les valeurs sont les notes obtenues associées à leurs coefficients. Avec :
L’élève dont le nom est Durand a ainsi obtenu au DS2 la note de 8 avec un coefficient 4. Le professeur crée une fonction moyenne qui prend en paramètre le nom d’un de ces élèves et lui renvoie sa moyenne arrondie au dixième.
J’ai (DL) rendu cet exercice un peu plus difficile à résoudre que la version initiale proposée.
Exercice 2 (50% des points)
Soit une image binaire représentée dans un tableau à 2 dimensions. Les éléments M[i][j], appelés pixels, sont égaux soit à 0 soit à 1.
Une composante d’une image est un sous-ensemble de l’image constitué uniquement de 1 et de 0 qui sont côte à côte, soit horizontalement soit verticalement. Par exemple, les composantes de :
M=0010011110110100
sont
M=0010011110110100
On souhaite, à partir d’un pixel égal à 1 dans une image M, donner la valeur val à tous les pixels de la composante à laquelle appartient ce pixel.
La fonction propager prend pour paramètre une image M, deux entiers i et j et une valeur entière val. Elle met à la valeur val tous les pixels de la composante du pixel M[i][j] s’il vaut 1 et ne fait rien s’il vaut 0.
Par exemple, propager(M,2,1,3) donne :
M=0030033310330100
Compléter le code récursif de la fonction propager donné ci-dessous et écrire un programme qui teste cette fonction.
defpropager(M,i,j,val):ifM[i][j]==...:returnNoneM[i][j]=val# l'élément en haut fait partie de la composanteif(i-1)>=0andM[i-1][j]==...:propager(M,i-1,j,val)# l'élément en bas fait partie de la composanteif(...)<len(M)andM[i+1][j]==1:...(M,...,j,val)# l'élément à gauche fait partie de la composanteif(...)>=0andM[i][j-1]==1:propager(M,i,...,val)# l'élément à droite fait partie de la composanteif(...)<len(M)andM[i][j+1]==1:...(M,i,...,val)
L’occurrence d’un caractère dans un phrase est le nombre de fois où ce caractère est présent.
Exemples
l’occurrence du caractère ‘o’ dans ‘bonjour’ est 2 ;
l’occurrence du caractère ‘b’ dans ‘Bébé’ est 1 ;
l’occurrence du caractère ‘B’ dans ‘Bébé’ est 1 ;
l’occurrence du caractère ‘ ‘ dans ‘Hello world !’ est 2.
On cherche les occurrences des caractères dans une phrase. On souhaite stocker ces occurrences dans un dictionnaire dont les clefs seraient les caractères de la phrase et les valeurs l’occurrence de ces caractères.
Par exemple : avec la phrase 'Hello world !' le dictionnaire est le suivant : {'H': 1,'e': 1,'l': 3,'o': 2,' ': 2,'w': 1,'r': 1,'d': 1,'!': 1} (l’ordre des clefs n’ayant pas d’importance).
Écrire une fonction occurence_lettres prenant comme paramètre une variable phrase de type str. Cette fonction doit renvoyer un dictionnaire constitué des occurrences des caractères présents dans la phrase.
Exercice 2 (50% des points)
La fonction fusion prend deux listes L1, L2 d’entiers triées par ordre croissant et les fusionne en une liste triée L12 qu’elle renvoie.
Dans cet exercice, un arbre binaire de caractères est stocké sous la forme d’un dictionnaire où les clefs sont les caractères des nœuds de l’arbre et les valeurs, pour chaque clef, la liste des caractères des fils gauche et droit du nœud.
Écrire une fonction récursive taille prenant en paramètres un arbre binaire arbre sous la forme d’un dictionnaire et un caractère lettre qui est la valeur du sommet de l’arbre, et qui renvoie la taille de l’arbre à savoir le nombre total de nœud.
On pourra distinguer les 4 cas où les deux « fils » du nœud sont '', le fils gauche seulement est '', le fils droit seulement est '', aucun des deux fils n’est ''.
Test possible
asserttaille(a,"F")==9
Exercice 2 (50% des points)
On considère l’algorithme de tri de tableau suivant : « à chaque étape, on parcourt depuis le début du tableau tous les éléments non rangés et on place en dernière position le plus grand élément ».
Exemple avec le tableau :
t=[41,55,21,18,12,6,25]
Étape 1
on parcourt tous les éléments du tableau, on permute le plus grand élément avec le dernier. Le tableau devient :
t=[41,25,21,18,12,6,55]
Étape 2
on parcourt tous les éléments sauf le dernier, on permute le plus grand élément
trouvé avec l’avant dernier. Le tableau devient :
t=[6,25,21,18,12,41,55]
Et ainsi de suite.
Le code de la fonction tri_iteratif qui implémente cet algorithme est donné ci-dessous.
Écrire une fonction recherche qui prend en paramètres elt un nombre et tab un tableau de nombres, et qui renvoie l’indice de la dernière occurrence de elt dans tab si elt est dans tab et le -1 sinon.
On définit une classe gérant une adresse IPv4.
On rappelle qu’une adresse IPv4 est une adresse de longueur 4 octets, notée en décimale à point, en séparant chacun des octets par un point.
On considère un réseau privé avec une plage d’adresses IP de 192.168.0.0 à 192.168.0.255.
On considère que les adresses IP saisies sont valides.
Les adresses IP 192.168.0.0 et 192.168.0.255 sont des adresses réservées.
Le code ci-dessous implémente la classe AdresseIP :
from__future__importannotationsfromtypingimportListclassAdresseIP:def__init__(self:AdresseIP,adresse:str)->None:self.adresse=....defliste_octet(self:AdresseIP)->List[int]:"""
Retourne une liste de nombres entiers : la liste des octets de l'adresse IP
"""return[int(i)foriinself.adresse.split(".")]defest_reservee(self:AdresseIP)->bool:"""
Retourne True si l'adresse IP est une adresse réservée, False sinon
"""return....or....defadresse_suivante(self:AdresseIP)->AdresseIP:"""
Retourne un objet de AdresseIP avec l'adresse IP qui suit l’adresse self si elle existe et False sinon
"""octet=....if....<254:octet_nouveau=....+....returnAdresseIP('192.168.0.'+....)else:returnFalse
Compléter le code ci-dessus et instancier trois objets : adresse1, adresse2, adresse3 avec respectivement les arguments suivants : '192.168.0.1', '192.168.0.2', '192.168.0.0'.
Écrire une fonction python appelée nb_repetitions qui prend en paramètres un élément elt et une liste tab et renvoie le nombre de fois où l’élément apparaît dans la liste.
note est un nombre de type flottant (float) compris entre 0 et 20 ;
coefficient est un nombre entier positif.
Les résultats aux évaluations d’un élève sont regroupés dans une liste composée de
couples (note, coefficient).
Écrire une fonction moyenne (accompagnée de sa spécification) qui renvoie la moyenne pondérée de cette liste donnée en paramètre.
Par exemple, l’expression moyenne([(15, 2), (9, 1), (12, 3)]) devra renvoyer le résultat du calcul suivant :
On cherche à déterminer les valeurs du triangle de Pascal. Dans ce tableau de forme triangulaire, chaque ligne commence et se termine par le nombre 1. Par ailleurs, la valeur qui occupe une case située à l’intérieur du tableau s’obtient en ajoutant les valeurs des deux cases situées juste au-dessus, comme l’indique la figure suivante :
Compléter la fonction pascal ci-après. Elle doit renvoyer une liste correspondant au triangle de Pascal de la ligne 1 à la ligne n où n est un nombre entier supérieur ou égal à 2 (le tableau sera contenu dans la variable C). La variable Ck doit, quant à elle, contenir, à l’étape numéro k, la k-ième ligne du tableau.
fromtypingimportList,Tupledefpascal(n:int)->List[List[int]]:"""
Détermine les valeurs du triangle de Pascal.
"""C=[[1]]forkinrange(1,.....):Ck=[.....]foriinrange(1,k):Ck.append(C[.....][i-1]+C[.....][.....])Ck.append(.....)C.append(Ck)returnC
Écrire une fonction maxi qui prend en paramètre une liste tab de nombres entiers et renvoie un couple donnant le plus grand élément de cette liste, ainsi que l’indice de la première apparition de ce maximum dans la liste.
Remarque
L’utilisation de la fonction max fournie avec le langage Python n’est pas autorisée.
Cet exercice utilise des piles qui seront représentées en Python par des listes (type list). On rappelle que l’expression T1 = list(T) fait une copie de T indépendante de T, que l’expression x = T.pop() enlève le sommet de la pile T et le place dans la variable x et, enfin, que l’expression T.append(v) place la valeur v au sommet de la pile T.
Compléter le code Python de la fonction positif ci-dessous qui prend une pile T de nombres entiers en paramètre et qui renvoie la pile des entiers positifs dans le même ordre, sans modifier la variable T.
Écrire la fonction remplacer prenant en argument :
une liste d’entiers valeurs
un entier valeur_cible
un entier nouvelle_valeur
et renvoyant une nouvelle liste contenant les mêmes valeurs que valeurs , dans le même ordre, sauf valeur_cible qui a été remplacé par nouvelle_valeur.
**La liste passée en paramètre ne doit pas être modifiée.**
Programmer la fonction est_trie qui prend en paramètre un tableau de valeurs numériques et qui détermine si ce tableau est trié dans l’ordre croissant. La fonction renvoie un booléen True ou False.
**On n'utilisera ni `sort` ni `sorted` dans cet exercice.**
Spécialité NSI, Bulletin officiel n°36 du 30 septembre 2022
Cette note de service définit l’épreuve terminale de l’enseignement de spécialité numérique et sciences informatiques de la classe de terminale de la voie générale. Elle est applicable à compter de la session 2021 du baccalauréat.
Objectifs
L’épreuve porte sur les notions et contenus, capacités et compétences du programme de l’enseignement de spécialité numérique et sciences informatique de la classe de terminale (cf. arrêté du 17 juillet 2019 paru au BOEN spécial n° 8 du 25 juillet 2019). Les notions rencontrées en classe de première (cf. arrêté du 17 janvier 2019 paru au BOEN spécial n° 1 du 22 janvier 2019) mais non approfondies en classe de terminale, doivent être connues et mobilisables. Elles ne peuvent cependant pas constituer un ressort essentiel du sujet.
Nature de l’épreuve
L’épreuve terminale obligatoire de spécialité est composée de deux parties : une partie écrite, comptant pour 12 points sur 20, et une partie pratique comptant pour 8 points sur 20.
La note globale de l’épreuve est donnée sur 20 points.
1. Partie écrite
Durée : 3 heures 30
Modalités
Le sujet comporte trois exercices indépendants les uns des autres, qui permettent d’évaluer les connaissances et compétences des candidats.
2. Partie pratique
Durée : 1 heure
Modalités
La partie pratique consiste en la résolution de deux exercices sur ordinateur, chacun étant noté sur 4 points.
Le candidat est évalué sur la base d’un dialogue avec un professeur-examinateur. Un examinateur évalue au maximum quatre élèves. L’examinateur ne peut pas évaluer un élève qu’il a eu en classe durant l’année en cours.
L’évaluation de cette partie se déroule au cours du deuxième trimestre pendant la période de l’épreuve écrite de spécialité.
Premier exercice
Le premier exercice consiste à programmer un algorithme figurant explicitement au programme, ne présentant pas de difficulté particulière, dont on fournit une spécification. Il s’agit donc de restituer un algorithme rencontré et travaillé à plusieurs reprises en cours de formation. Le sujet peut proposer un jeu de test avec les réponses attendues pour permettre au candidat de vérifier son travail.
Deuxième exercice
Pour le second exercice, un programme est fourni au candidat. Cet exercice ne demande pas l’écriture complète d’un programme, mais permet de valider des compétences de programmation suivant des modalités variées : le candidat doit, par exemple, compléter un programme « à trous » afin de répondre à une spécification donnée, ou encore compléter un programme pour le documenter, ou encore compléter un programme en ajoutant des assertions, etc.
Absence, dispense et aménagement de la partie pratique
Toute absence non justifiée d’un candidat scolaire le jour fixé pour l’évaluation de la partie pratique entraîne l’attribution de la note zéro pour cette partie de l’épreuve. Dans le cas d’une absence justifiée, une épreuve pour le candidat concerné, doit, dans toute la mesure du possible, être organisée au sein de l’établissement et, en tout état de cause, avant la fin de l’année scolaire. Dans l’hypothèse où le candidat ne peut se voir finalement attribuer de note à l’épreuve pratique pour des raisons justifiées, il en est déclaré dispensé.
Les candidats scolaires en situation de handicap peuvent être dispensés par l’autorité académique, à leur demande et sur proposition du médecin désigné par la commission des droits et de l’autonomie des personnes handicapées, de l’épreuve pratique lorsque leur trouble est incompatible avec les activités de manipulation mises en œuvre pendant les séances de travaux pratiques. L’objectif est que le maximum de candidats en situation de handicap puisse passer l’épreuve.
En fonction de l’avis médical, les adaptations peuvent porter sur le choix des types de situations proposés au tirage au sort, sur l’aménagement du poste de travail, sur la majoration du temps imparti, sur l’aide d’un secrétaire, sur la présentation voire l’adaptation de cette situation. Dans ce dernier cas, la situation retenue et adaptée doit permettre une évaluation authentique des compétences visées.
Les candidats individuels et les candidats des établissements d’enseignement privés hors contrat sont dispensés de cette épreuve pratique. Pour ces catégories de candidats régulièrement dispensés, la note de l’épreuve de spécialité numérique et sciences informatiques est constituée de la note obtenue à la partie écrite de l’épreuve rapportée à 20 points. Les candidats inscrits au Centre national d’enseignement à distance ne sont pas dispensés de l’épreuve pratique.
3. Épreuve de remplacement
Il n’y a pas d’épreuve de remplacement pour la partie pratique : en cas d’absence justifiée, la note éventuellement obtenue au cours de l’année scolaire concernant l’évaluation des compétences expérimentales est reportée et prise en compte.
4. Épreuve orale de contrôle
Durée : 20 minutes
Temps de préparation : 20 minutes
L’épreuve consiste en une interrogation du candidat visant à apprécier sa maîtrise des attendus du programme.
Pour préparer l’entretien, l’examinateur propose au moins deux questions au candidat, portant sur des parties différentes du programme. Le candidat dispose d’un temps de préparation de 20 minutes et peut, au cours de l’entretien, s’appuyer sur les notes prises pendant la préparation.
L’examinateur veillera à faciliter l’expression du candidat et à lui permettre de mettre en avant ses connaissances et compétences.
Les conditions matérielles (en particulier la présence d’un tableau, d’un ordinateur) et les énoncés des questions posées seront adaptés aux modalités orales de cette épreuve.
Physique, Chimie et Informatique > Terminales Spé. NSI
Programme NSI de terminale « Entrées prépondérantes » (BO n°36, du 30 septembre 2022)
Lors de l’épreuve terminale dans l’enseignement de spécialité numérique et sciences informatiques, les candidats peuvent être évalués sur les parties suivantes du programme de la classe de terminale :
Rubrique « Structures de données », uniquement les items suivants
Structures de données, interface et implémentation
Vocabulaire de la programmation objet : classes, attributs, méthodes, objets
Listes, piles, files : structures linéaires. Dictionnaires, index et clé


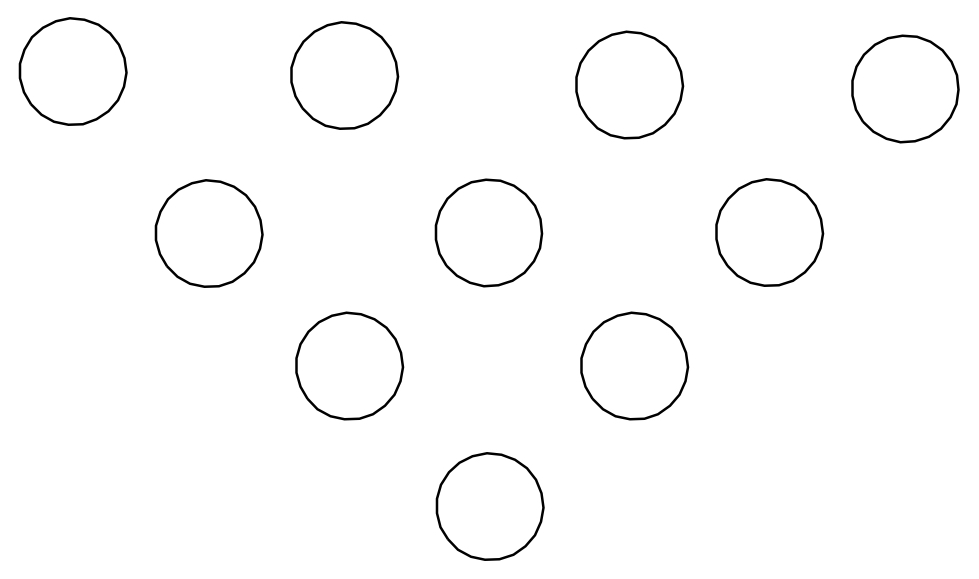
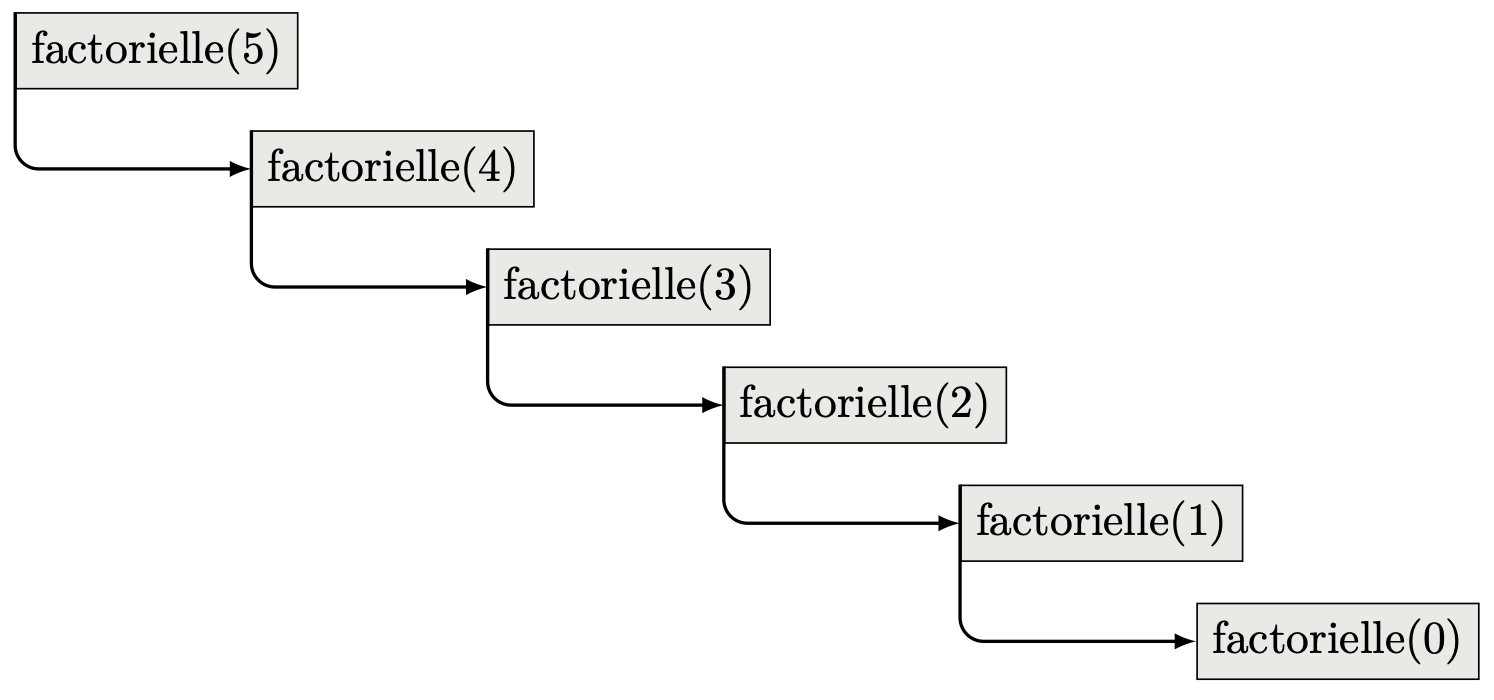

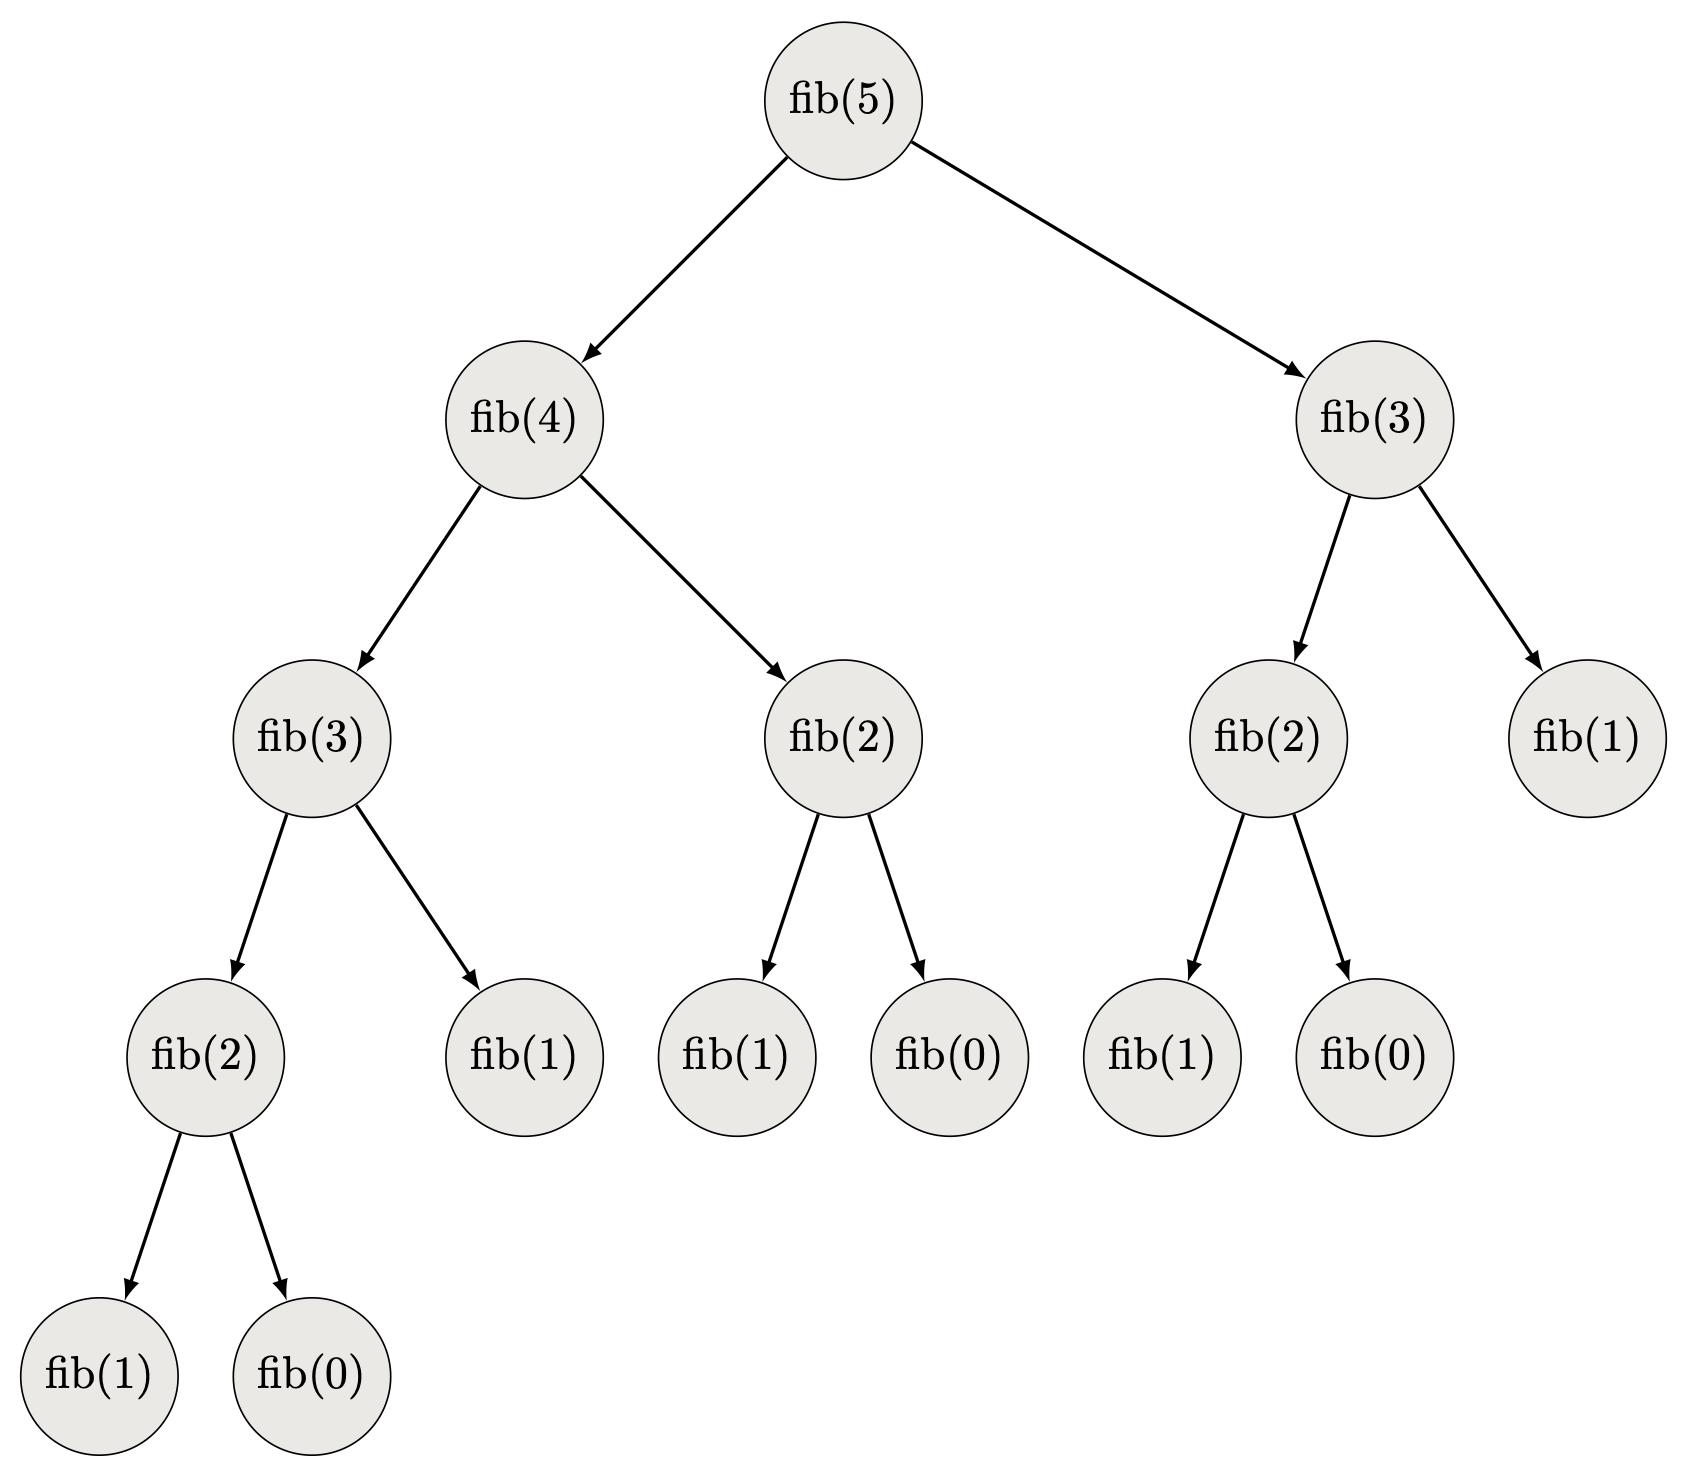
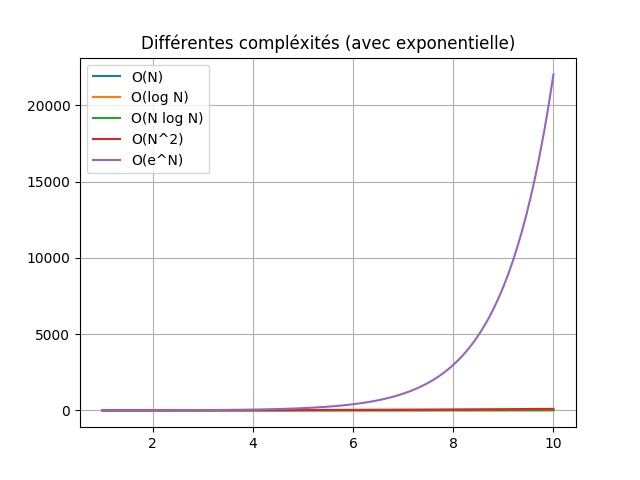
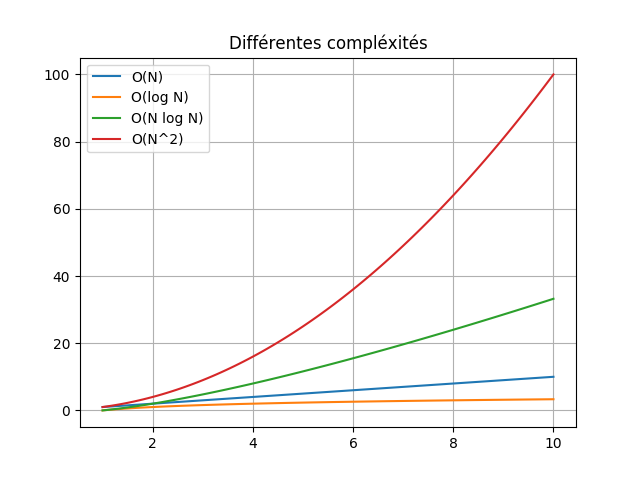
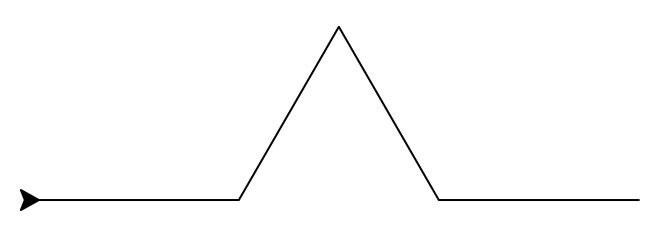
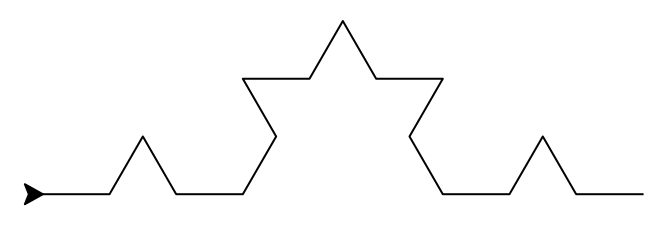
 > Arbre fractal.
 > Base de la construction d'un arbre.
 > Durée de vie des variables locales et globales.
 > Résultat de l'importation du module `os`. Aucune référence à l'attribut `name` n'existe dans l'espace de nom global.


 Le tri par insertion est un tri « naturel » souvent qualifié de « tri du joueur de carte ». Comment un joueur de carte fait-il pour trier les cartes ?
- Au début, la main gauche du joueur est vide et ses cartes sont posées sur la table.
- Le joueur prend alors sur la table les cartes, une par une avec sa main droite, pour les placer dans sa main gauche.
- Pour savoir où placer une carte dans son jeu, le joueur la compare avec chacune des cartes déjà présentes dans sa main gauche, *en examinant les cartes de la droite vers la gauche*.
- *À tout moment, les cartes tenues par la main gauche sont triées* ; ces cartes étaient, à l'origine, les cartes situées au sommet de la pile sur la table.

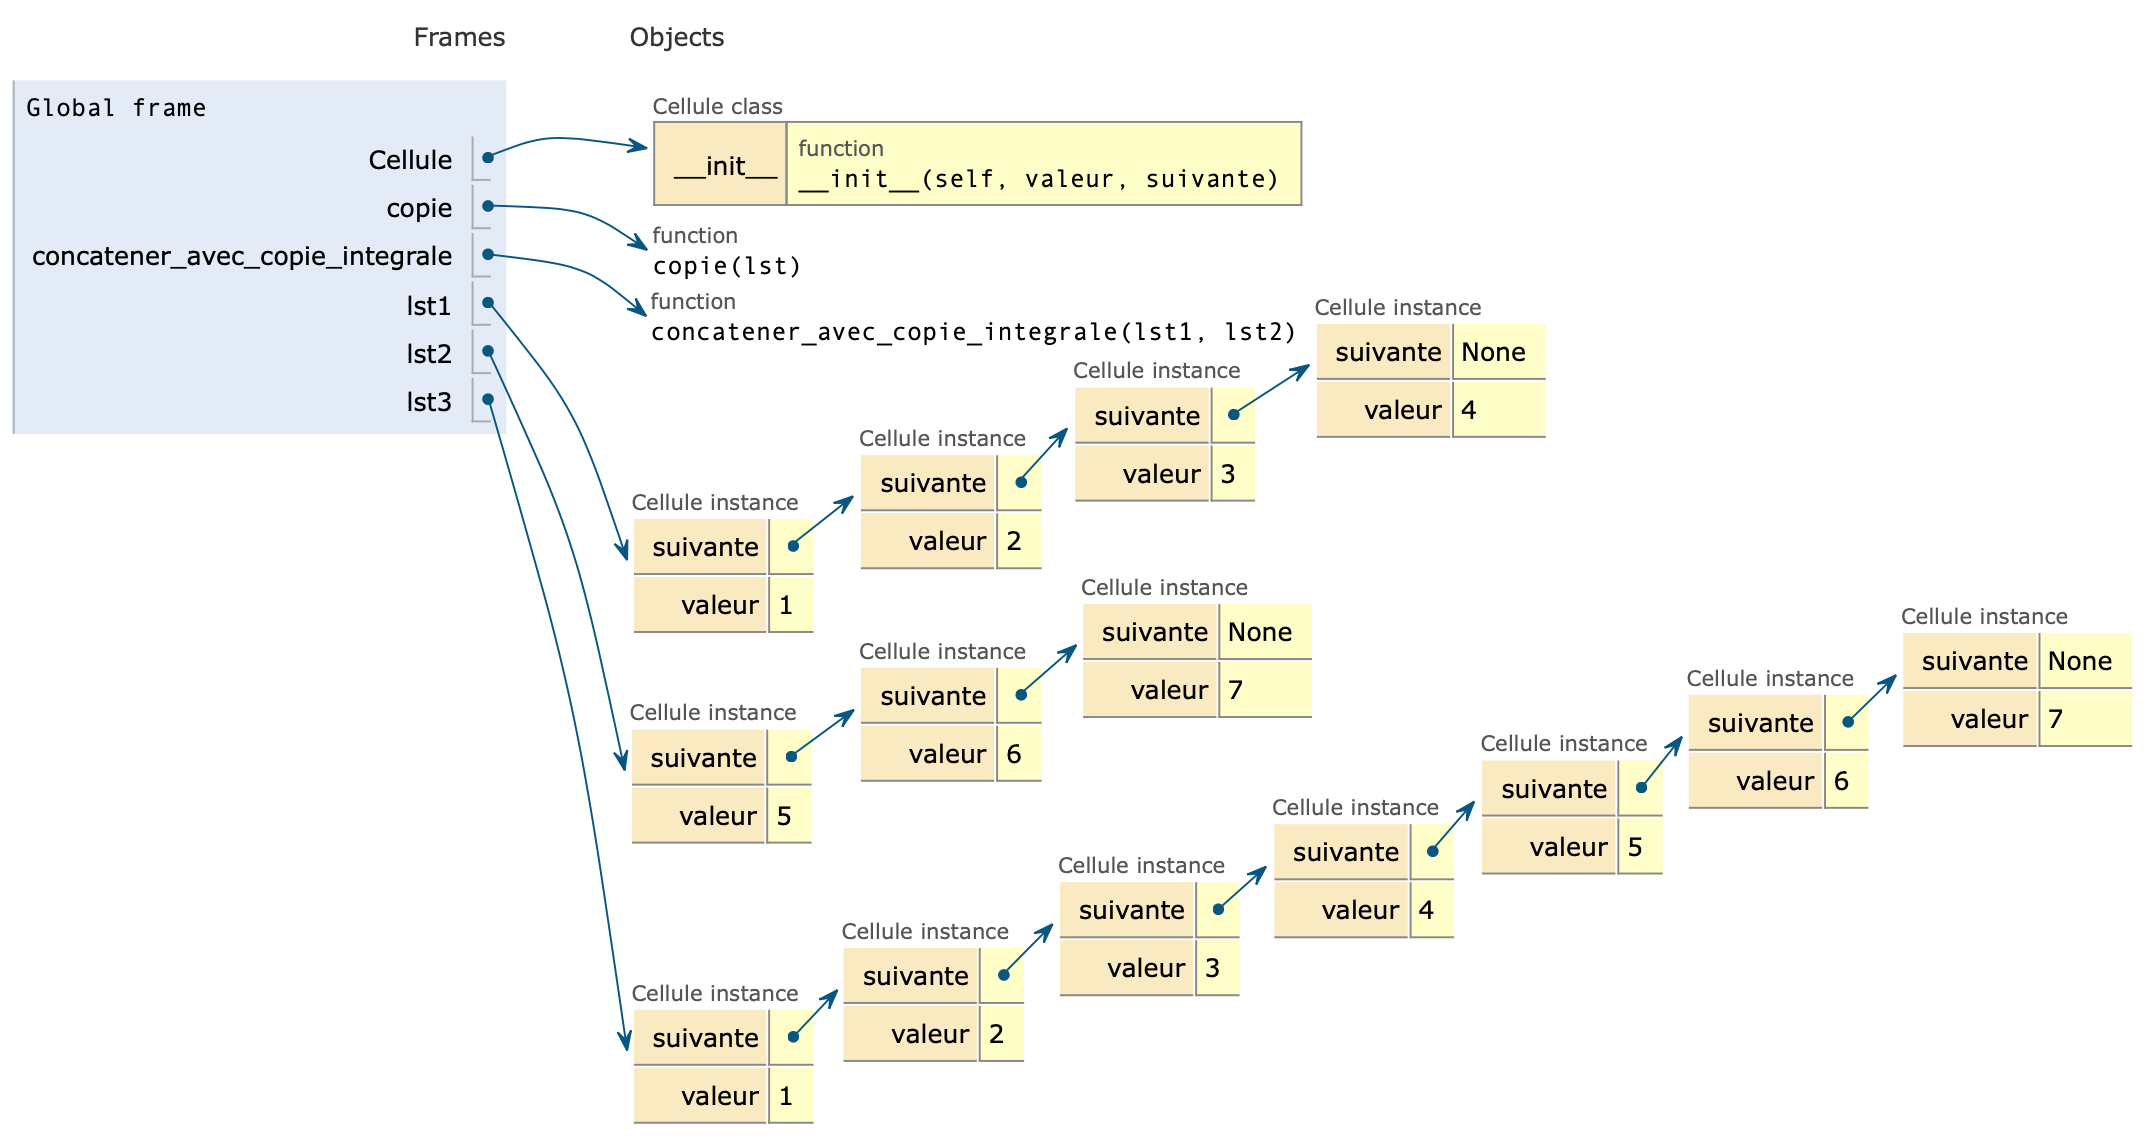
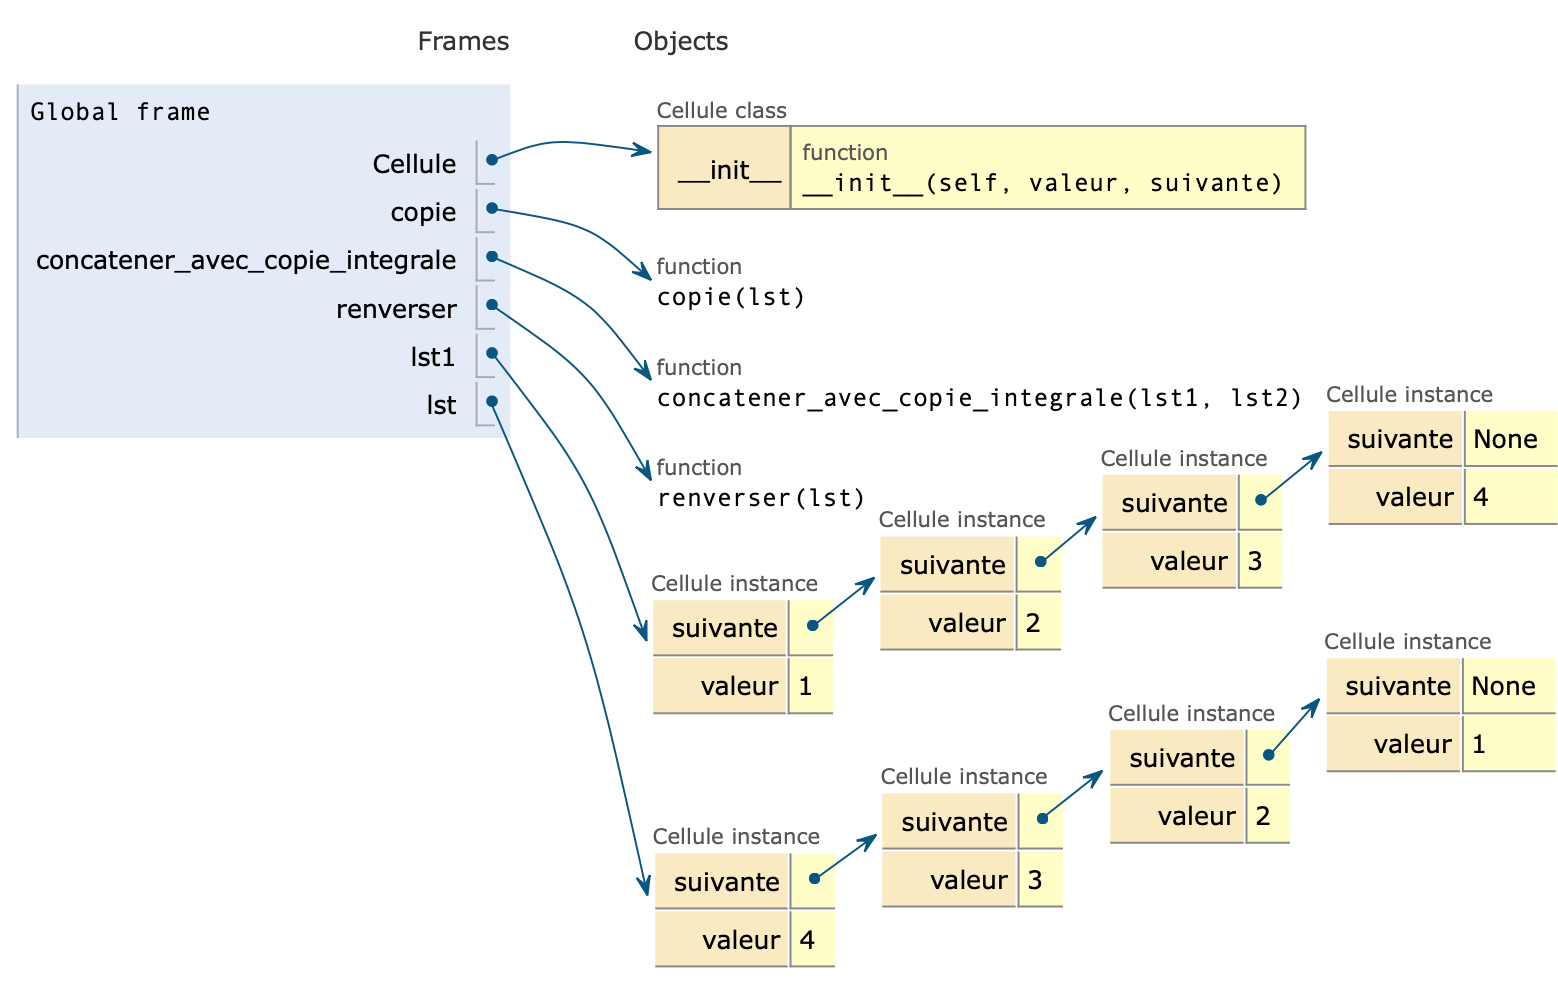


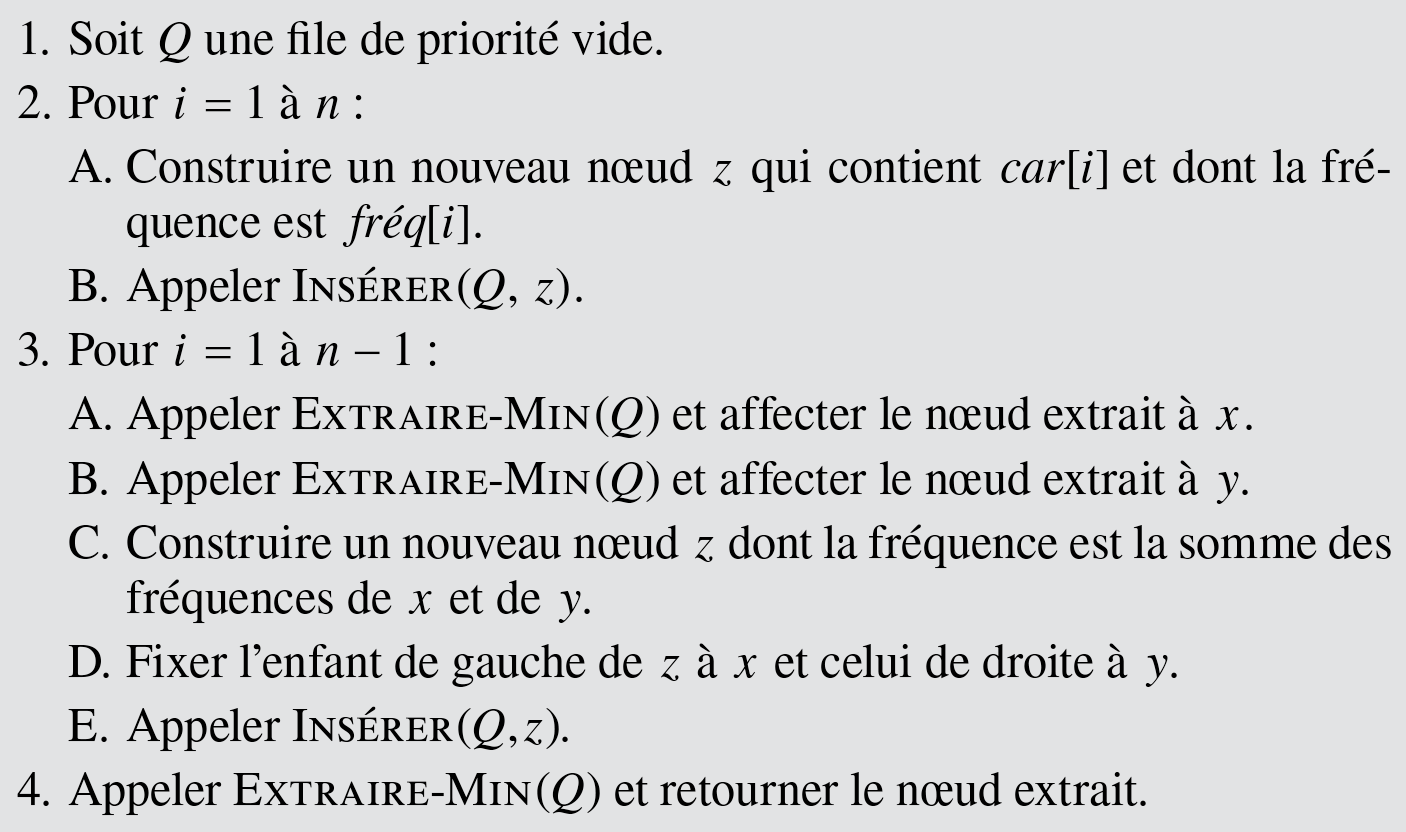
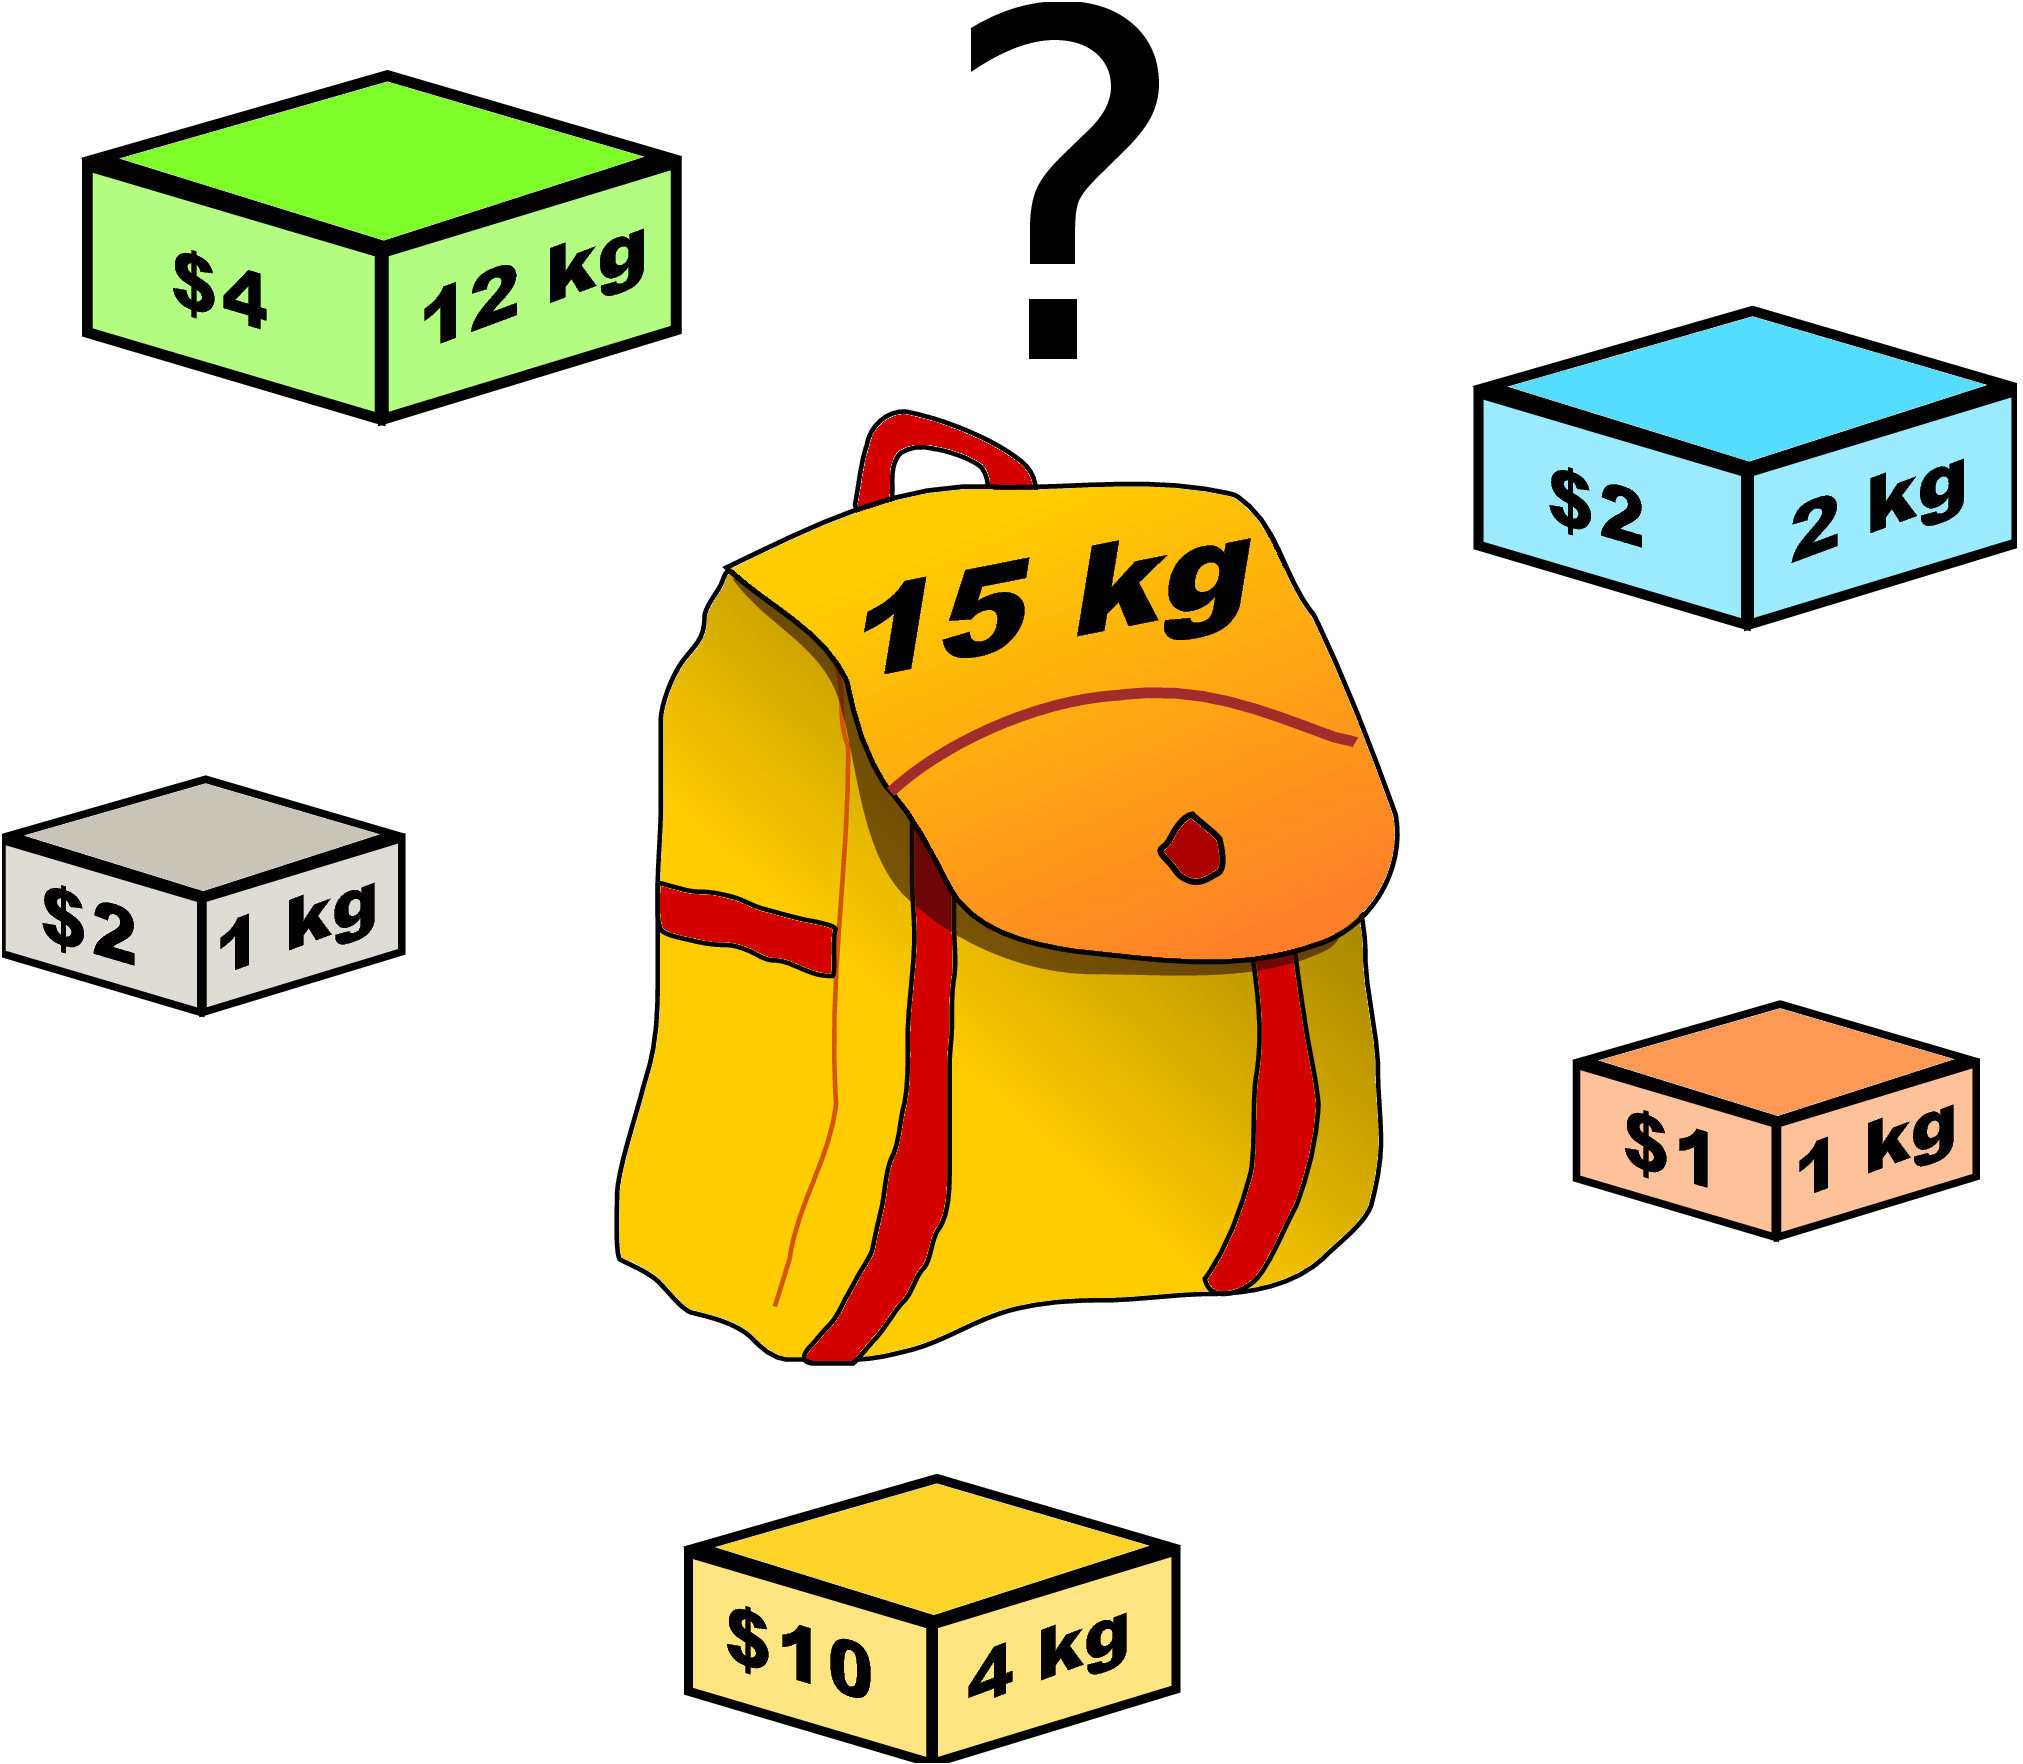 Dans ce document, on s'intéresse à une classe de problèmes d'optimisation connus sous le nom général de « problème du sac à dos ». On peut définir ce problème de la manière suivante : *« durant un cambriolage un voleur possède un sac dont la capacité (en poids par exemple) est limitée. Il se trouve face à un ensemble d'objets qu'il veut dérober. Chacun de ces objets est caractérisé par sa valeur et son poids. Le voleur souhaite optimiser la valeur totale des objets qu'il dérobe tout en ne dépassant pas le poids maximal supporté par son sac ».*
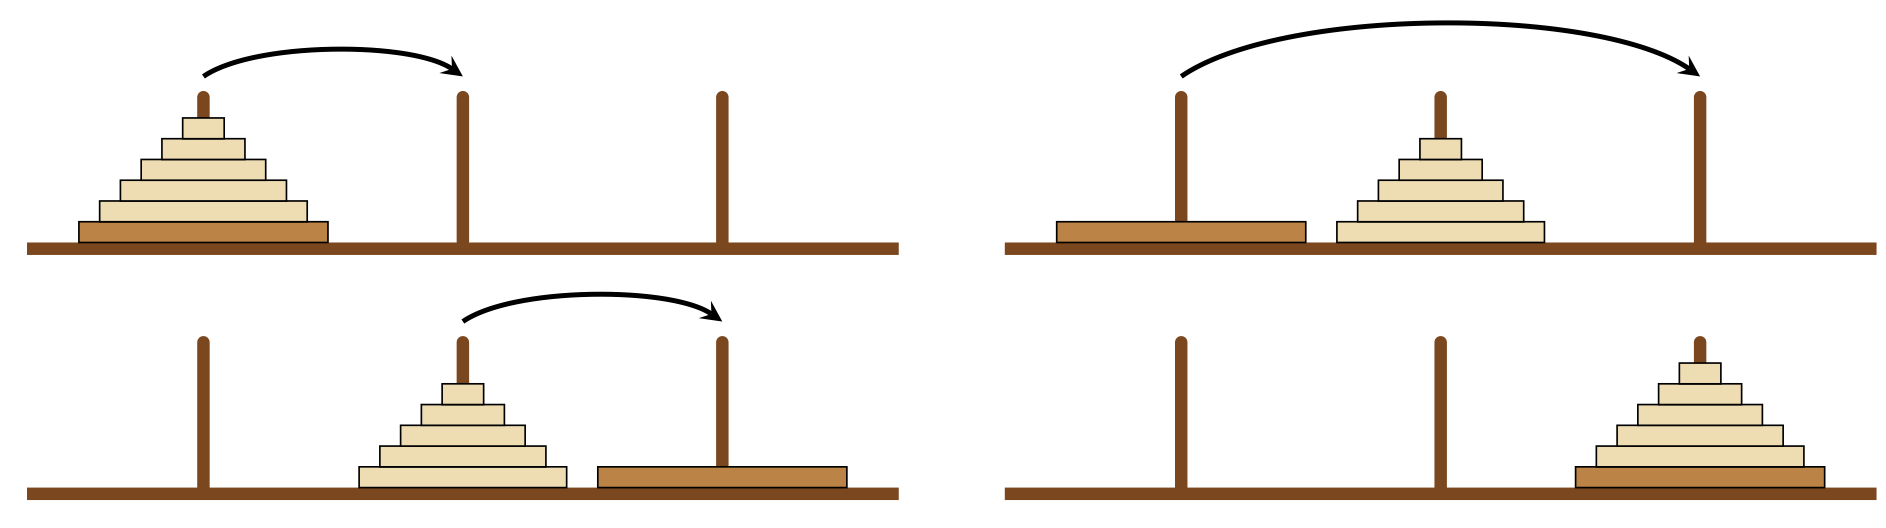
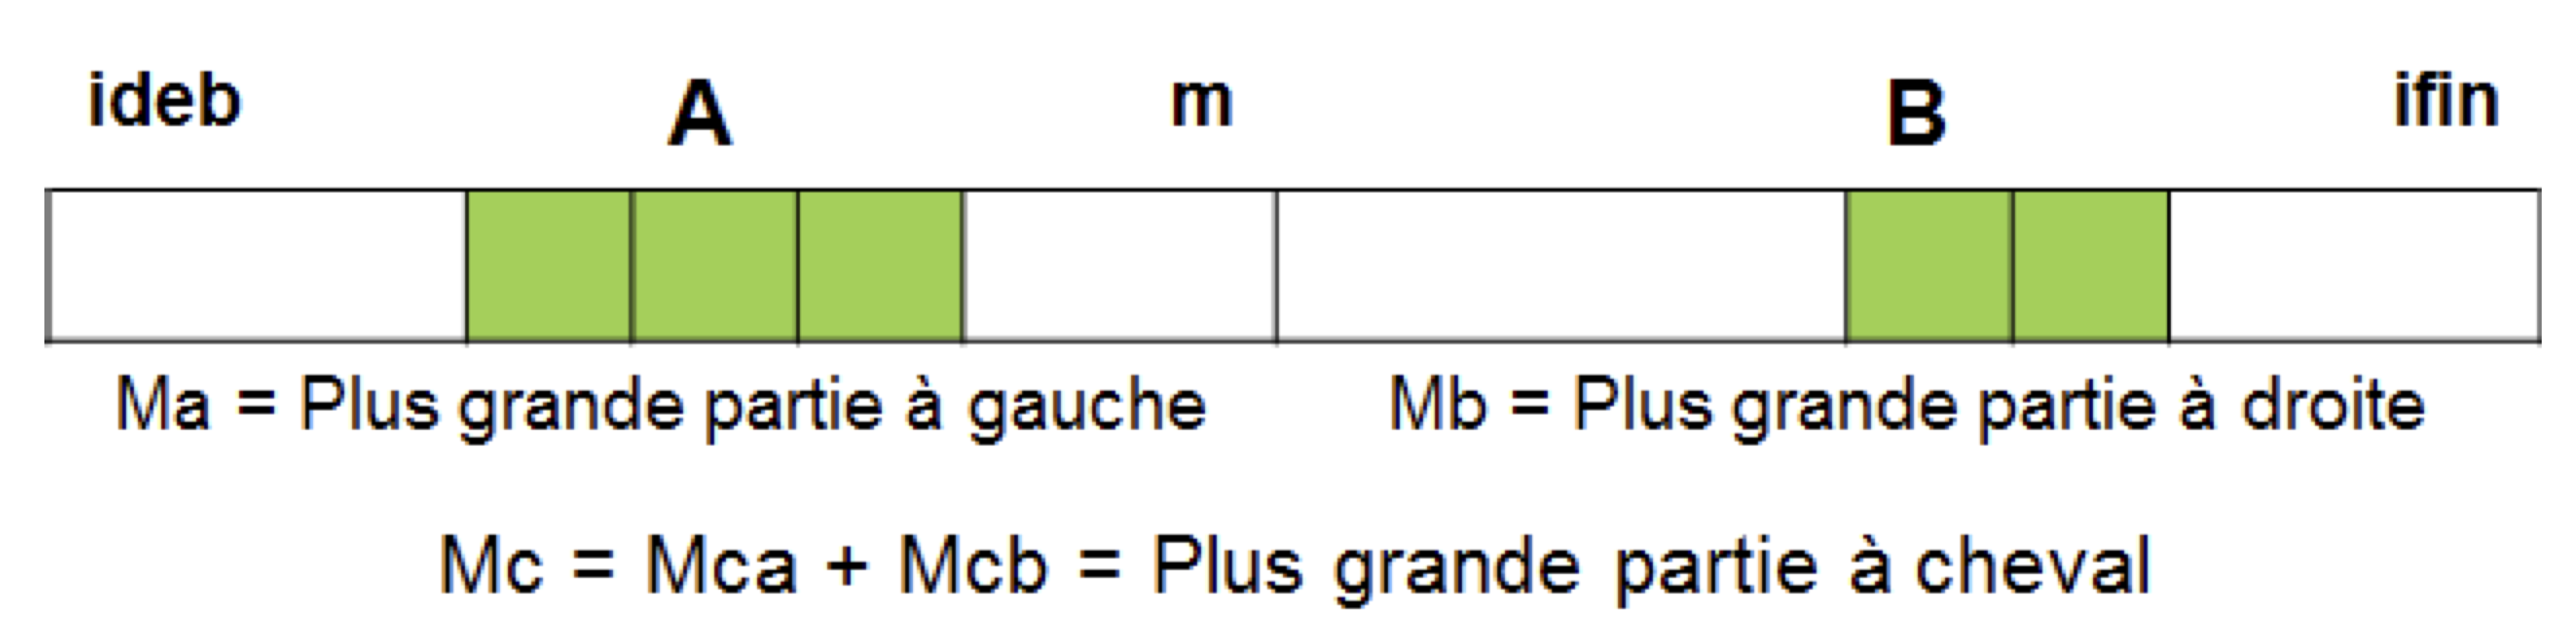
 > Source :




 > Cycle de vie d'un processus