La recherche d’un élément dans un tableau est beaucoup plus efficace si ce
tableau est ordonné. À vrai dire, ce n’est pas en cours d’informatique que
vous avez découvert ceci : dans toutes les bibliothèques les livres sont
classés de façon à rendre leur recherche plus rapide !
Info
Le tri des tableaux/listes permet de trouver rapidement les objets recherchés et facilite la recherche des valeurs extrêmes.
La question que se propose d’aborder ce document est donc : « comment classer les éléments d’un tableau selon une relation d’ordre donnée ? ».
Cette question est suffisamment importante pour que de nombreux chercheurs se
soient penchés sur le problème et aient proposé plusieurs dizaines
d’algorithmes différents. Certains sont spécifiques au données numériques,
certains copient les données dans une nouvelle structure ou une structure temporaire (ce qui réclame de l’espace en mémoire supplémentaire), certains effectuent un tri en place (c’est à dire dans le même espace mémoire), certains sont stables (ils préservent alors l’ordre initial des valeurs égales), …
Ce document aborde l’étude du tri par sélection.
Du plus léger au plus lourd
Pour donner une idée de la difficulté du problème de tri, on peut utiliser le
petit jeu à cette adresse.
L’objectif est de trier quelques tonneaux (entre 3 et 10) par ordre de masse
croissante, la masse de chaque tonneau étant attribuée aléatoirement.
On peut utiliser le « Glisser – Déposer » pour déplacer les tonneaux.
On dispose :
d’une balance non étalonnée permettant de comparer les masses des tonneaux 2 à
2
d’étagères pouvant servir de stockage intermédiaire.
Info
Ce sont exactement les mêmes éléments que ceux dont dispose un ordinateur :
une fonction de comparaison et des zones de stockage.
Le but ultime du jeu est évidemment de trier ces tonneaux en faisant le moins
de comparaisons et d’échanges possibles.
Limiter l’animation à trois tonneaux et trouver le tonneau le plus léger.
Décrire la méthode employée. Combien de comparaisons est-il nécessaire de
faire ?
Réponse
On compare les deux premiers tonneaux et on conserve le plus léger sur la
balance. On compare alors ce tonneau à celui qui reste dans la liste de
tonneaux. Deux comparaisons sont donc nécessaires.
Toujours à partir de trois tonneaux, les trier du plus léger au plus lourd.
Décrire la méthode employée (on peut schématiser toutes les étapes sur sa
feuille). Combien de comparaisons est-il nécessaire de faire ?
Réponse
Sans utilisation de la zone de stockage, il faut effectuer 3 comparaison. On peut se
contenter de deux comparaisons si on utilise la zone de stockage.
Choisir maintenant cinq tonneaux. Les trier du plus léger au plus lourd.
Décrire la méthode employée et indiquer combien de comparaisons ont été
effectuées.
(Facultatif) Toujours à partir de cinq tonneaux, essayer de trouver une autre
méthode permettant de les trier. La décrire.
Algorithme de tri
À retenir
Un algorithme de tri est, en informatique ou en mathématiques, un algorithme
qui permet d’organiser une collection d’objets selon un ordre déterminé.
Les objets à trier font donc partie d’un ensemble muni d’une relation d’ordre.
Les ordres les plus utilisés sont l’ordre numérique et l’ordre lexicographique
(dictionnaire).
Tri par sélection
Introduction
La méthode du tri par insertion est expliquée à cette adresse, ou, de façon plus folklorique, à cette adresse.
Remarque : si la folie vous guette, évitez absolument cette vidéo… ou pas !
Visualiser la première vidéo (s’arrêter au bout de 4min40). Essayer de bien
comprendre la méthode.
Appliquer la méthode dans le jeu des tonneaux et trier cinq tonneaux du plus léger au plus lourd. Cette méthode était-elle celle que vous aviez mise en œuvre dans la section 1 ?
La méthode étant bien comprise, choisir sept cartes à jouer (avec les valeurs numériques, pas des figures). Les placer en ligne au hasard sur une table et les trier en appliquant le tri par sélection. Se filmer pendant toute l’opération en commentant chacune des étapes !
Algorithme
Info
À chaque étape du processus, le tableau est divisé en deux sous-tableaux : le
premier (indices plus petits que l’indice courant) est trié, le second
(indices plus grands que l’indice courant n’est pas encore trié). On cherche,
à partir de la position courante, la plus petite valeur dans le sous-tableau
non trié (à droite) et une fois cette dernière trouvée, on permute (si
nécessaire) la valeur courante et la valeur la plus petite.
Remarque : La permutation des valeurs contenues dans deux variables est souvent employée en informatique, elle nécessite une troisième variable pour un stockage
temporaire.
À retenir
Le tri par sélection est basé sur l’utilisation de deux boucles Pour imbriquées :
La première boucle parcourt la liste des valeurs, de la première à l’avant dernière ;
La seconde boucle recherche la plus petite valeur, de la position courante (compteur de la première boucle) à la fin du tableau, puis l’échange avec la position courante.
La partie gauche de la liste est donc triée au fur et à mesure de l’avancement
de la première boucle.
L’algorithme du tri par sélection est un algorithme de tri en place : la
réorganisation du tableau ne nécessite pas la création d’un nouveau tableau,
ce qui économise de la place en mémoire.
À partir de toutes les informations précédentes, écrire l’algorithme du tri par sélection. Implémenter cet algorithme en Python.
Réponse
fromrandomimportrandintdeftri_selection(tab:list[int|float])->None:"""
Tri par sélection.
"""foriinrange(len(tab)-1):# On s'arrête à l'avant-dernier élémentval_min=tab[i]# On sauvegarde la valeur couranteforjinrange(i+1,len(tab)):# On s'arrête au dernier élémentiftab[j]<val_min:val_min=tab[j]# On repère la valeur la plus petitej_min=j# et son indicetab[j_min]=tab[i]tab[i]=val_minif__name__=="__main__":tab=[randint(1,1000)foriinrange(20)]print(tab)tri_selection(tab)print(tab)
Faire tourner « à la main » l’algorithme lorsque la fonction reçoit le tableau
tab = [5,2,4,6,1,3].
Comment prouve-t-on, de façon générale, la terminaison d’un algorithme ?
Réponse
On recherche un variant de boucle.
À retenir
Un variant de boucle est une expression arithmétique associée à une boucle qui satisfait deux conditions :
Valeur initiale : Le variant doit être initialisé avec une valeur entière non négative avant que la boucle ne commence.
Décroissance : À chaque itération de la boucle, la valeur du variant doit décroître. Cela signifie que le variant agit comme une mesure de progression vers la sortie de la boucle.
L’idée derrière la notion de variant de boucle est que si le variant est toujours non négatif et diminue lors de la progression de la boucle, alors la boucle ne peut pas continuer indéfiniment. Si la boucle continue indéfiniment, cela signifie que le variant ne décroît pas à chaque itération, ce qui contredit la propriété de décroissance du variant.
Est-il nécessaire de prouver la terminaison de cet algorithme ?
Réponse
L’algorithme fait intervenir deux boucles Pour. Il se termine donc forcément puisqu’il s’agit de boucles déterministes.
Comment prouve-t-on, de façon générale, la correction d’un algorithme ?
Réponse
On recherche un invariant de boucle.
À retenir
Un invariant de boucle est une proposition vraie à chaque tour de boucle. Associé à une postcondition il permet, au final, de montrer la correction d’un algorithme.
Pour qu’un invariant de boucle soit efficace, il doit satisfaire deux propriétés essentielles :
Initialisation : L’invariant doit être vrai avant la première itération de la boucle. Cela garantit que l’invariant est une propriété valable lorsque la boucle commence son exécution.
Conservation : Si l’invariant est vrai avant une itération de la boucle, alors il doit également rester vrai après l’itération, à condition que la condition de boucle (la condition qui détermine si la boucle doit continuer ou s’arrêter) soit vraie. Cela assure que l’invariant reste préservé à chaque étape de la boucle.
Un invariant de boucle doit être associé à une postcondition, c’est dire à une propriété qui doit être vraie à la fin de la boucle.
Prouver que la proposition « Au début de chaque itération de la boucle Pour externe le tableau tab[0, ..., i-1] est un tableau trié constitué des i plus petits éléments du tableau tab, dans l’ordre croissant.» est un invariant de boucle.
Prouver que l’algorithme est correct.
Réponse
Déterminer la complexité de l’algorithme.
Dans quels cas le tri par sélection peut-il être pertinent ?
Le tri par sélection est globalement peu efficace. On peut tout de même lui attribuer quelques qualités :
Petites quantités de données : Le tri par sélection peut être efficace pour trier de petites quantités de données. Sa complexité en temps est de l’ordre de O(n2), ce qui peut devenir inefficace pour des ensembles de données très importants. Pour des listes de taille modérée, le tri par sélection peut être simple à comprendre et à mettre en œuvre.
Complexité en espace : Le tri par sélection n’a besoin que d’une quantité constante d’espace supplémentaire, ce qui signifie qu’il peut être plus efficace en termes de mémoire que d’autres algorithmes qui nécessitent une mémoire auxiliaire plus importante.
Stabilité : Le tri par sélection est stable, ce qui signifie qu’il préserve l’ordre relatif des éléments égaux. Si la stabilité est une exigence, le tri par sélection peut être préférable dans certains cas.
Peu de mouvements d’éléments : Bien que le tri par sélection effectue un nombre quadratique de comparaisons, le nombre de mouvements d’éléments est linéaire (l’échange d’éléments n’a lieu qu’une seule fois à chaque itération). Cela peut être avantageux dans des situations où le coût des comparaisons est faible par rapport au coût des déplacements d’éléments dans la mémoire.
Physique, Chimie et Informatique > Terminales Spé. NSI > Algorithmes de tri
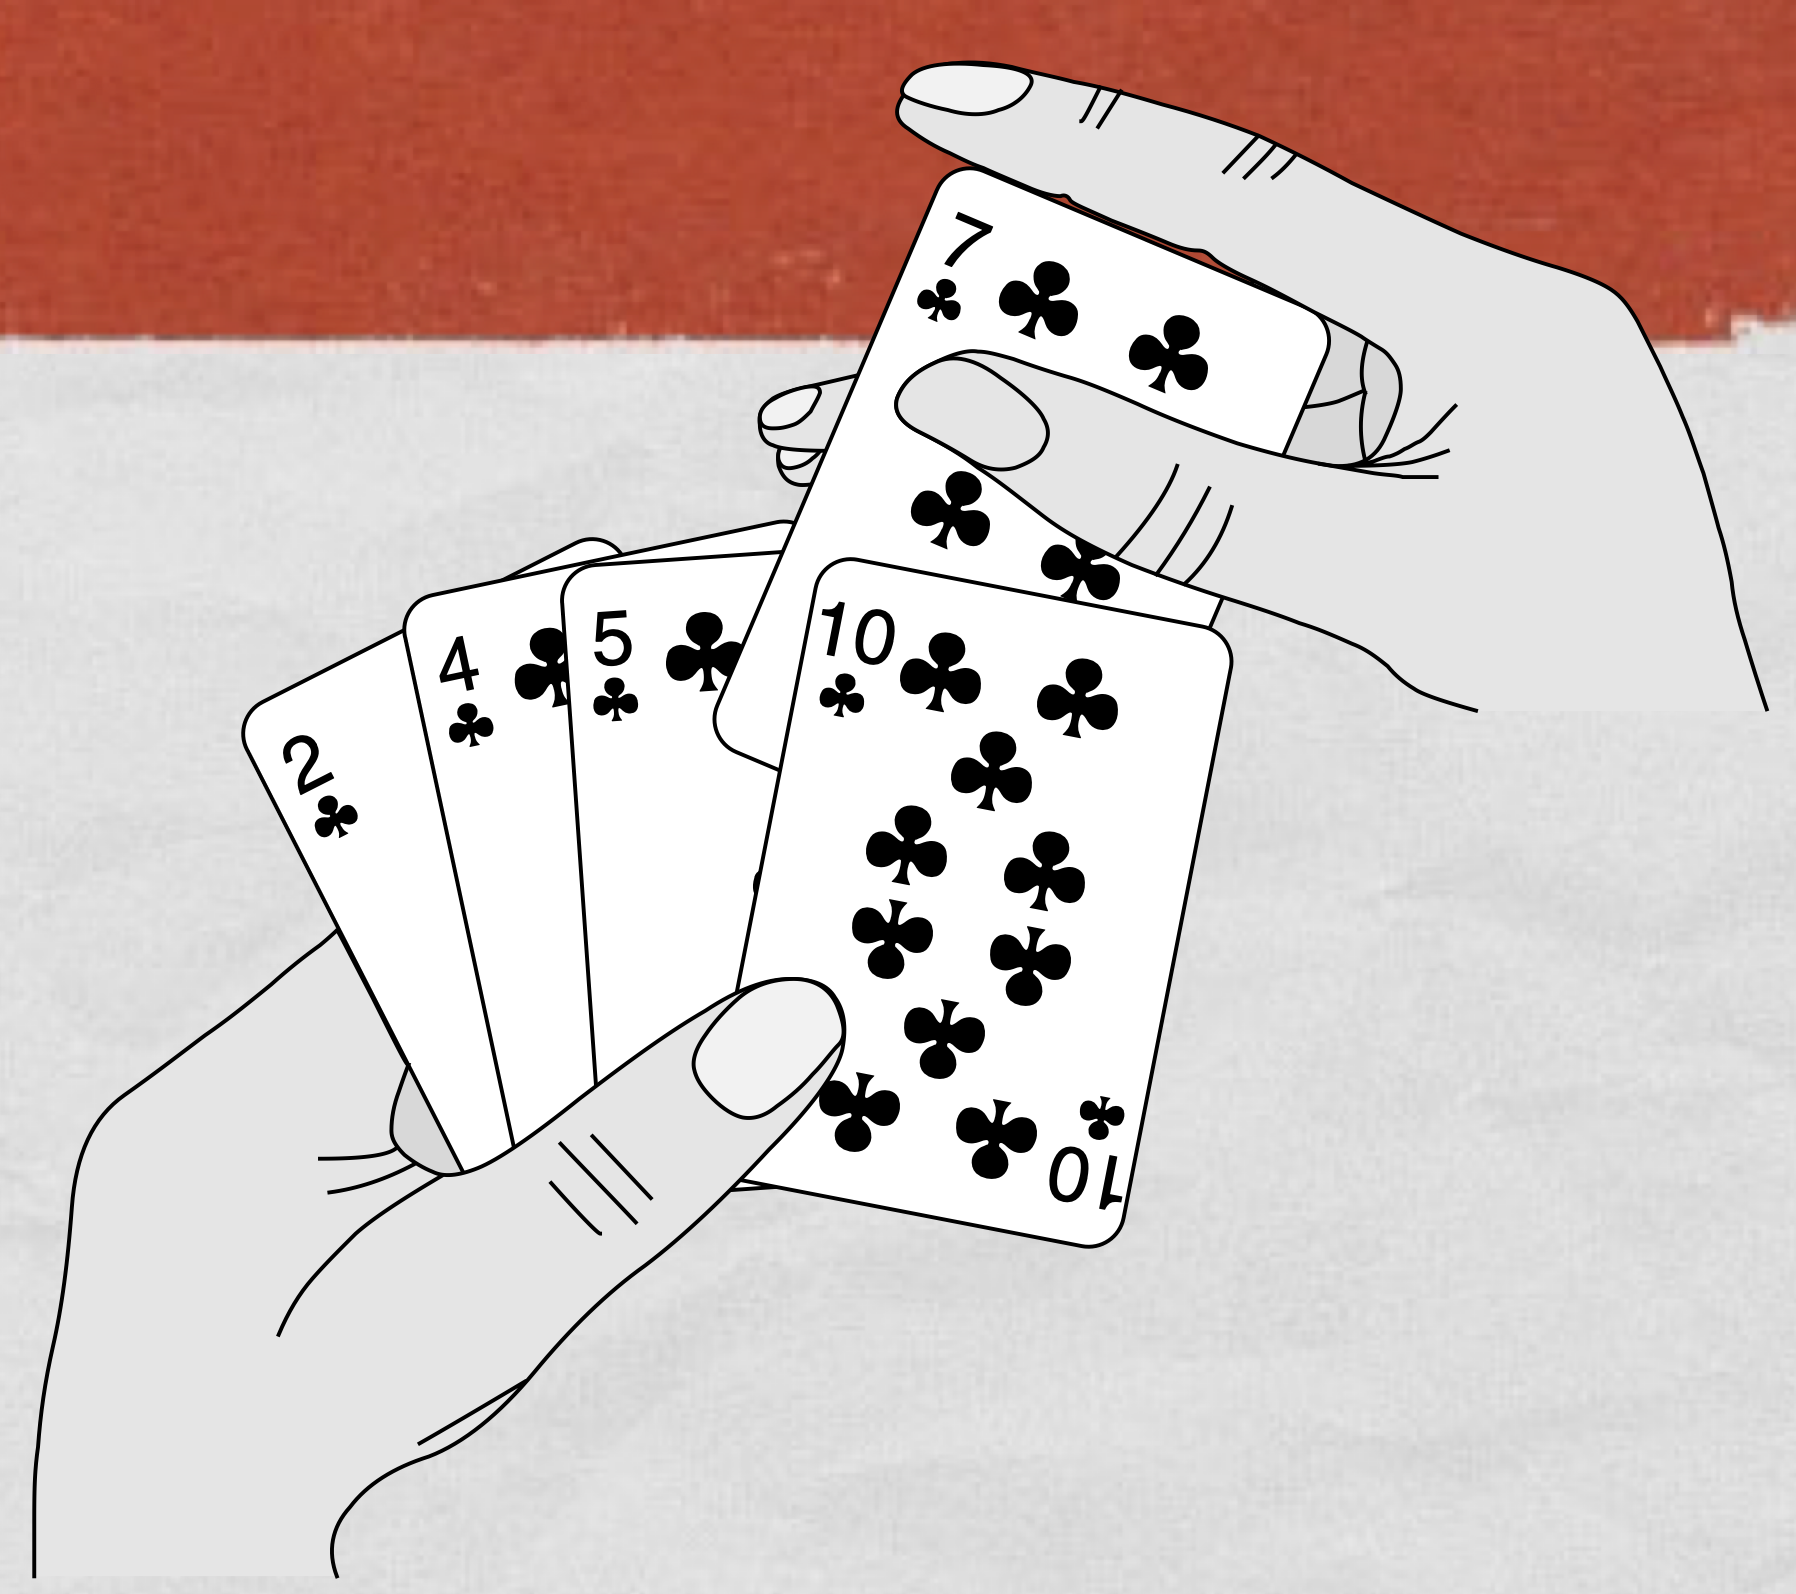
Le tri par insertion est un tri « naturel » souvent qualifié de « tri du
joueur de carte ».
Comment un joueur de carte trie-t-il ses cartes ?
Au début, la main gauche du joueur est vide et ses cartes sont posées sur la
table.
Le joueur prend alors sur la table les cartes, une par une avec sa main
droite, pour les placer dans sa main gauche.
Pour savoir où placer une carte dans son jeu, le joueur la compare avec
chacune des cartes déjà présentes dans sa main gauche, en examinant les cartes
de la droite vers la gauche.
À tout moment, les cartes tenues par la main gauche sont triées ; ces cartes
étaient, à l’origine, les cartes situées au sommet de la pile sur la table.
Choisir sept cartes à jouer. Les placer en ligne au hasard sur une table et
mettre en œuvre la technique décrite ci-dessus. Se filmer pendant toute l’opération en commentant chacune des étapes !
Tri par insertion
Introduction
La méthode du tri par insertion est ilustré à cette adresse, ou, de façon plus folklorique, à cette adresse.
Remarque : si la folie vous guette, évitez absolument cette vidéo… ou pas !
Visualiser la première vidéo (s’arrêter au bout de 4min40). Essayer de bien
comprendre la méthode.
La méthode étant bien comprise, choisir sept cartes à jouer (avec les valeurs
numériques, pas des figures). Les placer en ligne au hasard sur une table et
les trier en appliquant le tri par insertion.
Se filmer pendant toute l’opération en commentant chacune des étapes !
Algorithme
Info
À chaque étape du processus, le tableau est divisé en deux sous-tableaux : le
premier (indices plus petits que l’indice courant) est trié, le second
(indices plus grands que l’indice courant n’est pas encore trié). On cherche
la place de l’élément courant (non encore trié) dans le tableau trié.
À retenir
Le tri par insertion est basé sur l’utilisation de deux boucles imbriquées :
La première boucle, une boucle Pour, parcourt la liste des valeurs, de la
deuxième à la dernière ;
La seconde boucle, une boucle TantQue, cherche à placer l’élément courant
dans la première partie triée du tableau (indices inférieurs à l’indice
courant).
L’algorithme du tri par insertion est un algorithme de tri en place. La
réorganisation du tableau ne nécessite pas la création d’un nouveau tableau,
ce qui économise de la place en mémoire.
À partir de toutes les informations précédentes, écrire l’algorithme du tri par insertion. Implémenter cet algorithme en Python.
Réponse
deftri_insertion(tab:list[int|float|str])->None:""" Tri par insertion """foriinrange(1,len(tab)):valeur=tab[i]# Sauvegarde de la valeur en coursj=i-1# Indice de la boucle internewhiletab[j]>valeurandj>=0:tab[j+1]=tab[j]# On remonte la valeur plus grandej=j-1tab[j+1]=valeur# On insère la valeur dans le tableau
Faire tourner « à la main » l’algorithme lorsque la fonction reçoit le tableau
tab = [5,2,4,6,1,3].
Comment prouve-t-on, de façon générale, la terminaison d’un algorithme ?
Est-il nécessaire de prouver la terminaison de la boucle externe de cet
algorithme ? De la boucle interne ?
Démontrer la terminaison de cet algorithme.
Comment prouve-t-on, de façon générale, la correction d’un algorithme ?
Prouver que la proposition « Au début de chaque itération de la boucle Pour externe le tableau tab[0, ..., i-1] est un tableau trié dans l’ordre croissant.» est un invariant de boucle.
Prouver que l’algorithme est correct.
Déterminer la complexité de l’algorithme.
Info
Le tri par sélection est globalement peu efficace. On peut tout de même lui attribuer quelques qualités :
Pour de petites listes ou des données déjà partiellement triées : Si vous avez une petite liste d’éléments à trier ou si votre liste est déjà partiellement triée, le tri par insertion peut être plus simple et rapide que d’autres méthodes.
Si vous voulez que l’ordre initial des éléments identiques soit préservé : Le tri par insertion est une méthode « stable », ce qui signifie qu’il conserve l’ordre d’origine des éléments égaux. Cela peut être important dans certaines situations.
Lorsque vous ajoutez de nouveaux éléments à une liste déjà triée : Le tri par insertion s’adapte bien lorsque vous ajoutez de nouveaux éléments à une liste déjà triée. En effet, la plupart des éléments sont déjà à leur place correcte ; le tri par insertion profite donc de cette caractéristique en minimisant le nombre d’opérations nécessaires pour insérer de nouveaux éléments car il peut sauter rapidement à travers la partie triée sans avoir à déplacer de nombreux éléments.
Si vous avez des contraintes de mémoire : Le tri par insertion est un tri en place, il utilise une quantité constante de mémoire supplémentaire, ce qui peut être avantageux si vous avez des contraintes de mémoire.