Physique, Chimie et Informatique > Terminales Spé. NSI
Programmation fonctionnelle
Au programme
Contenus
Capacités attendues
Commentaires
Paradigmes de programmation.
- Distinguer sur des exemples les paradigmes impératif, fonctionnel et objet. - Choisir le paradigme de programmation selon le champ d’application d’un programme.
Avec un même langage de programmation, on peut utiliser des paradigmes différents. Dans un même programme, on peut utiliser des paradigmes différents.
S’il n’est pas facile de répondre précisément à cette question, on peut essayer de mettre en évidence les idées que le paradigme fonctionnel promeut :
Les fonctions doivent être des objets de première classe, c’est à dire que les fonctions doivent pouvoir être passées comme arguments à une fonction, les fonctions doivent aussi pouvoir être retournées par une fonction.
Les fonctions doivent (le plus possible) être pures, c’est à dire ne générer aucun effet de bord.
La manipulation de variable doit être la plus limitée possible : il est possible de s’en servir comme étiquettes mais le contenu de ces variables doit être le moins modifié possible.
Les fonctions doivent permettre la composition : la valeur d’une fonction est passée comme argument à une fonction dont la valeur est passée comme argument à une autre fonction, …
En fait, le programme lui-même est évalué et retourne une valeur.
La récursion doit être utilisée à la place des boucles puisqu’il n’est pas question de modifier l’état d’un programme (donc la valeur d’un compteur de boucle, par exemple).
Les listes (c’est même l’origine du langage Lisp) sont souvent la structure de données de base des programmes fonctionnels.
Il n’est cependant pas question de modifier ces listes (méthode append).
Découverte des quelques éléments de programmation fonctionnelle
Suite de Collatz
On peut générer la suite de Collatz, pour un entier n donné, de la sorte :
si n est pair, on le divise par 2 ;
sinon on le multiplie par 3 et on ajoute 1.
On stoppe le processus lorsque la valeur de n est égale à 1.
La définition de la suite est donc :
un+1={2un3un+1si un est pairsinon.
Récursivité
Définir la fonction dont la spécification est :
defcollatz_iter(n:int)->None:"""
Implémentation de l'algorithme itératif qui permet de déterminer la suite de Collatz".
La fonction affiche les termes.
"""
Solution
defcollatz_iter(n:int)->None:"""
Implémentation de l'algorithme itératif qui permet de construire la suite de Collatz".
La fonction affiche les termes.
"""whilen!=1:print(n,end=" ")ifn%2==0:n=n//2else:n=3*n+1print(1)
Définir la fonction dont la spécification est :
defcollatz_recur(n:int)->None:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La fonction affiche les termes.
"""
Solution
defcollatz_recur(n:int)->None:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La fonction affiche les termes.
"""ifn==1:print(1)else:print(n,end=" ")ifn%2==0:returncollatz_recur(n//2)else:returncollatz_recur(3*n+1)
Génération de listes
Définir la fonction dont la spécification est :
defcollatz(n:int)->List[int]:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La suite est retournée sous forme d'une liste.
"""
Solution
defcollatz(n:int)->List[int]:"""
Implémentation de l'algorithme récursif qui permet de construire la suite de Collatz.
La suite est retournée sous forme d'une liste.
"""ifn==1:return[1]else:ifn%2==0:return[n]+collatz(n//2)else:return[n]+collatz(3*n+1)
Comment manipuler une liste sans réaliser la moindre boucle ?
Après avoir construit la liste contenant la suite de Collatz débutant au nombre n, on peut vouloir en extraire, par exemple, tous les nombres pairs.
À l’aide de la fonction help découvrir la spécification de la fonction filter. Écrire cette spécification en français.
Réponse
filter(functionorNone,iterable)-->filterobject"""
Retourne un itérateur dont les valeurs sont celles pour
lesquelles l'application de la fonction function retourne
True.
Si aucune fonction n'est fournie, retourne un itérateur dont
les valeurs sont les valeurs True
"""
Définir la fonction dont la spécification est la suivante :
defest_pair(n:int)->bool:"""
Détermine si n est pair.
"""
Solution
defest_pair(n:int)->bool:"""
Détermine si n est pair.
"""returnn%2==0
Quelle instruction permet de générer une nouvelle liste ne contenant que les éléments pairs de la liste générée par l’application collatz(7) ?
Remarque :filter réalise une évaluation paresseuse et ne retourne pas une liste mais un itérateur. Ce concept est fondamental en programmation fonctionnelle mais ne sera pas abordé dans ce document.
Le résultat de l’application de filter doit donc être passé comme argument à la fonction list : list(filter(..., ...)).
Solution
list(filter(est_pair,collatz(7)))
Programmer la fonction est_pair avec le mot-clé def nécessite d’entrer de nombreuses lignes de code pour, au final, ne nécessiter qu’une seule expression : n % 2 == 0. Les langages fonctionnels permettent généralement de définir des fonctions anonymes (lambda expressions).
En Python, l’expression
lambdax,y:x**y
est une fonction qui associe à x et y le nombre xy. L’application suivante est donc possible
>>>(lambdax,y:x**y)(2,3)8
Malheureusement, la fonction anonyme, une fois utilisée est « perdue » puisqu’elle ne possède pas de nom ! Il est cependant possible de la référencer par une variable :
>>>au_carre=lambdax:x**2>>>au_carre(2)4
Avertissement
Les fonctions anonymes sont limitées à une expression en Python.
Reprendre l’instruction qui permet de générer une nouvelle liste ne contenant que les éléments pairs de la liste générée par l’application collatz(7), en remplaçant l’appel à la fonction est_pair par une fonction anonyme.
Solution
list(filter(lambdan:n%2==0,collatz(7)))
À l’aide de la fonction help découvrir la spécification de la fonction map. Écrire cette spécification en français.
Réponse
map(func,*iterables)-->mapobject"""
Retourne un itérateur qui applique la fonction func
à chaque valeur de l'itérateur *iterables passé en
argument.
Stoppe une fois que toutes les valeurs de *iterables
ont été traitées.
"""
Quelle instruction permet de générer une nouvelle liste contenant chaque élément de la liste générée par l’application collatz(7) multiplié par 3 ?
Utiliser une fonction anonyme.
Remarque :map réalise aussi une évaluation paresseuse et ne retourne pas une liste mais un itérateur. Le résultat de l’application de map doit donc être passé comme argument à la fonction list : list(map(..., ...)).
Solution
list(map(lambdax:3*x,collatz(7)))
Quelle instruction permet de générer une nouvelle liste contenant chaque élément pair de la liste générée par l’application collatz(7) multiplié par 3 ?
Utiliser une fonction anonyme.
Solution
Les List Comprehensions, introduites en classe de première, permettent d’écrire en Python des instructions réalisant les mêmes opérations que filter et map de façon très efficace et lisible.
Écrire l’instruction qui permet de générer une nouvelle liste ne contenant que les éléments pairs de la liste générée par l’application collatz(7), à l’aide d’une List comprehension.
Solution
[nfornincollatz(7)ifn%2==0]
Écrire l’instruction qui permet de générer une nouvelle liste dont les termes sont le triple de chaque terme de la liste générée par l’application collatz(7), à l’aide d’une List comprehension.
Solution
[3*nfornincollatz(7)]
Écrire l’instruction qui permet de générer une nouvelle liste dont les termes sont le triple de chaque terme de la liste générée par l’application collatz(7) si ces termes sont pairs, à l’aide d’une List comprehension.
Solution
[3*nfornincollatz(7)ifn%2==0]
Quelques mots sur l’évaluation paresseuse (laziness)
La fonction collatz génère une liste de nombre. Ce comportement est acceptable tant que le nombre d’éléments de la liste est limité mais terriblement inefficace lorsque le nombre de termes devient très important puisque toute la structure doit être calculée et placée en mémoire avant toute autre opération.
On appelle évaluation paresseuse le mécanisme qui consiste à ne pas construire toute la structure dans un premier temps et à ensuite agir sur cette structure mais à agir sur les éléments au fur et à mesure de leur création.
L’iterateur le plus utilisé jusqu’à présent en cours est range :
>>>range(10)range(0,10)>>>list(range(10))[0,1,2,3,4,5,6,7,8,9]# on oblige l'itérateur à fournir toutes les valeurs
Le tri par insertion a été étudié en classe de 1ère. Dans ce document, après un rappel du cours de 1ère, nous allons implémenter une version récursive de cet algorithme et ensuite utiliser la possibilité que les fonctions en Python ont d’accepter des fonctions comme paramètres, afin de rendre plus générale et utile cette fonction de tri.
Tri du joueur de cartes
Le tri par insertion est un tri « naturel » souvent qualifié de « tri du joueur de carte ». Comment un joueur de carte fait-il pour trier les cartes ?
- Au début, la main gauche du joueur est vide et ses cartes sont posées sur la table.
- Le joueur prend alors sur la table les cartes, une par une avec sa main droite, pour les placer dans sa main gauche.
- Pour savoir où placer une carte dans son jeu, le joueur la compare avec chacune des cartes déjà présentes dans sa main gauche, *en examinant les cartes de la droite vers la gauche*.
- *À tout moment, les cartes tenues par la main gauche sont triées* ; ces cartes étaient, à l'origine, les cartes situées au sommet de la pile sur la table.
Tri par insertion
Avertissement
Une correction du code à développer ci-dessous se trouve
ici
Introduction
La méthode du tri par insertion est ilustré à
ici
, ou, de façon plus folklorique,
ici
.
Visualiser la première vidéo (s’arrêter au bout de 4min40). Essayer de bien comprendre la méthode.
Algorithme itératif
Le tri par insertion est efficace lorsqu’on cherche à trier un tableau contenant un petit nombre d’élements ou un tableau dans lequel les éléments sont déjà pratiquement triés.
Idée
À chaque étape du processus, le tableau est divisé en deux sous-tableaux : le premier (indices plus petits que l’indice courant) est trié, le second (indices plus grands que l’indice courant n’est pas encore trié). On cherche la place de l’élément courant (non encore trié) dans le tableau trié.
Le tri par insertion est basé sur l’utilisation de deux boucles imbriquées :
La première boucle, une boucle Pour, parcourt la liste des valeurs, de la deuxième à la dernière ;
La seconde boucle, une boucle TantQue, cherche à placer l’élément courant dans la première partie triée du tableau (indices inférieurs à l’indice courant).
Début
1.nb ⟵ len(tab)
2.Pour i variant de 1 à nb-1 Faire
3.clé ⟵ tab[i]
4.j ⟵ i - 1
5.TantQue j >= 0 et tab[j] > clé Faire
6.tab[j + 1] ⟵ tab[j]
7.j ⟵ j - 1
8.FinTantQue
9.tab[j + 1] ⟵ clé
10.FinPour Fin
Remarque. L’algorithme du tri par insertion est un algorithme de tri en place. La réorganisation du tableau ne nécessite pas la création d’un nouveau tableau, ce qui économise de la place en mémoire.
Faire tourner « à la main » l’algorithme lorsque la fonction reçoit le tableau tab = [5,2,4,6,1,3].
À quoi sert l’instruction, ligne 2 ?
Expliquer les conditions d’arrêt de la boucle while, ligne 5.
Implémenter la fonction en langage Python et la tester en l’appelant avec les arguments donnés à la question précédente.
Réponse
deftri(tab:List[int])->List[int]:"""
Implémentation du tri par insertion.
Algorithme itératif.
"""foriinrange(1,len(tab)):val=tab[i]j=i-1whiletab[j]>valandj>=0:tab[j+1]=tab[j]j=j-1tab[j+1]=valreturntab
Comment prouve-t-on, de façon générale, la terminaison d’un algorithme ?
Réponse
On définit un variant de boucle.
Est-il nécessaire de prouver la terminaison de la boucle externe de cet algorithme ? De la boucle interne ?
Réponse
La boucle externe est une boucle Pour. Il n’est donc pas nécessaire de prouver sa terminaison. Par contre la boucle interne est une boucle TantQue. Il faut donc prouver sa terminaison.
Démontrer la terminaison de cet algorithme.
Réponse
La fonction f définie par f(j)=j est-elle un variant de boucle ?
Première valeur de j : i−1, donc première valeur de f : f(j)=i−1>0 puisque i>1.
f est-elle décroissante ? fj+1−fj=j−1−j=−1, La fonction est bien décroissante.
Dernière valeur de j : −1, donc f(j)=−1.
f est une fonction positive, décroissante dont la dernière valeur est négative : c’est bien un variant de boucle. La boucle se termine.
Comment prouve-t-on, de façon générale, la correction d’un algorithme ?
Réponse
On recherche un invariant de boucle.
Définir un invariant de boucle et prouver que l’algorithme est correct.
Réponse
Invariant de boucle.
La question à se poser est : « Qu’est ce qui est constant à chaque étape de cet algorithme ? »
Au début de chaque itération de la boucle Pour externe le tableau tab[0, ... , i-1] est un tableau trié constitué des i plus petits éléments du tableau tab, dans l’ordre croissant.
Rappels.
Nous devons montrer trois choses, concernant un invariant de boucle :
Initialisation. Il est vrai avant la première itération de la boucle.
Conservation. S’il est vrai avant une itération de la boucle, il le reste avant l’itération suivante.
Terminaison. Une fois terminée la boucle, l’invariant fournit une propriété utile qui aide à montrer la validité de l’algorithme.
Si les deux premières propriétés sont vérifiées, alors l’invariant est vrai avant chaque itération de la boucle.
La troisième propriété est peut-être la plus importante : elle est utilisée pour prouver la validité de l’algorithme.
Démonstration de la correction de l’algorithme.
Initialisation.i=1, tab[0] est alors un tableau à un élément, trié de façon évidente.
Conservation. Par hypothèse, pour i compris entre 1 et nb-2, tab[0, ,i-1] est un tableau trié. Lors de l’itération i, on recherche le plus petit élément du tableau tab[i, ... ,nb-1] et on le place à la position d’indice i. À partir de l’hypothèse, cet élément est plus grand que n’importe quel élément du tableau tab[0, ,i-1] (sinon il appartiendrait déjà à ce tableau) ; le tableau tab[0, ... ,i] est donc trié.
Terminaison. Au début de la boucle dans laquelle i=nb-2, tab[0, ... ,nb-3] est un tableau trié. À l’issue de cette boucle, on a déterminé le plus petit élément entre tab[nb-2] et tab[nb-1] et on a placé correctement ces éléments ; le tableau tab[0, ... ,nb-1] est donc trié et l’algorithme est correct.
Déterminer la complexité de l’algorithme.
Réponse
Rappels.
Au chapitre précédent, la notion de complexité a été introduite. Nous allons rappeller, dans cette partie, quelques règles simples qui permettent de se faire une idée de l’efficacité d’un algorithme.
Une affectation ou l’évaluation d’une expression ont un temps d’exécution petit que l’on considère constant. Cette durée constitue souvent l’unité de base dans laquelle on mesure le temps d’exécution d’un algorithme.
Le temps pris pour exécuter une séquence d’instructions p puis q est la somme des temps pris pour exécuter les instructions p puis q.
Le temps pris pour exécuter un test Si (b) Alors p Sinon q FinSi est inférieur ou égal au maximum des temps pris pour exécuter les instructions p et q, plus une unité qui correspond au temps d’évaluation de l’expression b.
Le temps pris pour exécuter une boucle Pour i variant de 1 à m par pas de 1 Faire p FinPour est m fois le temps pris pour exécuter l’instruction p si ce temps ne dépend pas de la valeur de i.
En particulier, quand deux boucles sont imbriquées, le corps de la boucle interne est répété à cause de cette boucle, mais aussi parce qu’elle-même est répétée dans son intégralité. Ainsi, si les deux boucles sont répétées respectivement m et m’ fois, alors le corps de la boucle interne est exécuté m * m’ fois en tout.
Quand le temps d’exécution du corps de la boucle dépend de la valeur de l’indice i, le temps total d’exécution de la boucle est la somme des temps d’exécution du corps de la boucle pour chaque valeur de i.
Le cas des boucles Tantque est plus complexe puisque le nombre d’itérations n’est en général pas connu à priori.
On étudie seulement la complexité du pire et on se limite à l’influence des boucles. Si on note N le nombre d’élements dans le tableau,
pour i=0, la boucle interne effectue N−1 tours ;
pour i=1, la boucle interne effectue N−2 tours ;
pour i=3, la boucle interne effectue N−3 tours ;
pour i=N−3, la boucle interne effectue 2 tours ;
pour i=N−2, la boucle interne effectue 1 tour.
Finalement, il y a 1+2+…+(N−2)+(N−1)=∑k=1N−1k=2(N−1)∗N=2N2−2N. La complexité de l’algorithme est en O(N2).
Algorithme récursif
Algorithme 2
Fonction tri_rec
Déclaration Paramètre tab : tableau d’Entiers Paramètre i : Entier Variable nb : Entier
Début
1.nb ⟵ len(tab)
2.Si i == nb Alors
3.Retourner tab
4.Sinon
5.insere(tab, i)
6.Retourner tri_rec(tab, i + 1)
7.FinSi Fin
Début
1.Si i == 0 ou tab[i - 1] <= tab[i] Alors
2.Retourner tab[i]
3.Sinon
4.temp ⟵ tab[i - 1]
5.tab[i - 1] ⟵ tab[i]
6.tab[i] ⟵ temp
7.Retourner insere(tab, i - 1)
7.FinSi Fin
Décrire le fonctionnement de l’algorithme récursif avec soin lorsque la fonction reçoit le tableau tab = [5,2,4,6,1,3].
Implémenter en Python l’algorithme récursif.
Réponse
deftri_rec(tab:List[int],i:int=1)->List[int]:"""
Implémentation du tri par insertion
"""ifi==len(tab):returntabelse:insere(tab,i)returntri_rec(tab,i+1)definsere(tab:List[int],i:int)->List[int]:"""
Insère tab[i] dans le tableau tab[:i] déjà trié, récursivement.
"""ifi==0ortab[i-1]<=tab[i]:returntab[i]else:temp=tab[i-1]tab[i-1]=tab[i]tab[i]=tempreturninsere(tab,i-1)
Ajout d’une fonctionnalité au tri par insertion
Le tri par insertion, tel que nous l’avons implémenté, permet de trier des tableaux contenant tous les objets qui admettent < comme opérateur : int, float, str, … mais aussi tuple !!!
Vérifier que la fonction tri_rec est bien capable de trier la liste [(7, 8), (3, 4), (1, 2), (5, 6)].
Quel est le critère de tri ?
Comment doit-on modifier nos fonctions de tri pour qu’elles trient par ordre décroissant ? Pour qu’elles trient le second élément de tuples passés comme arguments ?
Exemple de problème à traiter : Trier la liste suivante par année de naissance (ordre croissant)
L’idée est de confier la relation d’ordre à une fonction auxiliaire que l’on passe comme argument à la fonction de tri.
Cette fonction auxiliaire doit être un prédicat.
Modifier les fonction tri-rec et insere de façon à ce qu’elles admettent la fonction inf comme argument. La fonction inf est responsable de la relation d’ordre lors du tri.
Réponse
deftri_g(inf:Callable,tab:List[int],i:int=1)->List[int]:"""
Implémentation d'un algorithme générique de tri par insertion.
Algorithme récursif.
"""ifi==len(tab):returntabelse:insere_g(inf,tab,i)returntri_g(inf,tab,i+1)definsere_g(inf:Callable,tab:List[int],i:int)->List[int]:"""
Insère tab[i] dans le tableau tab[:i] déjà trié, récursivement.
"""ifi==0orinf(tab[i],tab[i-1]):returntab[i]else:temp=tab[i-1]tab[i-1]=tab[i]tab[i]=tempreturninsere_g(inf,tab,i-1)
Écrire une fonction inf qui permet de trier un tableau d’entiers par ordre croissant.
Réponse
definfe(x,y):"""
Relation d'ordre générique.
Pas vraiment possible de donner les types.
"""returny<=x
Modifier la fonction inf de façon à ce que le tableau soit trié par ordre décroissant.


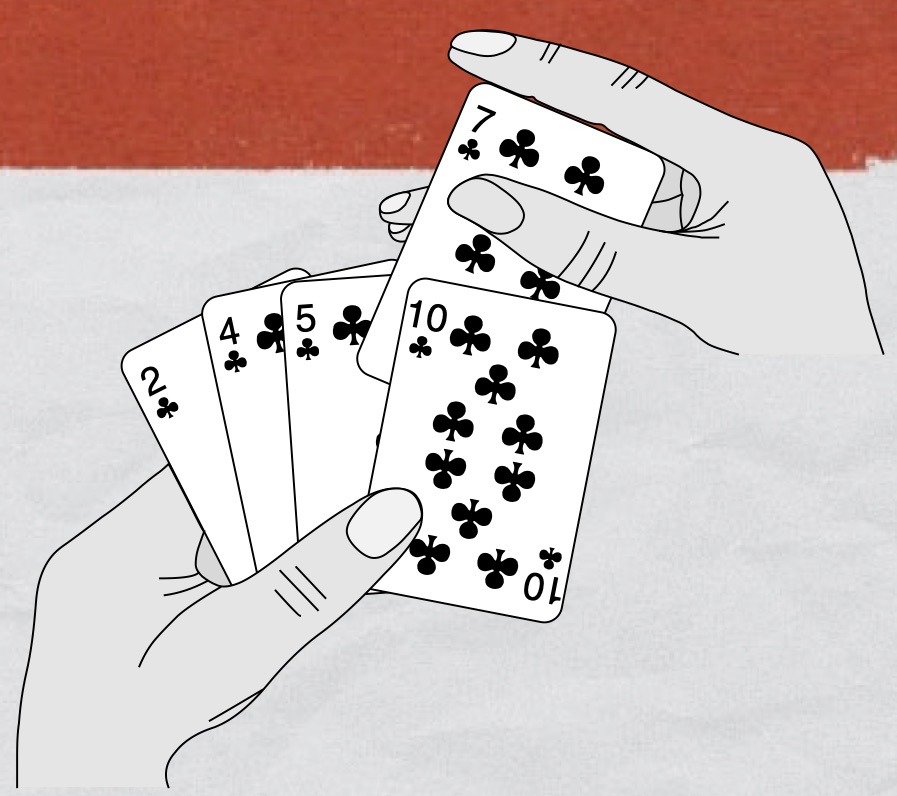 Le tri par insertion est un tri « naturel » souvent qualifié de « tri du joueur de carte ». Comment un joueur de carte fait-il pour trier les cartes ?
- Au début, la main gauche du joueur est vide et ses cartes sont posées sur la table.
- Le joueur prend alors sur la table les cartes, une par une avec sa main droite, pour les placer dans sa main gauche.
- Pour savoir où placer une carte dans son jeu, le joueur la compare avec chacune des cartes déjà présentes dans sa main gauche, *en examinant les cartes de la droite vers la gauche*.
- *À tout moment, les cartes tenues par la main gauche sont triées* ; ces cartes étaient, à l'origine, les cartes situées au sommet de la pile sur la table.
