Physique, Chimie et Informatique > Terminales Spé. NSI
Bases de données
Le développement des traitements informatiques nécessite la manipulation de données de plus en plus nombreuses. Leur organisation et leur stockage constituent un enjeu essentiel de performance. Le recours aux bases de données relationnelles est aujourd’hui une solution très répandue. Ces bases de données permettent d’organiser, de stocker, de mettre à jour et d’interroger des données structurées volumineuses utilisées simultanément par différents programmes ou différents utilisateurs. Cela est impossible avec les représentations tabulaires étudiées en classe de première.
Des systèmes de gestion de bases de données (SGBD) de très grande taille (de l’ordre du pétaoctet) sont au centre de nombreux dispositifs de collecte, de stockage et de production d’informations. L’accès aux données d’une base de données relationnelle s’effectue grâce à des requêtes d’interrogation et de mise à jour qui peuvent par exemple être rédigées dans le langage SQL (Structured Query Language). Les traitements peuvent conjuguer le recours au langage SQL et à un langage de programmation.
Il convient de sensibiliser les élèves à un usage critique et responsable des données.
- Identifier les concepts définissant le modèle relationnel.
- Ces concepts permettent d’exprimer les contraintes d’intégrité (domaine, relation et référence).
- Base de données relationnelle.
- Savoir distinguer la structure d’une base de données de son contenu. Repérer des anomalies dans le schéma d’une base de données.
- La structure est un ensemble de schémas relationnels qui respecte les contraintes du modèle relationnel. - Les anomalies peuvent être des redondances de données ou des anomalies d’insertion, de suppression, de mise à jour. - On privilégie la manipulation de données nombreuses et réalistes.
- Système de gestion de bases de données relationnelles.
- Identifier les services rendus par un système de gestion de bases de données relationnelles : persistance des données, gestion des accès concurrents, efficacité de traitement des requêtes, sécurisation des accès.
- Il s’agit de comprendre le rôle et les enjeux des différents services sans en détailler le fonctionnement.
- Langage SQL : requêtes d’interrogation et de mise à jour d’une base de données.
- Identifier les composants d’une requête. - Construire des requêtes d’interrogation à l’aide des clauses du langage SQL : SELECT, FROM, WHERE, JOIN. - Construire des requêtes d’insertion et de mise à jour à l’aide de : UPDATE, INSERT, DELETE.
- On peut utiliser DISTINCT, ORDER BY ou les fonctions d’agrégation sans utiliser les clauses GROUP BY et HAVING.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Introduction aux bases de données
Qu’est-ce qu’une base de données ?
Le nombre d’informations disponibles et les moyen de les diffuser sont en constante progression. La croissance du Web a encore accru ce développement en fournissant l’accès à des bases de données gigantesques et très diverses par l’intermédiaire d’une interface commune (Amazon, Google, Facebook, ...).
Notion de base de données
Tout le monde a une idée naturelle de ce que peut être une base de donnée, nous stockons, sur nos disques durs, non seulement des fichiers musicaux, mais aussi des informations relatives à ces derniers : noms des
artistes, des albums, dates d’enregistrements, noms et numéros des morceaux, parfois noms des musiciens, ...
On remarque qu’une caractéristique des données contenues dans une base de données est qu’elles doivent posséder un lien entre elles. En effet, des données choisies au hasard ne peuvent clairement pas constituer une base de données. Une base de données est donc une représentation partielle et (très) simplifiée du monde réel, obtenue par un processus de modélisation.
À retenir
Une base de données est un ensemble d’informations
structurées et organisées, mémorisées sur un support permanent.
Info
La définition d’une base de données n’indique pas comment sont stockées les informations, une organisation consistant en l’utilisation de
fichiers pourrait tout à fait convenir. Cependant, bien que simple à mettre en œuvre, cette solution pose de nombreux problèmes :
Lourdeur d’accès aux données
En pratique, pour chaque accès aux données (lecture ou écriture), il faut écrire un programme.
Manque de sécurité
Si tout programmeur peut accéder aux données, il est impossible d’assurer leur intégrité.
Pas de contrôle de concurrence
Si plusieurs utilisateurs accèdent au mêmes fichiers, en même temps, des problèmes de concurrence d’accès se posent : quelle modification sera retenue ? quelle valeur sera lue ?
Pour manipuler une base de données, on utilise donc généralement un logiciel spécialisé : un SGBD (Système de Gestion de Bases de Données)[^2].
À retenir
On appelle SGBD (Système de Gestion de Bases de
Données) un logiciel complexe, de haut niveau, qui permet de manipuler les informations stockées dans une base de données.
À retenir
On appelle « Système d’information » l’ensemble
composé par les bases de données et le SGBD.
Utilisation d’une base de données
La création d’une base de données s’effectue avec un objectif : elle doit permettre de retrouver de l’information par son contenu en se fondant sur des critères de recherche. Par exemple, en 1959, dans
quels morceaux et quel(s) album(s) de Miles Davis apparaît John Coltrane ?
Info
La grande différence entre une base de données et un programme écrit pour lire des information dans des fichiers, est qu’une base de donnée doit permettre de répondre à des questions auxquelles ses concepteurs
n’avaient pas forcément pensé.
À retenir
Une base de données doit permettre d’assurer
l’indépendance entre les données et leur traitement.
Pour réaliser l’indépendance annoncée dans la définition précédente, on associe à la base de données une description que l’on appelle métadonnée (ou catalogue). Cette description décrit la structure
interne de la base de données[^3]. En plus de la structure et du type des données, on stocke également à cet endroit les informations concernant les règles de cohérence des données (cf. section suivante sur la qualité d’une base de données).
NumCD
Titre
Interprète
Label
Année
1
Bring On the Night
Sting
1986
3
Superstition
Stevie Wonder
Motown
1972
2
Paranoid Android
Radiohead
Parlophone
1997
Extrait d’une base de données pour une collection de CD musicaux.
Dans l’exemple donné dans le Tableau 1., en plus des informations, la base de données contiendrait les métadonnées suivantes :
« NumCD » est un nombre entier supérieur à 1 ;
« Titre » est une chaîne de caractères de taille 50 ;
« Interprète » est une chaîne de caractères de taille 30 ;
« Label » est une chaîne de caractères de taille 20 ;
« Année » est un nombre entier supérieur à 1900 et inférieur à l’année en cours.
Remarque
On note que tous les « champs » ne sont pas forcément renseignés dans l’exemple donné.
À retenir
On doit donc retenir que l’utilisateur ou l’application utilisatrice du système d’information ne doit pas avoir connaissance de la structure interne de ce dernier pour l’interroger, on réalise une abstraction des données. C’est la raison pour laquelle on utilise une description des données sous la forme d’un modèle pour permettre une restitution la plus efficace possible de l’information.
Qualité d’une base de données
Info
L’un des objectifs de création d’une base de données est de pouvoir retrouver les données par leur contenu. Il faut donc s’assurer que ces dernières sont de « bonne qualité ».
Cohérence des données contenues dans la base
Par exemple, si un champ doit contenir la qualité d’une personne sous la forme « Monsieur », « Madame », « Mademoiselle », l’entrée de « M. » doit être impossible de façon à ne pas induire des erreurs de recherche sur ce Champ.
Absence de redondance
Dans un carnet d’adresses le stockage du nom de la ville et du code postal pour chaque personne représente une redondance : la même information est stockée plusieurs fois, ce qui consomme de la place inutilement.
Le modèle relationnel des données s’accompagne d’outils qui permettent de détecter, dans une certaine mesure, les problèmes présentés dans cette section.
Modèles de données
À retenir
Les modèles de données correspondent à la manière
de structurer l’information dans une base de données.
Ces modèles reposent sur des recherches initiées à partir des années 1960. Parmi tous les modèles développés et utilisés, on ne présentera ici (très succinctement) que deux modèles : le modèle hiérarchique et le modèle relationnel.
Modèle hiérarchique
Avertissement
Ce modèle n’est présenté ici qu’à des fins historiques. Il n’est pas au programme.
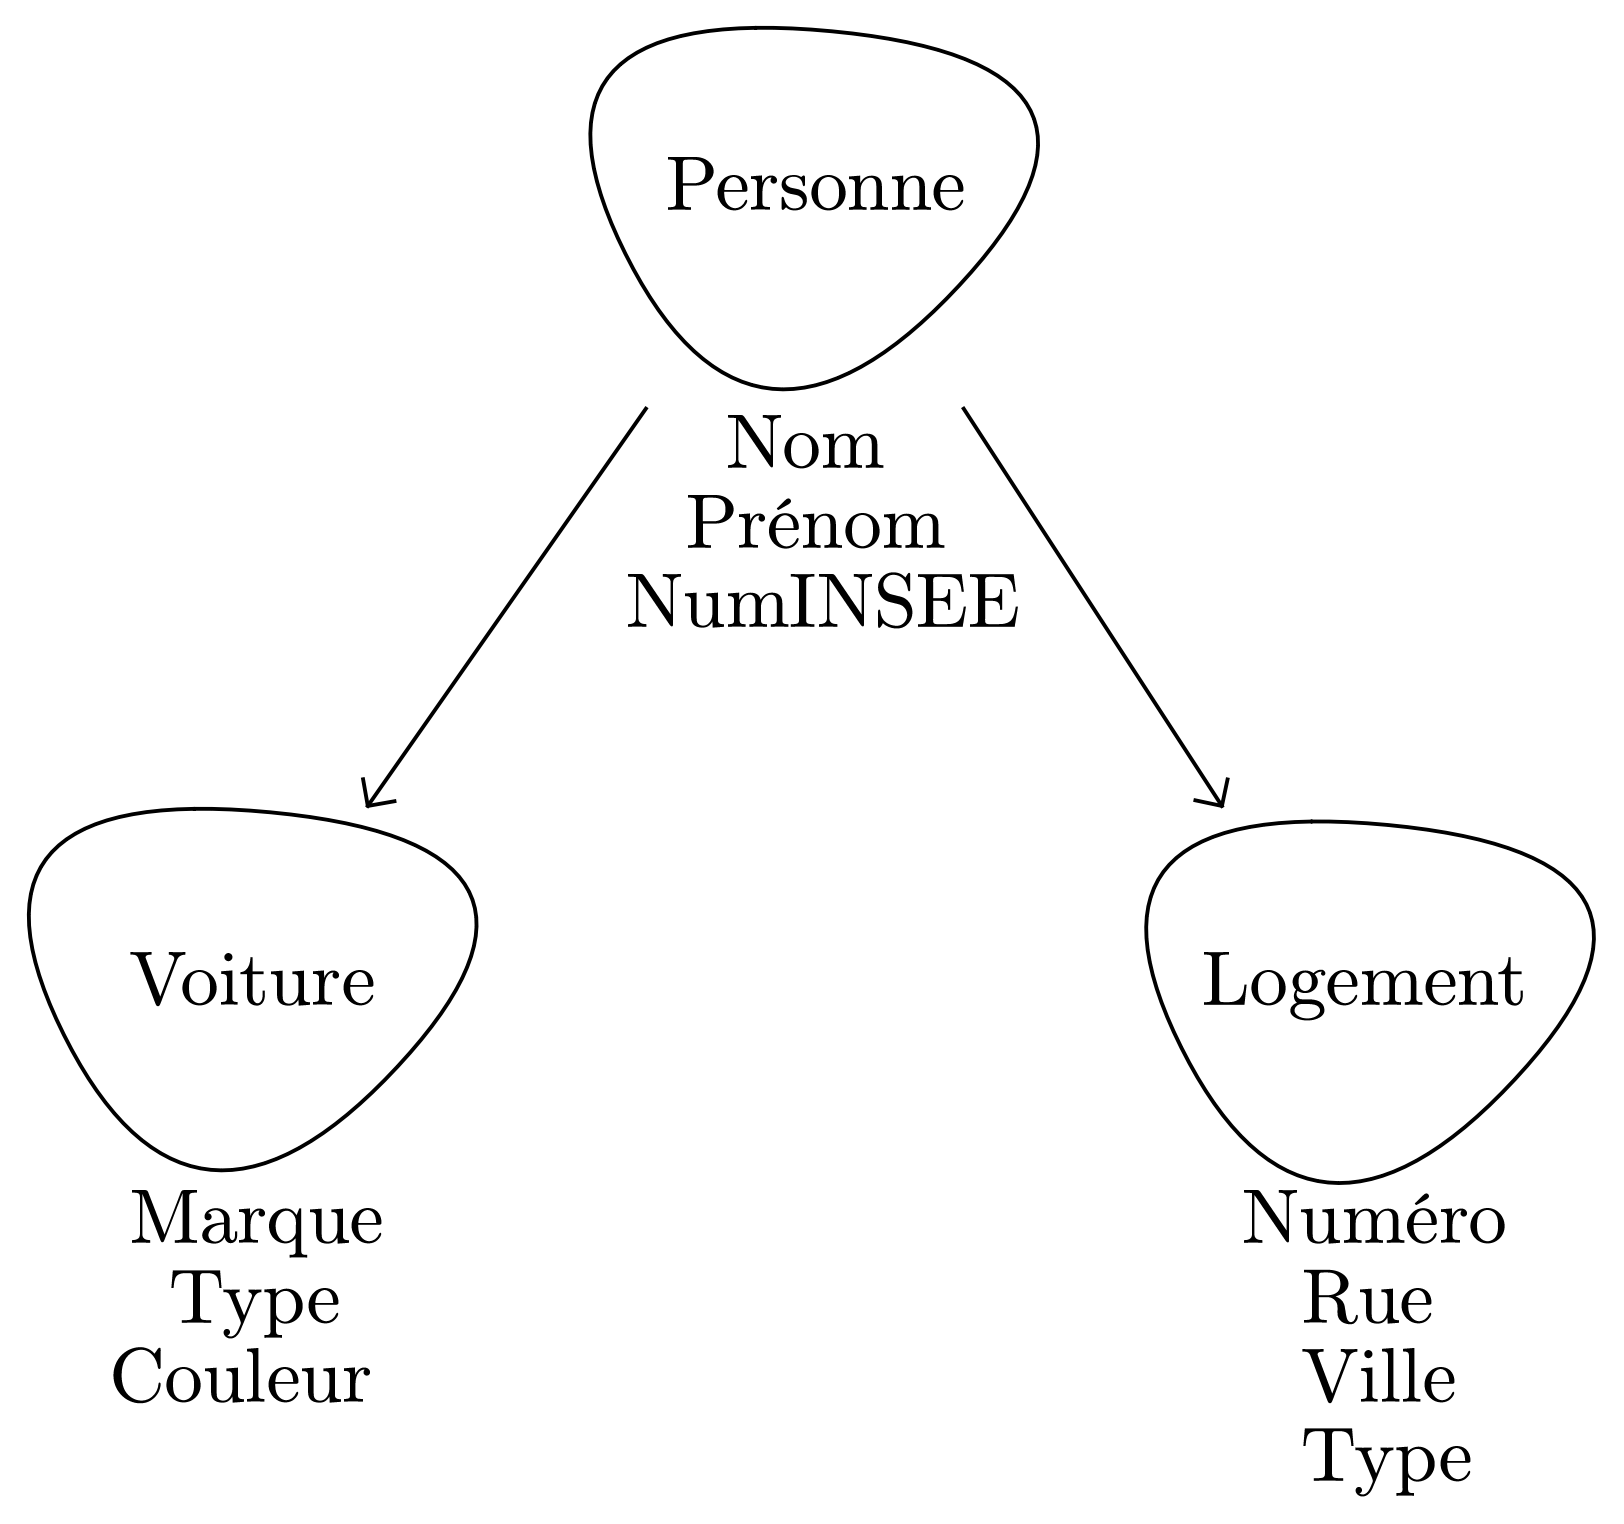
Ce modèle est l’un des plus anciens modèles. À l’époque de sa définition, le traitement de l’information était encore très lié à l’organisation des fichiers sur une machine. Les modèles conceptuels des données étaient donc des graphes ou des arbres.
Le modèle « hiérarchique » propose donc une classification arborescente des données, à la manière d’une classification scientifique. Dans ce modèle, chaque enregistrement n’a qu’un seul possesseur, ce qui limite les modélisations de la réalité possibles.
Des SGBD de type « hiérarchique » ou « réseau » (extension du modèle précédent permettant des relations transversales) sont toujours utilisés, pour des raisons d’efficacité, lorsque la structure de données s’y prête.
Le système d’exploitation Windows utilise « une base de registre » pour stocker tous les paramètres de configuration (système et logiciels). Le modèle de données choisi est le modèle « hiérarchique ».
La donnée Favoris, par exemple, a pour chemin : HKEY_CURRENT_USER\Software\Microsoft\Windows\CurrentVersion\Applets\Regedit\Favorite (on peut accéder à cette donnée grâce au logiciel Regedit).
Modèle relationnel
Ce modèle a été proposé en 1970 par E. F. Codd dans un article resté célèbre : « A Relational Model of Data for Large Shared Data Banks ». Il cherchait à créer un langage d’interrogation de bases de données plus
proche du langage naturel. Dans cette optique, il a fondé sa recherche sur des concepts mathématiques rigoureux, tels que la théorie des ensembles et la logique du premier ordre.
Info
Le modèle « relationnel » permet de modéliser les informations contenues dans les bases de données en utilisant des relations, c’est à dire un ensemble d’attributs.
Présentation du modèle relationnel
Qu’est-ce qu’une relation ?
À retenir
On appelle relation unobjet de la vie réelleauquel on attache un ensemble d’attributs.
Par exemple, un employé possède un nom, un prénom, un matricule, travaille dans un service et a été embauché à une certaine date.
Chaque instance d’une relation est appelée un tuple ou n-uplet (en français).
Les relations sont d’ordinaire représentées sous la forme de tables à deux dimensions, et on confond les deux concepts. On confond de même ligne dans la table et tuple.
Par définition, chaque tuple d’une relation est unique, et est identifié par un attribut ou une combinaison de plusieurs attributs qui forme la clef primaire.
L’ordre des tuples dans la relation n’est pas significatif.
Le nombre de champs de la relation s’appelle le degré de la relation tandis que le nombre de tuples dans la relation s’appelle la cardinalité de la relation.
Exemple
Base de données formée par deux relations.
Titre
Directeur
Acteur
Casablanca
M. Curtiz
Humphrey Bogart
Casablanca
M. Curtiz
Peter Lore
Les 400 coups
F. Truffaut
J.-P. Leaud
Star Wars
G. Lucas
Harrison Ford
Relation Film
Titre
Salle
Heure
Casablanca
Lucernaire
19:00
Casablanca
Studio
20:00
Les 400 coups
Sel
20:30
Star Wars
Sel
22:15
Relation Séance
Quelle est la cardinalité de la relation Film ?
Réponse
La cardinalité d’une relation est le nombre de tuples (ou de lignes) qu’elle renferme. Ici la cardinalité est égale à 4.
Quel est le degré de la relation Séance ?
Réponse
Le degré d’une relation est le nombre de champs qui la définissent. Ici, c’est 3.
Quels sont les attributs (champs) de la relation Film ?
Réponse
Les attributs de la relation Film sont : Titre, Directeur, Acteur.
Indiquer un tuple de la relation Séance.
Réponse
LA cardinatlité de la relation étant égale à 4, on a le choix entre 4 réponses. (Casablanca, Lucernaire, 19:00) fait partie de ces réponses possibles.
Qu’est-ce que le calcul relationnel ?
Info
On accède aux données en utilisant comme langage le calcul relationnel. Le calcul relationnel (très fortement inspiré de la logique du premier ordre en mathématique) s’appuie sur des variables, des prédicats, des connecteurs logiques (Et, Ou, Implique, ...) et des quantificateurs existentiels (Il existe, Pour tout, ...).
Exemple
Existe-t-il un film ayant pour acteur Humphrey Bogart diffusé au cinéma Studio ?
Existe-t-il au moins un film de M. Curtiz projeté au cinéma Sel ?
F. Truffaut a-t-il fait tourner l’acteur Harrison Ford ?
Qu’est-ce qu’une vue ?
Les relations constituant la base de données sont complétées à l’aide de vues :
À retenir
Une vue est une relation, qui au lieu d’être
stockée dans la base de données, est le résultat d’une requête.
Une vue peut ensuite être réutilisée exactement comme s’il s’agissait d’une relation stockée dans la base de données.
Quelles sont les films, les salles et les horaires des séances dans lesquels on peut trouver l’acteur Humphrey Bogart ?
Réponse
La réponse à cette requête est une vue :
Casablanca
Lucernaire
19:00
Casablanca
Studio
20:00
Qu’est-ce que le langage SQL ?
Toujours dans le cadre de sa recherche, Codd a mis au point, en même temps que le modèle de données relationnel, un langage d’interrogation des données SEQUEL, qui est par la suite devenu SQL (Structured Query Language). La normalisation du langage SQL, dès 1986 par l’ANSI (institut de normalisation américain), puis par l’ISO (organisation internationale de la normalisation) a assuré, pour une grande partie, le
succès du modèle relationnel. Les requêtes écrites pour un SGBD fonctionnent en général sans trop de modifications avec un autre SGBD.
Exemple
Traduction en langage SQL de l’interrogation de la question 5.
Les SGBD sont des systèmes complexes qu’il n’est pas question de décrire en détail.
Rendre efficace la recherche d’une information dans un fichier informatique n’est pas simple
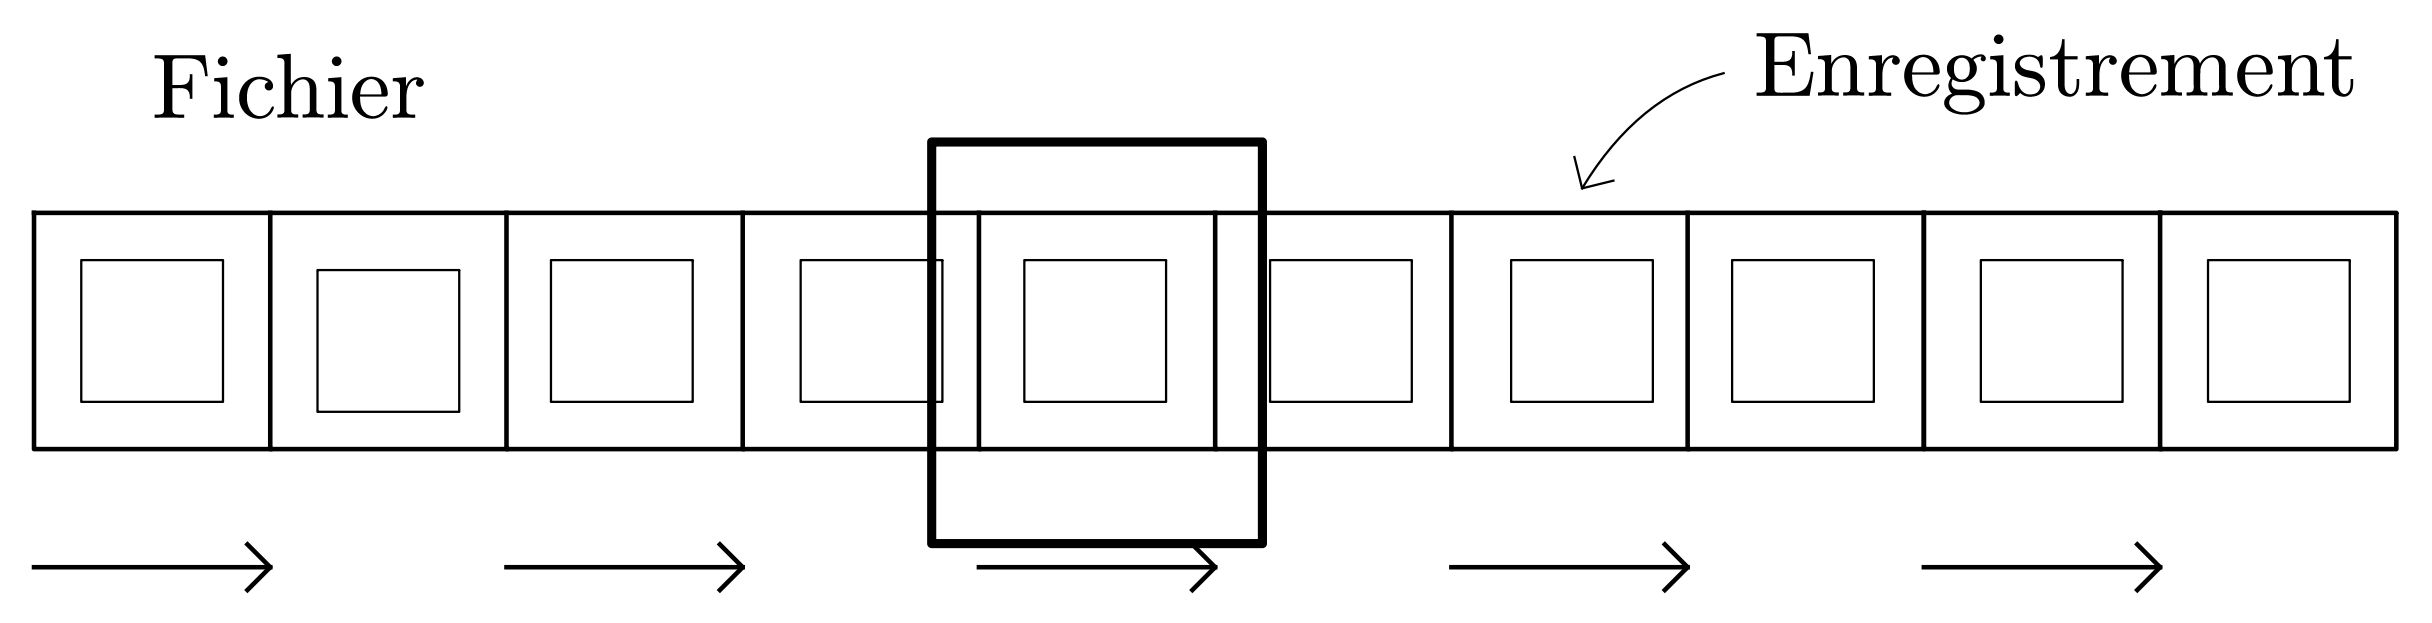
Comme on l’a déjà vu cette année, lorsqu’on utilise un fichier pour stocker de l’information, il est nécessaire de prévoir un découpage de celui-ci par enregistrements, souvent de taille fixe.
Pour passer d’un enregistrement à l’autre, il faut alors avancer la « tête de lecture » de la taille d’un enregistrement.
Info
Dans une base de données, on recherche les données par leur contenu. Pour retrouver l’une d’entre elles, il faut donc parcourir tous les enregistrements un à un (recherche séquentielle) et en examiner le contenu, ce qui est relativement peu efficace.
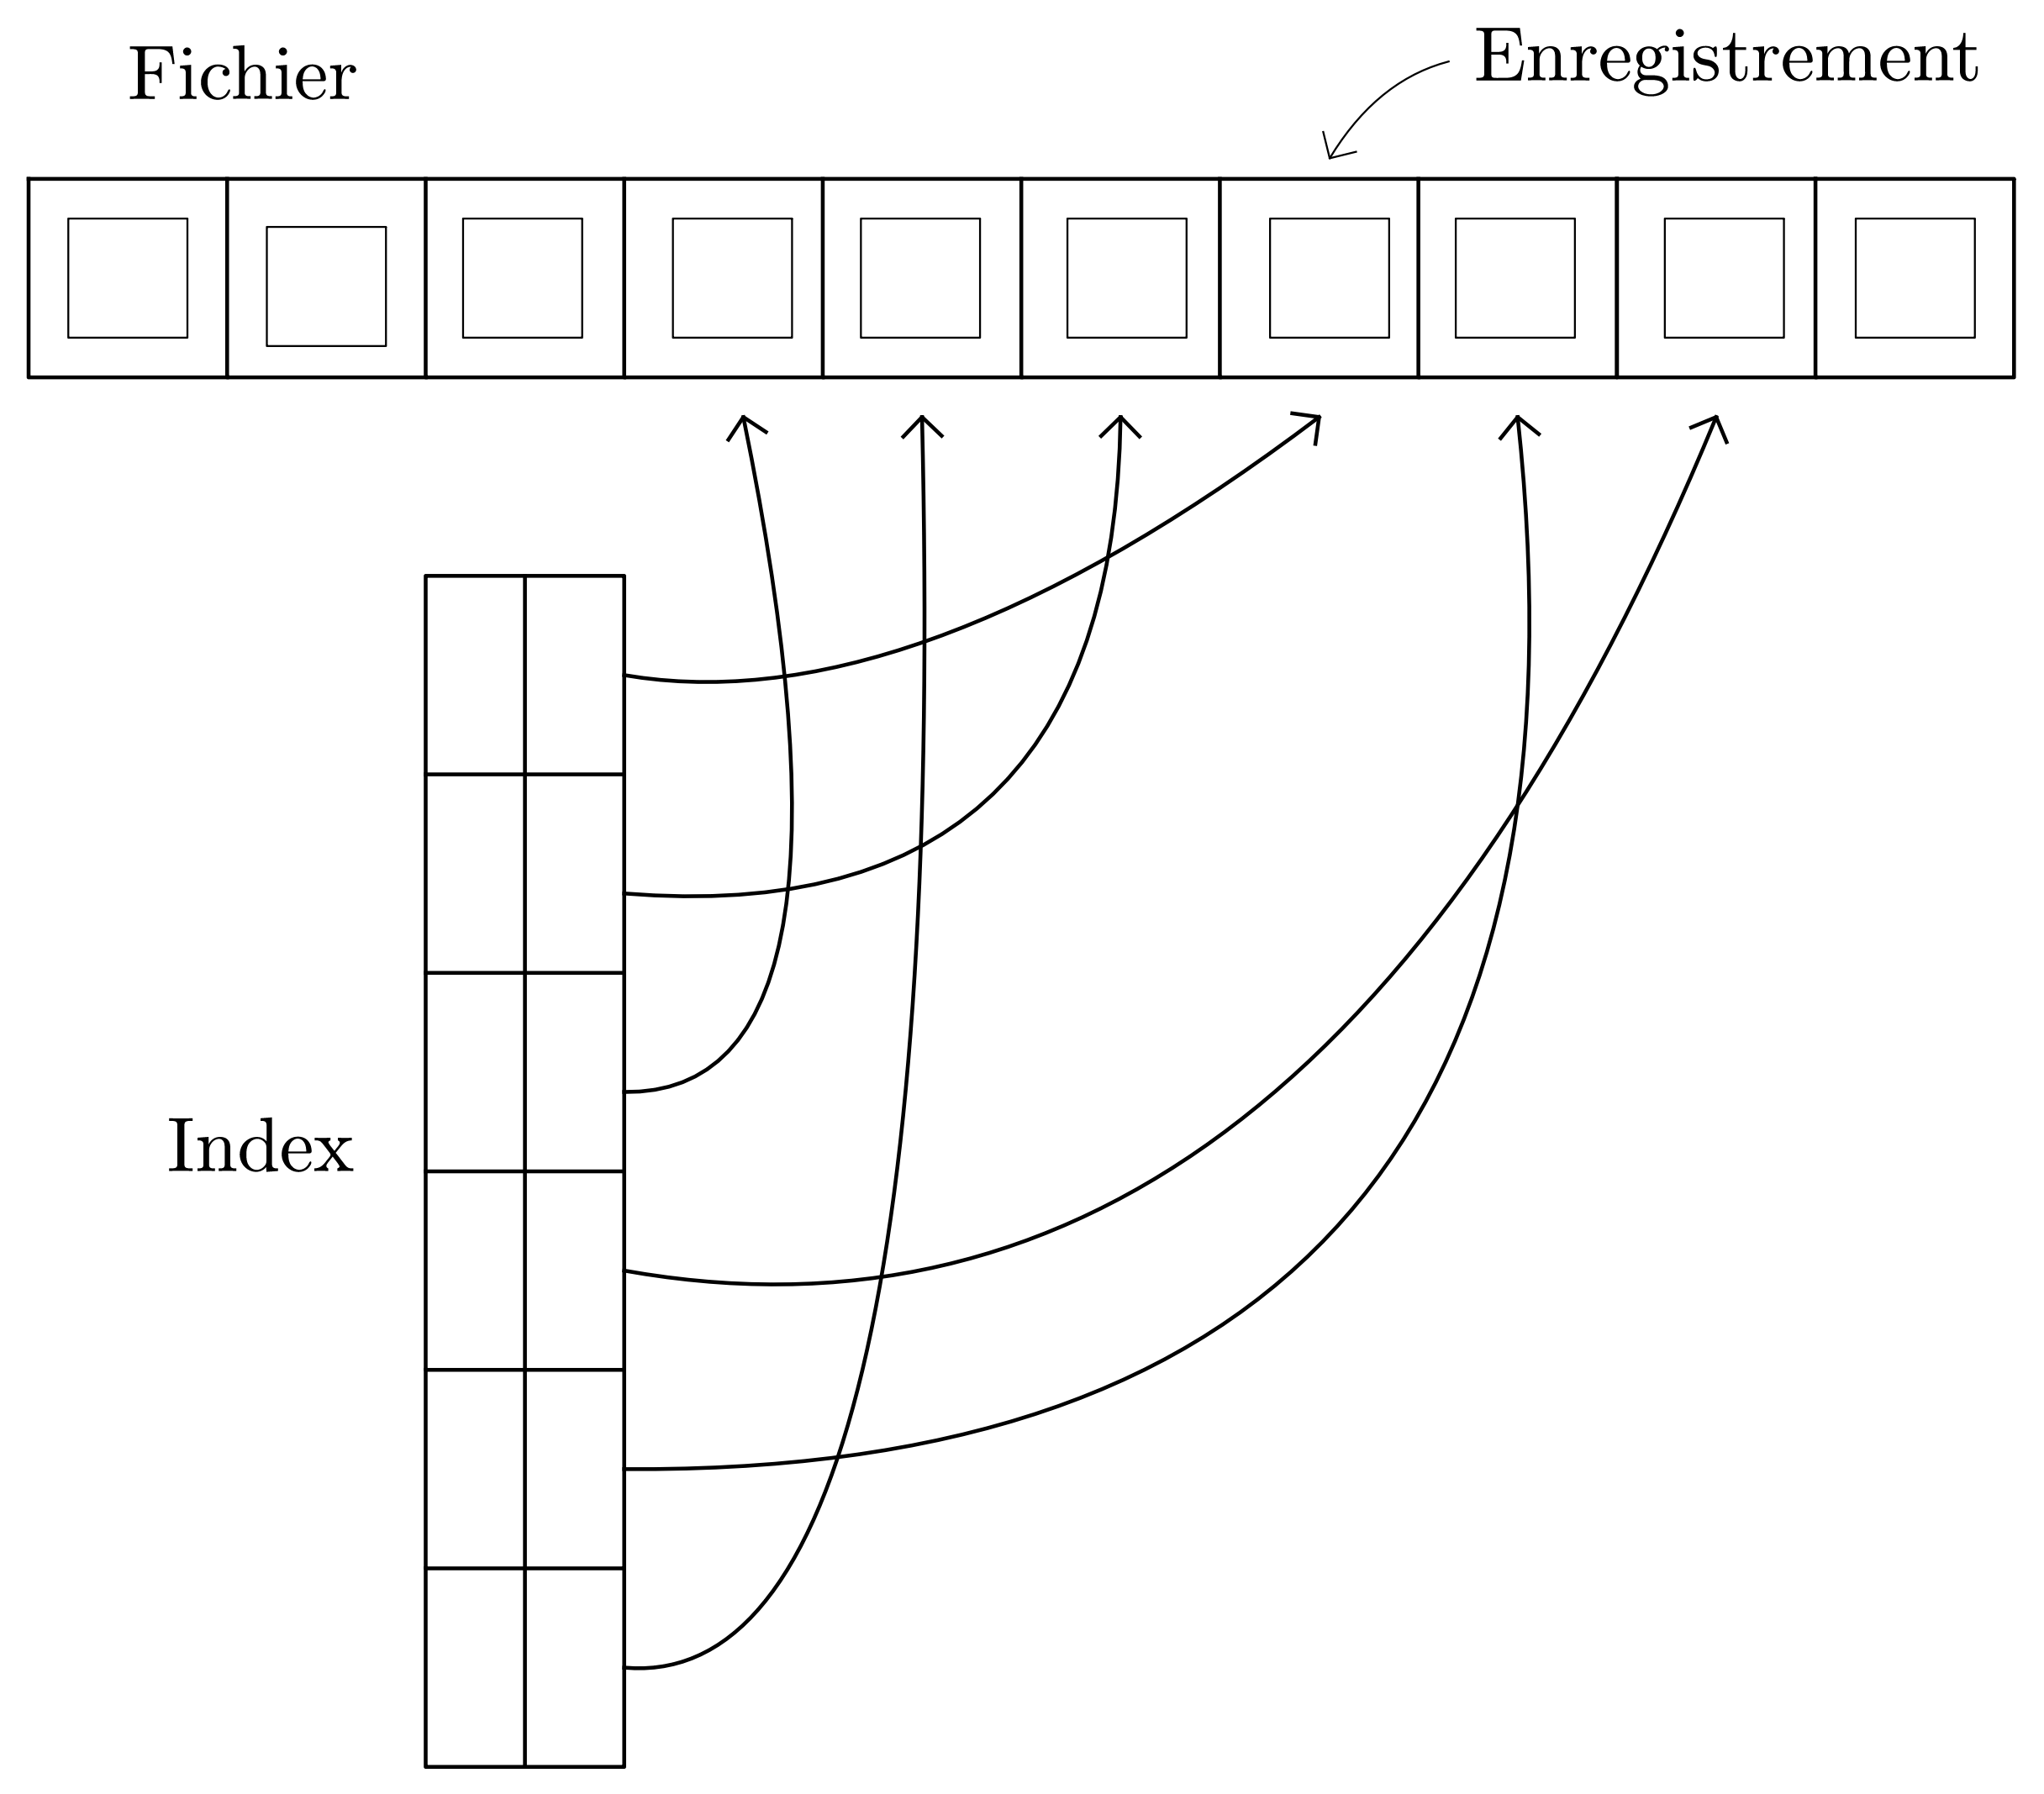
Une alternative à ce parcours séquentiel est la construction de tables descriptives afin d’accélérer l’accès aux données :
Une première table permet l’accès direct à un enregistrement par une « clé » associée à l’adresse mémoire de l’enregistrement.
Une seconde table contient l’ordre relatif des enregistrements ordonnés suivant les valeurs d’un champ : on appelle cette table un index. Cette seconde table permet d’employer des méthodes de recherche par le contenu du champ indexé beaucoup plus performantes. La recherche dichotomique est l’une d’entre elles.
On voit, à travers ce simple exemple de recherche du contenu d’un enregistrement, qu’un SGBD doit implémenter des algorithmes sophistiqués.
Fonctionnalités d’un SGBD
Pour concevoir et organiser les fonctionnalités d’un SGBD on peut s’appuyer sur un modèle en trois-couches dont l’objectif est d’obtenir, une indépendance entre les données et les traitements :
Info
Niveau interne ou physique
C’est le niveau le plus proche du matériel. À ce niveau, on gère :
le stockage dans les fichiers des données, du schéma, des index, ... ;
le partage des données et la gestion de la concurrence d’accès ;
la reprise sur panne (fiabilité) ;
la distribution des données et l’interopérabilité (accès aux réseaux).
Niveau conceptuel ou logique
À ce niveau, on :
définit la structure des données : Langage de Description des Données (LDD) ;
définit comment les données peuvent être consultées et mises à jour : Langage de Requêtes (LR) et Langage de Manipulation des Données (LMD) ;
gère la confidentialité (sécurité, droits d’accès aux données à travers le réseau, ...) ;
maintient l’intégrité des données.
Niveau externe
Le niveau externe sert à décrire les « vues » des utilisateurs, c’est à dire le schéma de visualisation des données, qui est différent pour chaque catégorie d’utilisateur. C’est à ce niveau qu’on retrouve le langage SQL.
Ce découpage permet de modifier un sous-niveau sans toucher aux deux autres.
Transactions
À retenir
On appelle transaction toute opération de
modification des données dans la base de données.
À retenir
Une transaction relationnelle garantit qu’une
séquence d’opérations se réalise correctement, par exemple en empêchant qu’une somme d’argent ne s’évanouisse dans la nature (avec un compte en
banque débité sans qu’un autre ne soit crédité). Même une panne ne doit pas pouvoir conduire à une exécution incorrecte.
Info
Les transactions doivent posséder les propriétés suivantes :
Atomicité
Une transaction est effectuée en totalité ou abandonnée.
Cohérence
Une transaction doit s’effectuer d’un état cohérent de la base vers un autre état cohérent.
Isolement
Des transactions différentes ne doivent pas interférer.
Durabilité
La transaction a des effets permanents, même en cas de panne.
Architectures
Info
Architecture à deux niveaux Client/Serveur
L’architecture à deux niveaux, appelée architecture 2-tiers
(tier signifie niveau, étage en anglais), caractérise les systèmes Clients/Serveurs dans lesquels le client demande une ressource que le serveur fournit directement.
La relation est donc directe entre le serveur et le client.
Architecture à trois niveaux
Dans l’architecture à 3 niveaux, appelée architecture 3-tiers,
il existe un niveau intermédiaire, c’est-à-dire que l’on a généralement une architecture partagée entre :
Le client, qui demande les ressources ;
Le serveur d’application (Middleware), qui reçoit les demandes, interroge le serveur et retourne les réponses (après avoir éventuellement effectué un traitement) ;
Le serveur secondaire (généralement le SGBD), qui répond aux requêtes du serveur d’application.
Dans l’architecture à 3 niveaux, chaque serveur (niveaux 1 et 2) ffectue une tâche (un service) spécialisée. Ainsi, un serveur peut utiliser les services d’un ou plusieurs autres serveurs afin de fournir son propre service. Par conséquent, l’architecture à trois niveaux est potentiellement une architecture à N niveaux.
Comparaison des deux types d’architectures
L’architecture à deux niveaux est donc une architecture Client/Serveur dans laquelle le serveur est polyvalent, c’est-à-dire qu’il est capable de fournir directement l’ensemble des ressources demandées par le client.
Dans l’architecture à trois niveaux par contre, les applications au niveau serveur sont délocalisées, c’est-à-dire que chaque serveur est spécialisé dans une tâche (serveur web et serveur de base de données par
exemple).
Info
Ainsi, l’architecture à trois niveaux permet :
une plus grande flexibilité/souplesse ;
une plus grande sécurité (la sécurité peut être définie au niveau de chaque service) ;
de meilleures performances (les tâches sont partagées).
Étapes de la conception de bases de données
Info
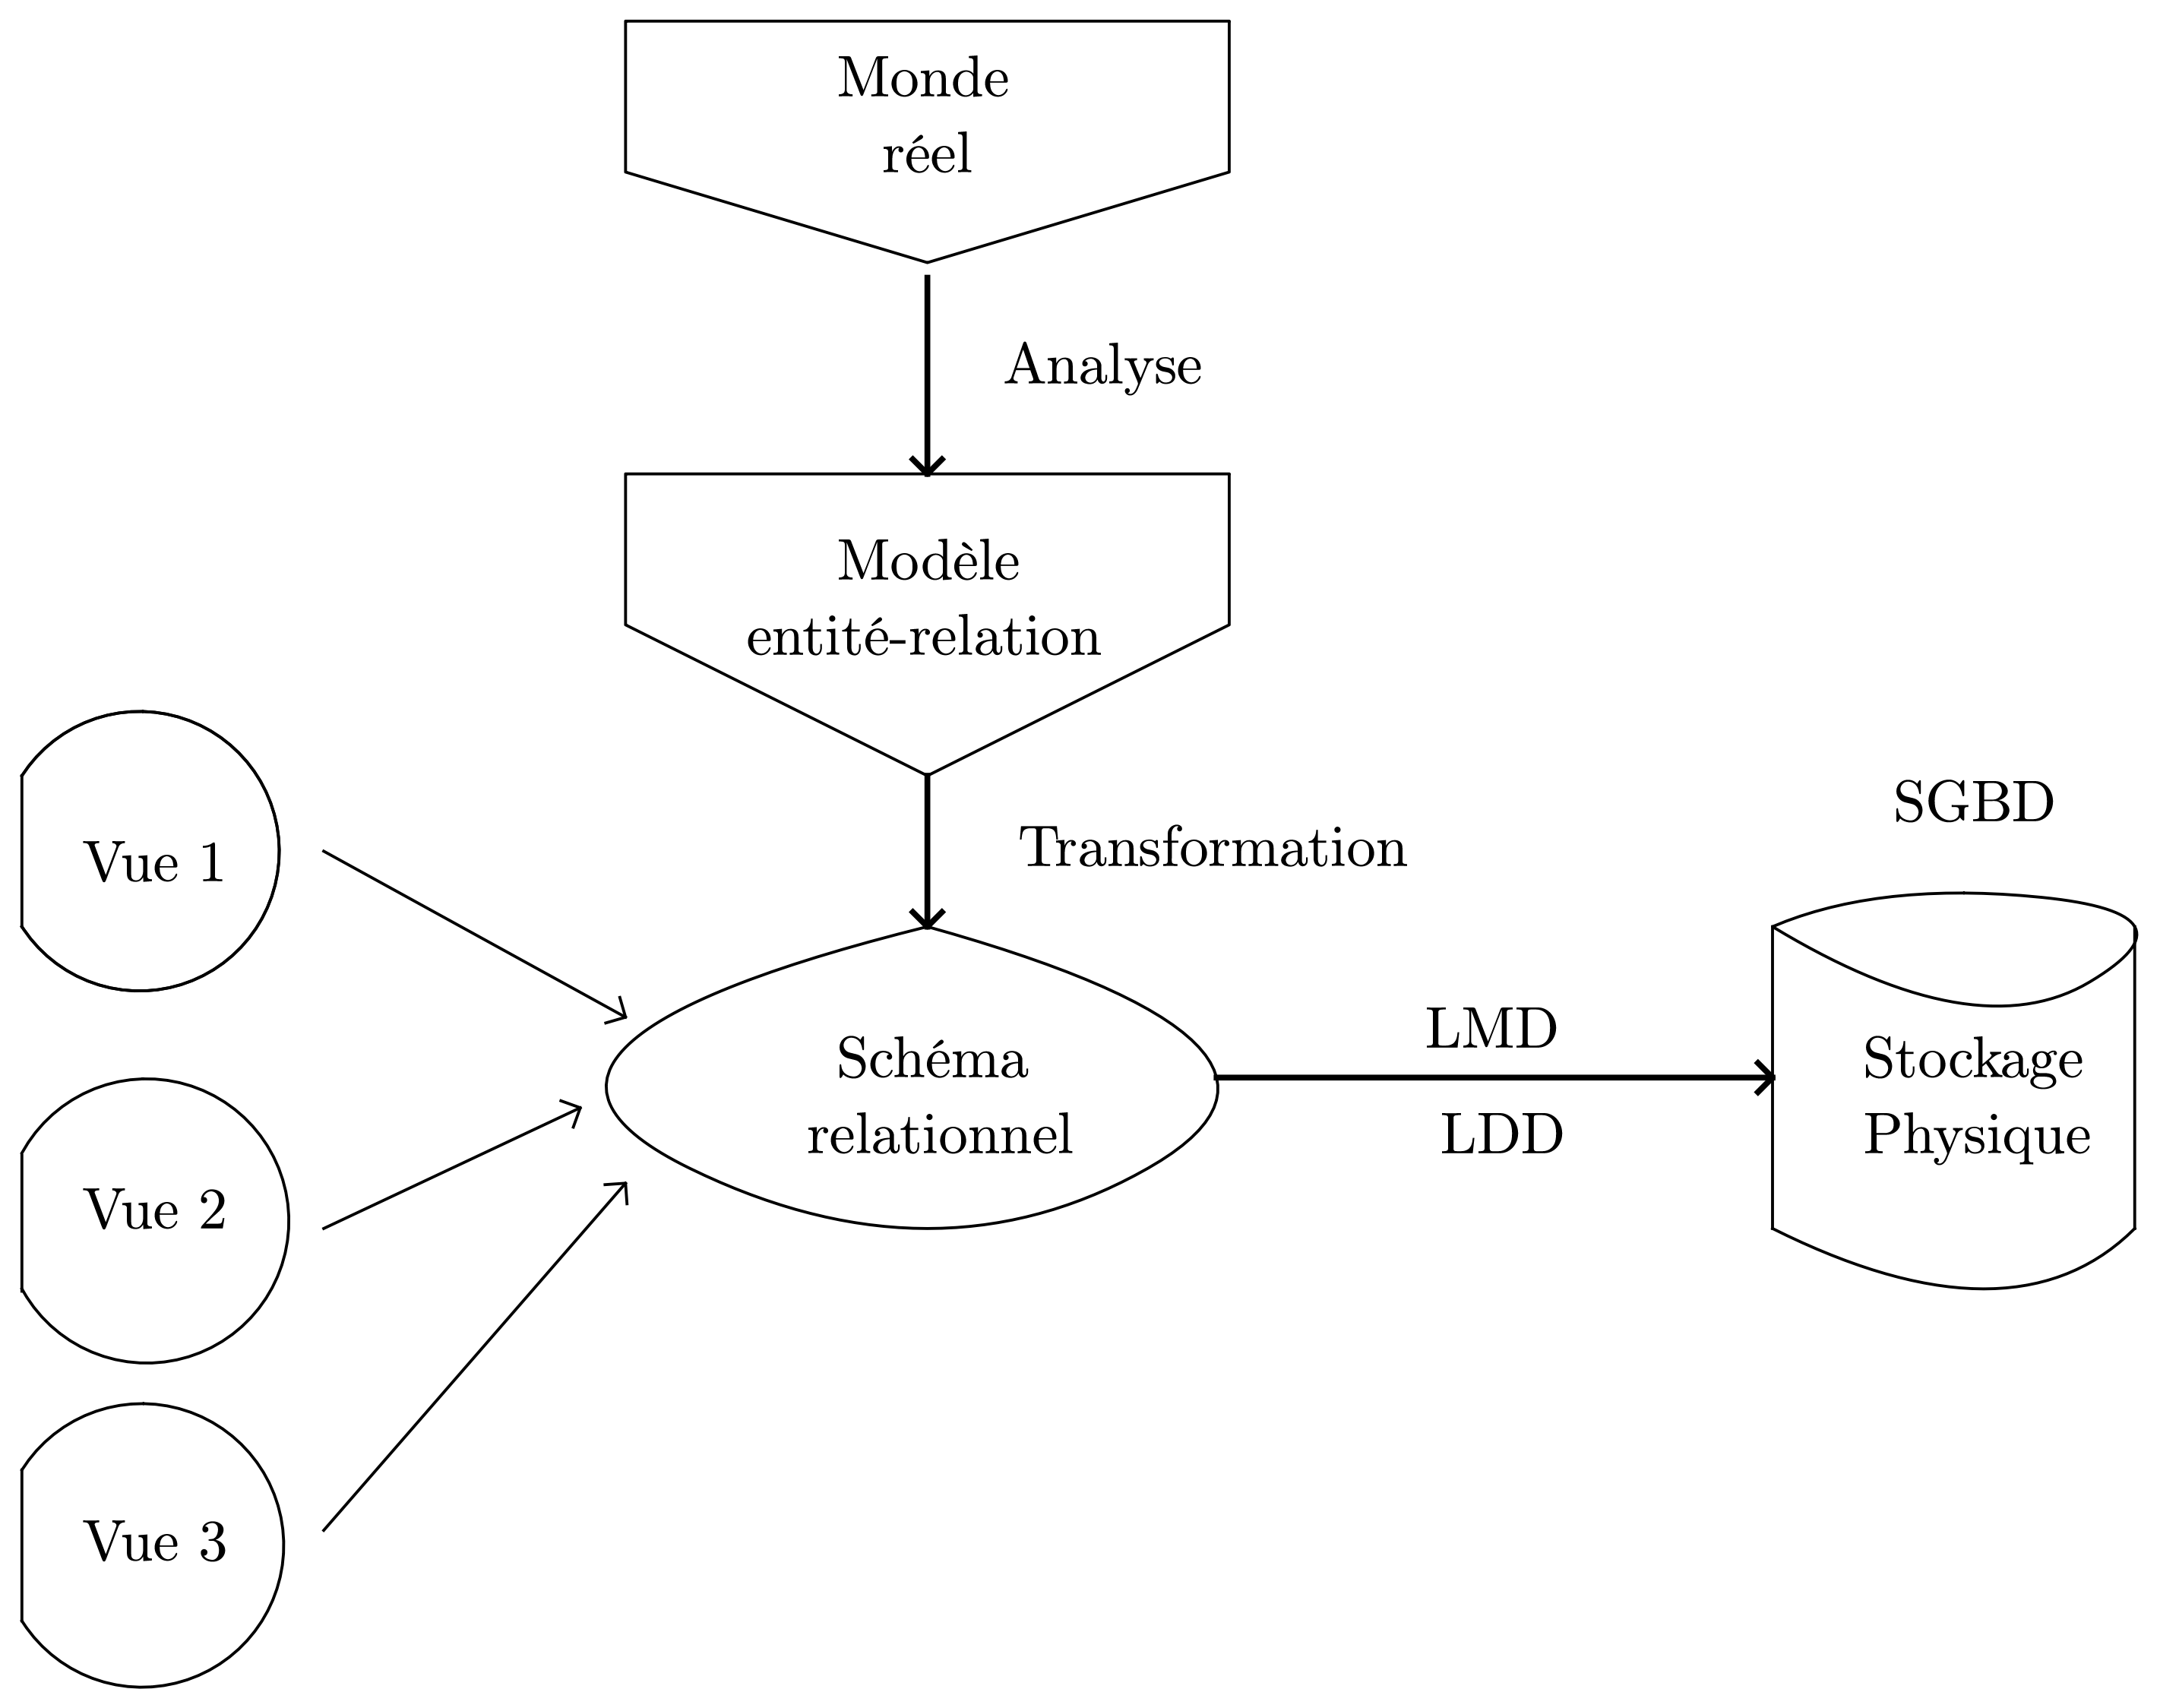
On peut décomposer le processus de conception d’une base de données en plusieurs étapes :
Analyse du système du monde réel à modéliser ;
Mise en forme du modèle pour l’intégrer dans le SGBD ;
Création effective dans le SGBD des structures et leur remplissage.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Le modèle Entités/Associations
Avertissement
Le modèle Entités/Associations en tant que tel n’est pas au programme. Par contre il me semble utile afin de vous faire comprendre comment on modèle le réel et on parvient au final à un schéma relationnel.
L’objectif de ce chapitre n’est donc pas la conception de schémas E/A mais plutôt leur compréhension et leur interprétation.
Ce chapitre présente la première étape du processus de modélisation du
monde réel. On commence par recueillir les informations à intégrer dans
la base de donnée puis on les transcrit sous une forme qui nous
permettra, dans le prochain chapitre, à passer au modèle relationnel
(choix de la structure de la base, clés, ...).
Principes généraux
Dans un schéma E/A, on distingue les entités qui constituent la base
de données, et les associations entre ces entités. Pour illustrer le
besoin de cette distinction, on commence traditionnellement par
illustrer les problèmes qui ne manquent pas de survenir lorsqu’on traite
une base relationnelle comme un simple fichier texte, sans se soucier de
lui donner une structure correcte.
Problèmes lorsque la structure de la base n’a pas été pensée
On commence généralement par créer et étudier une base se
limitant à la table suivante :
titre
annee
nom_realisateur
prenom_realisateur
annee_naissance
Alien
1979
Scott
Ridley
1943
Vertigo
1958
Hitchcock
Alfred
1899
Psychose
1960
Hitchcock
Alfred
1899
Kagemusha
1980
Kurosawa
Akira
1910
Volte-face
1997
Woo
John
1946
Pulp Fiction
1995
Tarantino
Quentin
Titanic
1997
Cameron
James
1954
Sacrifice
1986
Tarkovski
Andrei
1932
Inglourious Basterds
2009
Tarantino
Quentin
1963
Reservoir Dogs
1992
Tarantino
1963
Avatar
2009 Cameron
James
1954
Arizona Dream
1993
Kusturica
Emir
Le Ruban blanc
2009
Haneke
Michael
1942
Table FilmSimple.
Info
La conception de cette base soufre de graves défauts :
Anomalies lors d’une insertion
Qu’est-ce qui distingue deux films différents ?
La conception de cette base ne permet pas de répondre à cette
question puisqu’on peut insérer deux films de même nom mais de
réalisateurs différents, par exemple.
Une bonne conception
nécessiterait un choix : Deux films peuvent-ils avoir le même
titre ? Si non, un film peut-être repéré par son titre, si oui, il
reste à définir ce qui identifiera un film.
Anomalies lors d’une modification
Les données sont incohérentes car il manque une date de naissance et
un prénom. Toute modification de la table peut conduire à une telle
incohérence. De plus, ces modifications doivent être effectuées
plusieurs fois, sans contrôle de cohérence.
Pour finir, le Tarantino de « Reservoir Dogs » est-il le même que
celui de « Pulp Fiction » ?
Anomalies lors d’une destruction
Toute destruction d’un enregistrement retire les renseignements sur
le film et sur le réalisateur : supprimer l’entrée de
« Volte-face » efface tout renseignement sur John Woo.
On remarque que c’est la présence de la même information à plusieurs
endroits qui est à l’origine de pratiquement tous les problèmes.
Un exemple de structure de base pensée
Info
Pour éviter les anomalies énumérées ci-dessus, il faut :
Être capable de représenter individuellement les films et les
réalisateurs, de manière à ce qu’une action sur l’un n’entraîne pas
systématiquement une action sur l’autre ;
Définir une méthode d’identification d’un film ou d’un
réalisateur, qui permette d’assurer que la même information est
représentée une seule fois ;
Préserver le lien entre les films et les réalisateurs, mais sans
introduire de redondance.
Les deux premièrs problèmes nécessitent, pour être résolus, d’effectuer
des choix. Par exemple : deux films ne peuvent pas avoir le même titre mais deux
réalisateurs peuvent avoir le même nom. Afin de pouvoir identifier les
réalisateurs, on doit alors leur attribuer un identifiant unique.
titre
annee
Alien
1979
Vertigo
1958
Psychose
1960
Kagemusha
1980
Volte-face
1997
Pulp Fiction
1995
Titanic
1997
Sacrifice
1986
Inglourious Basterds
2009
Reservoir Dogs
1992
Avatar
2009
Arizona Dream
1993
Le Ruban blanc
2009
Table des films
id
nom_realisateur
prenom_realisateur
annee_naissance
1
Scott
Ridley
1943
2
Hitchcock
Alfred
1899
3
Kurosawa
Akira
1910
4
Woo
John
1946
5
Tarantino
Quentin
1963
6
Cameron
James
1954
7
Tarkovski
Andrei
1932
8
Kusturica
Emir
1954
9
Haneke
Michael
1942
Table des réalisateurs
Dans les tables ci-dessus, les identifiants (ou clés) sont
représentés en gras.
Premier progrès
Il n’y a maintenant plus de redondance dans la base de données.
Problème
Il n’existe aucun lien entre les deux tables. Comment savoir qui a réalisé « Le Ruban blanc » ?
On ajoute alors un attribut dans la table Films :
titre
annee
id_rea
Alien
1979
1
Vertigo
1958
2
Psychose
1960
2
Kagemusha
1980
3
Volte-face
1997
4
Pulp Fiction
1995
5
Titanic
1997
6
Sacrifice
1986
7
Inglourious Basterds
2009
5
Reservoir Dogs
1992
5
Avatar
2009
6
Arizona Dream
1993
8
Le Ruban blanc
2009
9
Table des films
id
nom_realisateur
prenom_realisateur
annee_naissance
1
Scott
Ridley
1943
2
Hitchcock
Alfred
1899
3
Kurosawa
Akira
1910
4
Woo
John
1946
5
Tarantino
Quentin
1963
6
Cameron
James
1954
7
Tarkovski
Andrei
1932
8
Kusturica
Emir
1954
9
Haneke
Michael
1942
Table des réalisateurs
Cette représentation est correcte : la redondance est réduite au minimum
puisque seule la clé identifiant un réalisateur apparaît dans deux
tables (on parle de clé primaire dans la cas de la table des
réalisateurs et de clé étrangère dans le cas de la table des films). On
peut vérifier que les anomalies relevées dans la section précédente ont
disparu : on sait ce qui identifie un film, on sait ce qui identifie un réalisateur ; toute modification n’affecte que l’instance visée ; on peut détruire l’entrée
d’un film sans affecter celle de son réalisateur.
Info
La modélisation E/A offre une méthode simple pour parvenir au résultat
ci-dessus sans avoir à écrire les tables, même dans des cas bien plus
complexes que celui présenté ici.
Le modèle E/A : présentation informelle
Info
Un schéma E/A réalise une abstraction de l’application étudiée, pertinente relativement aux objectifs visés et choix effectués. On distingue :
des entités, représentées par des rectangles, ici Film, Artiste, Internaute et Pays ;
des associations entre entités représentées par des liens entre ces rectangles
Chaque entité est caractérisée par un ensemble d’attributs, parmi lesquels un ou plusieurs forment l’identifiant unique (souligné sur la figure ci-dessus).
Info
Les associations sont caractérisées par des cardinalités. La notation « 0,* » sur le lien Réalise du côté de l’entité Film signifie qu’un artiste peut réaliser 0 ou plusieurs films. La
cardinalité est essentielle même si elle est forcément discutable puisque résultat d’un choix de conception.
Les cardinalités sont notées à l’aide de deux chiffres : celui de droite indique la cardinalité maximale (elle vaut généralement 1 ou *), celui de gauche indique la cardinalité minimale.
La notation « 0,1 » pour l’association Réalise indique que l’on s’autorise à ne pas connaître le réalisateur du film, « 1,1 » entre Film et Pays indique, au contraire, que l’on doit toujours connaître le pays
producteur du film.
Il existe quelques raccourcis :
La notation « * » est équivalente à « 0,* » ;
La notation « 1 » est équivalente à « 1,1 ».
Info
Un schéma E/A est totalement indépendant de tout choix
d’implémentation. Il n’est pas question de type, de structure de données, d’algorithme, de langage, ... C’est, en théorie, la partie la plus stable d’une application utilisant des bases de données.
Le modèle
Le modèle E/A, conçu en 1976, est à la base de la plupart des méthodes de conception. La syntaxe utilisée ici est celle de la méthode UML.
Entités, attributs et identifiants
La première étape d’une conception consiste à identifier les entités tiles.
À retenir
On désigne par entité tout objet identifiable et pertinent pour l’application.
La notion d’identité est primordiale, c’est elle qui permet de distinguer les entités les unes des autres, et donc de dire qu’une information est redondante ou qu’elle ne l’est pas. Il est indispensable de prévoir un moyen technique pour pouvoir effectuer cette distinction entre entités au niveau de la base de données : on parle
d’identifiant ou de clé.
Attributs
Les entités sont caractérisées par des propriétés ou attributs : le titre (du film), le nom (de l’acteur), sa date de naissance, ... Un attribut est désigné par un nom et prend ses valeurs dans un domaine énumérable, comme les entiers, les chaînes de caractères, les dates,
etc.
Il est important de noter que, selon cette définition, un attribut prend une valeur et une seule. On dit que les attributs sont atomiques.
Types d’entités
Il est maintenant possible de décrire plus précisément les entités par leur type :
À retenir
Le type d’une entité est composé des éléments
suivants :
son nom ;
la liste de ses attributs avec (optionnellement) le domaine où l’attribut prend ses valeurs : les entiers, les chaînes de caractères, ... ;
l’indication de (ou des) attribut(s) permettant d’identifier l’entité : ils constituent la clé.
À retenir
Une clé est un sous-ensemble d’attributs minimal d’une entité permettant d’identifier de manière unique cette entité.
Un internaute est caractérisé par plusieurs attributs : son email, son nom, son prénom, ... L’émail constitue une clé naturelle puisqu’on ne trouve pas, en principe, deux internautes ayant la même adresse
électronique. L’identification par nom est impossible, mais on pourrait cependant utiliser la paire (nom,preˊnom). Il est cependant conseillé d’éviter d’utiliser une telle structure de clé car elle pose
des problèmes de performances et complique les manipulations SQL par la suite.
Il est possible d’avoir plusieurs clés pour un même ensemble d’entités.
Dans ce cas, on en choisit une comme clé primaire, et les autres, comme clés secondaires.
À retenir
Les caractéristiques d’une clé primaire devraient être :
Sa valeur doit apparaître de façon évidente dans le schéma E/A ;
On ne doit jamais avoir à ressentir le besoin de modifier cet attribut ;
Pour des raisons de performance, sa taille de stockage doit être la plus petite possible.
Remarque
Dans la conception choisie, dans l’exemple de la base Film, il a été décidé que deux films ne pouvaient pas avoir le même titre : ce dernier est donc un bon candidat pour être la clé de la table. Quelle clé aurait-il
fallu choisir si l’on avait accepté que deux films aient le même titre ? Il aurait été nécessaire d’introduire un champ abstrait, nommé par exemple, destiné à tenir le rôle de clé.
Associations binaires
À retenir
Une association binaire lie deux entités.
On remarque, sur la schéma ci-dessus, que :
certains réalisateurs mettent en scène plusieurs films ;
inversement, un film est mis en scène par un réalisateur, au maximum.
L’association, pour être la plus explicite possible, doit donc faire apparaître ces différences.
À retenir
La cardinalité d’une association est une paire [min,max] telle que :
Le symbole max(cardinalité maximale) désigne le nombre maximal de fois où une entité peut intervenir dans l’association.
En général, ce nombre est 1 (au plus une fois) ou n (plusieurs fois, nombre indéterminé), noté par le symbole « * ».
Le symbole min(cardinalité minimale) désigne le nombre minimal de fois où une entité peut intervenir dans la relation. En général, ce nombre est 1 (au moins une fois) ou 0.
Les cardinalités maximales sont plus importantes que les cardinalités minimales ou, plus précisément, elles s’avèrent plus difficiles à remettre en cause, une fois que le schéma de base est constitué. Les cardinalités n’expriment pas une vérité absolue, mais des choix de
conception.
Info
Dans la notation UML, on indique les cardinalités aux deux extrémités d’un lien d’association entre deux types d’entités TA et TB. Les cardinalités de TA sont placées à l’extrémité du liant allant de TA vers TB alors que les cardinalités pour TB sont placées à
l’extrémité du lien allant de TB vers TA.
L’association Réalise se lit : un réalisateur réalise zéro, un ou plusieurs films ; un film est réalisé par zéro ou au maximum un réalisateur.
Remarque
Le schéma ci-dessus ne fait pas apparaître l’entité Réalisateur mais l’entité Artiste. De plus deux associations relient ces entités.
Quelle conception a pu entraîner un tel schéma ? En réalité, un réalisateur peut être acteur dans un film ; il est donc préférable de regrouper les acteurs et les réalisateurs dans type d’entité plus
général : Artiste. L’association Réalise ne peut donc plus modéliser le lien entre les entités Film et Artiste ; il est alors nécessaire de créer l’association Joue. On obtient le schéma ci-dessous :
Remarque
Dans le cas d’associations avec des cardinalités multiples de chaque côté, on peut être obligé de lier des attributs à une association (par exemple l’association Joue a pour attribut le rôle). En effet, un attribut ne pouvant prendre qu’une et une seule valeur, on ne peut pas associer l’attribut rôle à l’entité Artiste puisqu’un acteur
peut jouer dans plusieurs films (il existe fort peu de chances qu’il tienne toujours le même rôle !). Seules les associations ayant des cardinalités multiples de chaque côté peuvent porter des attributs.
Une association étant définie par un ensemble de couples d’entités, on peut donc se demander comment la caractériser.
À retenir
La clé d’une association (binaire) entre un type
d’entité E1 et un type d’entité E2 est le couple constitué de la clé c1 de E1 et de la clé c2 de E2.
En pratique, cette définition est trop contraignante car on peut vouloir
autoriser deux entités à être liées plus d’une fois dans une
association. Par exemple, un internaute peut être amené à noter
plusieurs fois un film, en conservant l’historique de ces notations. Une
association binaire entre Internaute et Film est impossible : on ne
peut définir qu’un seul lien entre un film donné et un internaute donné !
Pour résoudre ce problème, il est nécessaire d’introduire des types fictifs et des associations multiples, ... ce que nous ne ferons pas dans ce cours.
Exercice
Exercice 1 : choix d’un identifiant
On considère l’entité ci-après, qui décrit des salles de cinémas. Les attributs de cette entité sont les suivants :
nom de la salle ;
nom du cinéma ;
ville du cinéma ;
nombre de places ;
taille de l’écran.
Que peut-on proposer comme identifiant (clé) pour cette entité ?
Exercice 2 : identification des entités et des associations
On veut modéliser l’activité de vente de billets pour un théâtre. Quelles entités et quelles associations pourrait-on créer ?
Proposer des attributs et les identifiants (clés) pertinents pour décrire ces entités et ces associations.
Exercice 3 : description du monde réel à partir des cardinalités
On donne le schéma E/A d’un séminaire.
Quelle description peut-on faire du lien entre les différentes entités à partir des cardinalités ?
Exercice 4 : cardinalités
On donne le schéma E/A d’une bibliothèque.
Quelles questions faut-il poser aux utilisateurs de la base de données pour déterminer les cardinalités des associations ? Proposer une réponse à ces questions et en déduire les cardinalités pour chaque entité.
Exercice 5 : tournoi de tennis
Le schéma suivant représente des rencontres dans un tournoi de tennis :
Peut-on jouer des matchs de double ?
Un joueur peut-il gagner un match sans y avoir participé ?
Peut-il y avoir deux matchs sur le même terrain à la même heure ?
Connaissant un joueur, peut-on découvrir sur quels terrains il a joué ?
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Du schéma entités/associations au schéma relationnel
Concepts relationnels
Modèle relationnel
Le modèle relationnel tire son nom de la notion de relation
mathématique entre les éléments. Chacun de ces éléments peut prendre des
valeurs dans un ensemble défini.
Par exemple, les appareils électroménagers d’une cuisine peuvent être
contenus dans l’ensemble des valeurs suivantes : {Réfrigérateur,
Cuisinière, Hotte, Robot, Lave-vaisselle}. On peut, par ailleurs,
aussi considérer l’ensemble des couleurs que peuvent prendre ces
appareils : {Rouge, Vert, Bleu, Jaune, Blanc, Noir, Rose}.
Les combinaisons possibles entre les appareils et les couleurs sont au
nombre de 35. Parmi toutes ces combinaisons possibles, on effectue une
sélection qui représente la description d’une cuisine :
Cet ensemble de couples de valeurs liées entre elles, que l’on nomme
tuples dans le modèle relationnel, représente la
relation entre les éléments « Appareil » et « Couleur ». On
désigne les éléments constitutifs de ces tuples par les termes
attributs (ou champs).
On peut écrire formellement la relation à partir de son schéma
relationnel : ma_cuisine(Appareil, Couleur). Cette écriture représente le schéma relationnel de
la relation ma_cuisine. Les valeurs énoncées précédemment pour les champs
représentent leurs domaines, c’est à dire les ensembles de toutes
les valeurs possibles pour un champ.
On voit, à partir de cet exemple, qu’il est nécessaire de préciser les
concepts qui seront utilisés dans la suite de ce chapitre.
À retenir
Un schéma relationnelR est formé par un
ensemble fini de n attributs U={u1,…,un}. On le note
R[u1,…,un] ou R[U].
Quel est le schéma relationnel de la relation ma_cuisine ?
Réponse
Le schéma relationnel de la relation ma_cuisine est ma_cuisine(Appareil, Couleur).
À retenir
L’arité (ou degré) d’un schéma relationnel R est égale à sonnombre d’attributs*.*
Quelle est l’arité du schéma ma_cuisine(Appareil, Couleur) ?
Réponse
L’arité du schéma ma_cuisine(Appareil, Couleur) est 2.
À retenir
Un schéma de base de donnéeRB est un ensemble
fini de p schémas relationnels. On le note
RB{R1[U1],…,Rp[Up]}.
::: {.definition}
Definition 5. Un n-uplet (ou tuple) u sur U est une
fonction de U dans \ensuremathdom. Si u est un
n-uplet sur U et AϵU, u(A) est la valeur de u pour
l’attribut A.
L’écriture d’un n-uplet peut préciser les attributs : (Appareil :
Robot, Couleur : Mauve).
:::
::: {.definition}
Definition 6. Une relation, ou instance d’un schéma
relationnelR[U], est un ensemble fini I de n-uplets sur U. La
cardinalité de la relation est égale à celle de l’ensemble I.
Une relation est donc totalement décrite par :
le schéma relationnel ;
les domaines des différents champs ;
les tuples ou n-uplets qui la constituent.
On représente une relation par une table, correspondant à la notion de
tableau. Les tuples correspondent aux lignes et les attributs de la
relation aux colonnes.
Une relation étant constituée d’un ensemble de n-uplets, ceux-ci
doivent y être tous différents.
:::
La relation (cf. tableau 1) est d’arité 2 et de cardinalité 4.
::: {.definition}
Definition 7. Une base de donnéesB, ou instance d’un
schéma de base de donnéesRB, est une fonction, dont l’ensemble de
définition est un schéma de base de données RB, telle que pour tout
rϵRB, B(r) est une relation.
Une base de données est donc un ensemble de relations reliées entre
elles par des liens sémantiques.
:::
Notion de clé d’une relation et dépendance fonctionnelle
Lorsqu’on utilise une base de données, il est nécessaire d’accéder à un
enregistrement par le contenu d’un ou de plusieurs champs. On nomme
clé d’une relation un champ, ou un ensemble de champs, qui permet
d’identifier précisément un enregistrement. Une relation peut
comprendre plusieurs clés possibles ; ce sont les clés candidates.
::: {.definition}
Definition 8. On appelle clé primaire d’une relation la clé
minimale parmi toutes les clés candidates de la relation. Une clés
primaire doit toujours contenir une valeur et celle-ci doit être unique
pour chacun des enregistrements de la relation
:::
Dans l’exemple de la relation , le choix de la clé n’est pas simple
car :
Plusieurs appareils différents peuvent être de même couleur ;
Une cuisine peut comporter plusieurs réfrigérateurs, robots, ...
Pourrait-on envisager d’utiliser le couple (appareil, couleur) comme clé
? La réponse est toujours négative, les réfrigérateurs présents dans la
pièce peuvent être de même couleur.
Pour désigner une clé (primaire), il faut donc prendre en compte le «
sens » des données contenues dans la relation. Si aucun champ ne peut
constituer une clé, il est nécessaire d’introduire un champ formel, tel
qu’un identifiant numérique.
::: {.definition}
Definition 9. Une dépendance fonctionnelle existe entre deux
ensembles de champs si les valeurs contenues dans l’un des ensembles de
champs permettent de déterminer les valeurs contenues dans l’autre
ensemble.
:::
Les dépendances fonctionnelles expriment la relation de hiérarchie qui
existe entre les champs.
      1             Henri       10        Paris        Université Sorbonne
      2           Stanislas     34        Paris        Université Jussieu
      3           Henriette     44        Lyon              CHU Bron
      4           Dominique     19        Nancy        Université Poincaré
      5           Isabelle      56        Nancy               INPL
      6            Olivier      51      Marseille   Université Saint Charles
      7             Henri       98        Paris        Université Sorbonne
      8            Jérôme       23        Nancy               INPL
      9           Laurence      34      Bordeaux    Université Victor Segalen
      10          Christian     41        Paris                ENS
      11           Antoine      16      Marseille   Université Saint Charles
      12          Laurence      34        Paris        Université Jussieu
Si l’on examine les données de la relation , Tableau
1{reference-type=“ref”
reference=“relation-lecteur”}., on remarque :
qu’il ne peut y avoir de dépendance fonctionnelle entre les
ensembles (Ville, Etablissement) et (Nom, Age). En effet, le couple
(Laurence, 34) correspond aux deux couples (Paris, Université de
Jussieu) et (Bordeaux, Université Victor Segalen).
À un couple (Ville, Etablissement) ne correspond donc pas un unique
couple (Nom, Age).
que si l’on suppose qu’un établissement n’est situé que dans une
seule ville, il existe une dépendance fonctionnelle entre le champ «
Etablissement » et le champ « Ville ».
À une valeur du champ « Etablissement » correspond une et une seule
valeur du champ « Ville ». Cette valeur n’est cependant pas unique.
La valeur du champ « Numero_carte » est unique pour chacun des
enregistrements. Ses valeurs sont identifiantes pour tous les champs
de la relation. Chaque champ dépend fonctionnellement de ce champ.
Ses valeurs ne sont jamais vides, c’est une clé candidate !
Comme c’est aussi la seule clé de la relation, ce champ constitue la
clé primaire.
Tous les champs qui ne font pas partie d’une clé candidate d’une
relation possèdent des dépendances fonctionnelles avec cette clé.
On indique la clé primaire d’un schéma relationnel en soulignant le
champ, dans le schéma relationnel : lecteur([Numero_carte]{.ul}, Nom,
Age, Ville, Etablissement).
Langage SQL
SQL est un langage déclaratif qui permet d’interroger une base de
données par l’intermédiaire d’un SGBD sans se soucier de la
représentation interne (physique) des données, de leur localisation, des
chemins d’accès ou des algorithmes nécessaires. À ce titre, il s’adresse
à une large communauté d’utilisateurs potentiels, pas seulement aux
informaticiens. On peut l’utiliser de manière interactive, mais
également en association avec des interfaces graphiques, ou des langages
de programmation (comme Python).
Le langage SQL est composé de différents sous-ensembles :
LMD
Langage de Manipulation des données (DML, Data Manipulation
Language).
Il permet la manipulation et la mise à jour des tables, et est
composé de quatre ordres fondamentaux : , , , .
LDD
Langage de Définition des Données (DDL, Data Definition Language).
Il permet la définition et la mise à jour du schéma relationnel
de la base de données (mode administration). Il est composé des
ordres suivants : , , , , , , .
LCD
Langage de Contrôle des Données (DCL, Data Control Language).
Il permet de définir les contraintes d’intégrité, de gérer les accès
et les autorisations (administration). Il est composé des ordres : ,
, .
Le programme cette année se limite au langage de manipulation des
données et plus particulièrement à l’ordre .
Opérations de l’algèbre relationnelle et traductions en langage SQL
La manipulation de données dans le modèle relationnel se fait à l’aide
d’opérations formelles reposant sur des concepts mathématiques issus de
la théorie des ensembles : c’est l’algèbre relationnelle.
::: {.definition}
Definition 10. L’algèbre relationnelle consiste en un petit
nombre d’opérations de base qui, appliquées à des relations,
produisent de nouvelles relations. Ces opérations peuvent être
composées pour construire des expressions algébriques de plus en plus
complexes.
:::
Opérations relationnelles de base
Projection
::: {.definition}
Definition 11. La projection consiste à filtrer certains
attributs de la relation, ce qui donne au résultat une relation de
degré inférieur à celui de la relation de départ.
Pour I une relation de schéma relationnel I[A1,…,An], si 1⩽i<j⩽n,
πAi,…,Aj(I)={(Ai:t(Ai),…,Aj:t(Aj))∣tϵI}
:::
**Nom** **Ville**
Henri Paris
Stanislas Paris
Henriette Lyon
Dominique Nancy
Isabelle Nancy
Olivier Marseille
Henri Paris
Jérôme Nancy
Laurence Bordeaux
Christian Paris
Antoine Marseille
Laurence Paris
::: {.definition}
Definition 12. La sélection consiste à filtrer des
enregistrements de la relation en fonction d’une condition. Le
résultat d’une sélection est une relation de même degré mais de
cardinalité différente.
Pour I une relation de schéma relationnel I[A1,…,An] et aϵ\ensuremathdom(Ai),
σAi=a(I)={tϵI∣t(Ai)=a}
:::
Numero_carteNomAgeVilleEtablissement
      5           Isabelle     56        Nancy               INPL
      6           Olivier      51      Marseille   Université Saint Charles
      7            Henri       98        Paris       Université Sorbonne
: Selection σAge>50(lecteur)
Numero_carteNomAgeVilleEtablissement
      1            Henri      10        Paris     Université Sorbonne
      7            Henri      98        Paris     Université Sorbonne
: Selection σNom=”Henri”(lecteur)
Intuitivement, dans une représentation de type table, une sélection
conserve uniquement les enregistrements vérifiant la condition.
Affichage de tous les enregistrements d’une relation
Composition d’une sélection et d’une projection
Une sélection sur une relation formant une nouvelle relation, il est
possible de « passer » cette dernière en argument d’une opération de
projection. La composition se note :
πchamps(σcontrainte(relation))
NomVille
Isabelle Nancy
Olivier Marseille
Henri Paris
: Combinaison d’une sélection et d’une projection
πNom,Ville(σAge>50(lecteur))
Opérateurs de comparaison et connecteurs logiques de SQL
Ci-dessous sont présentés quelques opérateurs et connecteurs qui
apparaissent très fréquemment dans les requêtes SQL. Pour une liste plus
exhaustive et davantage d’exemples, consulter http://sql.sh.
OpérateurSignification
    $=$              Égal
   $< >$           Différent
    \<             Inférieur
    $>$            Supérieur
   $< =$       Inférieur ou égal
   $> =$       Supérieur ou égal

 **Signification**
 Appartient à un intervalle
 Appartient à un ensemble
 Teste si le champ contient une donnée
 Compare des chaînes de caractères

  **Nom**        **Instrument**
Jaco Pastorius Basse électrique
Bill Evans Piano
Appareil Couleur Nom Instrument
Réfrigérateur rouge Jaco Pastorius Basse électrique
Réfrigérateur rouge Bill Evans Piano
Robot mauve Jaco Pastorius Basse électrique
Robot mauve Bill Evans Piano
Cuisinière jaune Jaco Pastorius Basse électrique
Cuisinière jaune Bill Evans Piano
: ma_cuisine×musicien
L’exemple précédent a été choisi de façon à illustrer que le résultat
d’un produit cartésien peut n’avoir aucun sens dans la réalité.
En langage SQL
il n’est pas nécessaire d’utiliser un quelconque mot clé ; il faut
requérir toutes les colonnes depuis les deux tables.
Division Cartésienne
La division cartésienne est le pendant du produit cartésien, tout comme
la division euclidienne est le pendant du produit sur des entiers : si
on note A et B deux relations (ou tables), alors A÷B est la
« plus grande » relation (au sens de l’inclusion) telle que le produit
cartésien avec B redonne (presque) A. Formellement, c’est la plus
grande relation telle qu’il existe une relation C vérifiant :
[(A÷B)×B]∪C=A et [(A÷B)×B]∩C=∅
Il n’existe pas en langage SQL
d’opérateur permettant d’implémenter directement la division
cartésienne.
Création d’un alias, renommage
Il peut être pénible d’utiliser, dans les requêtes, des noms de champs
définis de manière complexe, ou, tout simplement, nommés de façon pas
très parlante. On peut alors définir un alias pour renommer
temporairement un champ (et même une table).
::: {.definition}
Definition 13. Un renommage pour un ensemble fini d’attributs U est
une fonction injective de U dans l’ensemble att que l’on notera
A1→B1,...,An→Bn.
L’opération de renommage
ρA1→B1,...,An→Bn transforme une relation I sur A1,...,An en une relation
sur B1,...,Bn de de telle sorte que :
ρA1→B1,...,An→Bn(I)={vsurB1,…,Bn∣∃uϵI,v(Bi)=u(Ai)pour tout iϵ[1,n]}
:::
La création d’un alias permet de faciliter grandement la lecture d’une
requête. Cette opération se note :
BadgeNomVille
   7        Henri       Paris
   6       Olivier    Marseille
   5       Isabelle     Nancy
on utilise le mot clé , immédiatement après le nom du champ, pour
introduire l’alias.
Dans l’exemple précédent, on a illustré l’utilisation de la clause « »
qui permet de trier les résultats suivant l’ordre (par défaut
ascendant) défini par certains champs (ici le mot clé indique que c’est
l’ordre descendant qui a été choisi).
Jointure
La jointure est l’opération fondamentale de l’algèbre relationnelle
qui permet d’exprimer le sens du lien entre les relations, dans le monde
réel. Conformément au programme, on ne présente ici que l’opération de
jointure symétrique.
::: {.definition}
Definition 14. Une jointure permet d’associer plusieurs
relations dans une même requête. Le résultat de cette requête est une
relation de degré supérieur aux degrés de chacune des relations de
départ. L’opération de jointure est symétrique et associative.
La liaison entre les relations s’effectue par le contenu commun d’un
champ (champs de jointure).
La jointure des relations et selon une certaine contrainte se note :
table1⊳⊲contraintetable2 ou table1[\ensuremathcontrainte]table2
:::
Il est bien évidemment possible d’associer une jointure à une
projection et une sélection. Ces associations doivent être prises en
compte lors de la détermination du degré et de la cardinalité de
la relation finale.
Même si l’on ne dispose pas du modèle conceptuel associé, on constate
que l’on peut relier les deux relations par le champ « ». Les
informations concernant l’établissement de la relation « » sont
stockées dans la relation « » dont la clé est le champ « ». Pour
obtenir la liste des lecteurs ainsi que les informations concernant leur
établissement, on effectue une jointure entre ces relations sur le champ
« ».
Schéma de la base de données prenant en compte la jointure : Dans la
relation l’attribut est une clé étrangère.
Le champ « » figure deux fois dans la relation résultat de la jointure
car la première occurrence provient de la relation « » alors que la
seconde provient de la relation « ».
Afin de ne conserver qu’une occurrence des champs de jointure, on
peut réaliser une projection :
Cette opération, jointure+projection, est parfois
appelée jointure naturelle.
Les champs de jointure ne doivent pas nécessairement être nommés à
l’identique. Nous verrons comment les différentier dans la partie « En
langage SQL », page .
On peut considérer l’opération de jointure comme une sélection sur le
produit cartésien des deux relations. On ne conserve que les lignes
dont le contenu du champ sur lequel s’effectue la jointure est égal.
1 Henri 1 1 Paris Université Jussieu
1 Henri 1 2 Lyon CHU Bron
1 Henri 1 3 Nancy Université Poincaré
1 Henri 1 4 Paris Université Sorbonne
2 Stanislas 2 1 Paris Université Jussieu
2 Stanislas 2 2 Lyon CHU Bron
2 Stanislas 2 3 Nancy Université Poincaré
2 Stanislas 2 4 Paris Université Sorbonne
3 Henriette 1 1 Paris Université Jussieu
3 Henriette 1 2 Lyon CHU Bron
3 Henriette 1 3 Nancy Université Poincaré
3 Henriette 1 4 Paris Université Sorbonne
: Lecteur_bis⊳⊲Num_Etablissement=Num_EtablissementEtablissementLes lignes grisées sont celles qui sont
sélectionnées lors d’une jointure.
En langage SQL
il existe deux façons de réaliser une opération de jointure en SQL :
la première est basée sur l’idée qu’une opération de jointure
peut être considérée comme une sélection sur le produit
cartésien des deux relations :
Avec une projection :
Le traitement de la requête n’est cependant pas, dans ce cas,
optimal au niveau du SGBD.
la seconde méthode utilise l’opérateur de jointure :
Avec une projection :
On remarque qu’un champ est défini de façon unique grâce à la
concaténation du nom de la relation et de celui du champ :
.[
champ−nom−unique
]{#champ-nom-unique label=“champ-nom-unique”}
Si les champs portent des noms différents, il n’est pas nécessaire
de préciser de quelle relation ils sont issus.
Fonctions de calculs et d’agrégation
Une règle, dans le domaine des bases de données, est que tout ce qui
peut se calculer ne doit pas être stocké dans la base. On évite ainsi
la perte de place et l’incohérence qui peut découler du stockage
d’informations redondantes.
Fonctions de calculs
Le langage SQL ne possède pas d’instruction d’itération ; il possède
cependant des fonctions simples de traitement des données d’une
colonne (les calculs plus complexes doivent être effectués à l’aide
d’un langage de programmation comme Python).
FonctionOpération
Comptage du nombre d'enregistrements de la table
Maximum des éléments d'une colonne
Minimum des éléments d'une colonne
Moyenne des éléments d'une colonne
Somme des éléments d'une colonne
: Fonctions statistiques de SQL
Détermination de l’age moyen des lecteurs
:
Comptage du nombre de lecteurs
Dans le cas de la fonction , il n’est pas nécessaire de préciser le
champ puisque cette fonction s’applique à la relation toute entière.
Agrégats ou groupage
::: {.definition}
Definition 15. Les opérations d’« agrégation » (ou de groupage)
regroupent les enregistrements d’une relation par valeurs contenues dans
une colonne.
On applique généralement des opérations de calcul sur les
« sous-tables » ainsi créées.
:::
NumVoitMarqueTypeCouleur
1 Peugeot 404 Rouge
2 Citroen SM Noire
3 Opel GT Blanche
4 Peugeot 403 Blanche
5 Renault Alpine Rose
6 Renault Floride Bleue
7 Peugeot 806 Blanche
: Relation Voiture(NumVoit,Marque,Type,Couleur)
Affichage des différentes marques
Pour réaliser cette opération avec SQL, on utilise le mot clé suivi
du nom de la colonne sur laquelle s’effectue l’agrégat.
: Comptage du nombre de voitures, pour chaque marque
Affichage de l’age moyen des lecteurs, par université de la relation
:
Restriction sur le résultat d’une requête agrégative
Le résultat de l’opération de groupage peut lui-même être filtré : on
effectue une sélection des lignes par rapport au contenu des colonnes
obtenues dans la table résultat de la recherche groupée.
Calcul du nombre de voitures par marque dont le nombre est supérieur à 1
: Comptage du nombre de voitures, pour chaque marque, si le nombre
est supérieur à 1
Le mot clé permet d’effectuer une sélection sur le résultat de
l’opération de groupage. Le mot clé opère une sélection sur les
enregistrements de la table avant l’opération de groupage.
Calcul du nombre de voitures, par marque, dont la couleur n’est pas « Rouge »
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Le langage SQL : Le langage de manipulation de données (LMD)
Introduction
Info
Le langage SQL est composé de différents sous-ensembles :
LMD : Langage de Manipulation des données (DML, Data Manipulation Language)
Permet la manipulation et la mise à jour des tables, composé de quatre ordres fondamentaux : SELECT, UPDATE, INSERT, DELETE.
LDD : Langage de Définition des Données (DDL, Data Definition Language)
Permet la définition et la mise à jour du schéma relationnel de la base de données (mode administration). Composé des ordres suivants : CREATE TABLE, CREATE INDEX, CREATE VIEW, DROP TABLE, DROP INDEX, DROP VIEW, ALTER TABLE.
LCD : Langage de Contrôle des Données (DCL, Data Control Language)
Permet de définir les contraintes d’intégrité, de gérer les accès et les autorisations (administration). Composé des ordres : GRANT, REVOKE, LOCK. Recouvre les déclencheurs (triggers), procédures cataloguées.
Le programme se limite au sous-ensemble LMD. Nous serons tout de même obligés d’utiliser l’ordre de création de table CREATE TABLE.
SQLite
Dans ce cours nous utiliserons SQLite depuis l’interface de
Repl.it
.
SQLite est un moteur de base de données relationnelle (sous-ensemble d’un SGBD) accessible par le langage SQL. Contrairement aux serveurs de bases de données traditionnels, comme MySQL ou PostgreSQL, sa particularité est de ne pas reproduire le schéma habituel client-serveur mais de fonctionner sans serveur (on parle de base de données « standalone » ou « embarquée »). L’intégralité de la base de données (déclarations, tables, index et données) est stockée dans un fichier indépendant de la plateforme.
Remarque
On peut accéder à SQLite depuis de nombreux langages de programmation. Nous utiliserons dans un premier temps une interface en ligne de commande (CLI) et par la suite Python.
SQLite est le moteur de base de données le plus utilisé au monde.
Indiquer la signification de chaque ligne de la commande.
Incorporer la commande au fichier celebrites.sql et l’exécuter.
Afin de vérifier que la commande a bien créé une table dans la base de données qui réside pour l’instant dans la RAM, ajouter la commande suivante au fichier main.sql
-- Énumérations des tables
.tables
Relancer l’exécution des commandes et observer le résultat dans la console.
Afin d’examiner la structure de la table Celebrites, ajouter l’une des commandes suivantes au fichier main.sql.
-- Structure de la table Celebrites
.schema'Celebrites'
ou
-- Structure de la table Celebrites
pragmatable_info('Celebrites');
La commande permettant d’intégrer le tuple ("Hanks", "Tom", "Homme", "USA", 64) à la relation Celebrites est :
La commande, telle qu’elle est donnée ici, impose le respect de l’ordre des informations dans le tuple.
Intégrer la commande précédente au fichier celebrites.sql. Exécuter cette commande. La sortie fait-elle apparaître le résultat de cette commande ?
Afin de vérifier que les informations ont bien été ajoutées à la base de données, ajouter la commande suivante dans le fichier main.sql
SELECT*FROMCelebrites;
Exécuter cette commande.
Ajouter maintenant au fichier celebrites.sql toutes les commandes permettant de peupler la base de données.
Exécuter ces commandes.
La base de données réside toujours en mémoire et n’a, pour l’instant, pas été sauvegardée dans un fichier. Ajouter la commande suivante à la fin du fichier celebrites.sql
.save"cinema.sqlite"
Vérifier que le fichier cinema.sqlite a bien été créé.
Info
Désormais, à la prochaine utilisation de la base de données il ne sera plus nécessaire de relancer toute la création de la base de données (ce qui pourrait être très très long dans le cas d’une base conséquente) mais seulement la commande
.open"cinema.sqlite"
au début du fichier main.sql (qui ne devra alors plus lire le fichier celebrites.sql).
Premières requêtes : Projection
Avertissement
Toutes les commandes à venir devront être entrées dans le fichier main.sql après la commande de lecture du fichier celebrites.sql (ou après la commande de lecture du fichier cinema.sqlite).
La commande SELECT * FROM Celebrites; est une requête. Que signifie le caractère * dans cette commande ?
Réponse
Le caractère * indique que l’on souhaite que la relation retournée par la commande SELECT contienne tous les attributs (champs).
À retenir
Une projection consiste à filtrer certains
attributs d’une relation. Le résultat d’une projection est une relation de
degré inférieur à celui de la relation de départ.
Adapter la commande précédente de façon à obtenir tous les noms des acteurs présents dans la base de données.
Réponse
SELECTNomFROMCelebrites;
Adapter la commande précédente de façon à obtenir tous les noms et sexes des acteurs présents dans la base de données.
Réponse
SELECTNom,SexeFROMCelebrites;
Premières requêtes : Sélection
Sélections simples
À retenir
La sélection consiste à filtrer des
enregistrements d’une relation en fonction d’une condition. Le
résultat d’une sélection est une relation de même degré mais de
cardinalité différente.
Une sélection s’effectue en langage SQL à l’aide de la clause WHERE.
Écrire la commande qui retourne toutes les informations relatives aux femmes présentes dans la base de données.
Réponse
SELECT*FROMCelebritesWHERESexe="Femme";
Adapter la commande précédente de façon à obtenir tous les noms et prénoms des femmes présentes dans la base de données.
Réponse
SELECTNom,prenomFROMCelebritesWHERESexe="Femme";
Opérateurs de comparaison
Quels sont les noms de tous les acteurs (sans distinction de sexe) qui n’ont pas pour pays d’origine les USA.
Réponse
SELECTNomFROMCelebritesWHEREPays!="USA";
Quels sont les noms des acteurs (sans distinction de sexe) qui ont plus de 40 ans ?
Réponse
SELECTNomFROMCelebritesWHEREAge>40;
Quels sont les noms et prénoms des acteurs (sans distinction de sexe) qui ont plus de 40 ans ?
Réponse
SELECTNom,PrenomFROMCelebritesWHEREAge>40;
Quels sont les noms des acteurs (sans distinction de sexe) qui ont au plus 36 ans ?
Réponse
SELECTNomFROMCelebritesWHEREAge<=36;
Quels sont les noms des actrices françaises ?
Réponse
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Donner le schéma relationnel de la base de données.
Afficher les noms de tous les sportifs.
Afficher les noms et prénoms de tous les sportifs.
Afficher les noms, prénoms et sports de tous les sportifs.
Afficher le nom des sportifs nés au mois de décembre.
Afficher les noms et prénoms des sportifs nés en juin.
Afficher les noms et prénoms des sportifs nés en 1981.
Afficher les noms et prénoms des sportifs pratiquant le football.
Instagram
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Donner le schéma relationnel de la base de données.
Afficher toutes les informations relatives aux utilisateurs qui ne sont pas des footballeurs.
Afficher toutes les informations relatives aux utilisateurs qui ont plus de 200 million followers.
Afficher toutes les informations relatives des utilisateurs qui ont au plus 200 million followers.
Afficher toutes les informations relatives des utilisateurs qui ont au moins 200 million followers.
Afficher les prénoms, noms et « Instagram handle » des comptes qui ont au maximum 155 millions de followers.
Afficher toutes les informations pour les comptes qui correspondent à des chanteurs et qui ont plus de 200 millions de followers.
Afficher toutes les informations pour les comptes qui correspondent à des footballeurs ou qui ont moins de 150 millions de followers.
Première requêtes : Ordres SQL
Info
On reprend, dans cette partie, l’étude de la relation Celebrites.
À retenir
L’opérateur ORDER BY est utilisé pour trier le résultat d’une projection. Par défaut ce tri s’effectue par ordre croissant (lexicographique ou numérique). Pour trier par ordre décroissant, il faut ajouter le mot clé DESC, pour trier par ordre croissant on utilise ASC.
Rechercher toutes les informations sur les acteurs, triées par age croissant.
Réponse
SELECT*FROMCelebritesORDERBYAge;
Rechercher toutes les informations sur les acteurs, triées par pays d’origine (par ordre décroissant).
Réponse
SELECT*FROMCelebritesORDERBYPaysDESC;
Rechercher les noms et prénoms des acteurs triés par age et nom croissants.
Réponse
SELECTNom,PrénomFROMCelebritesORDERBYAge,Nom;
Rechercher les noms et prénoms des acteurs triés par age décroissant et nom croissant.
Réponse
Rechercher les noms et prénoms des acteurs dont le pays d’origine commence par un a.
Réponse
SELECTNom,PrenomFROMCelebritesWHEREPaysLIKE'a%';
Rechercher les noms et prénoms des acteurs dont le pays d’origine se termine par un l.
Réponse
SELECTNom,PrenomFROMCelebritesWHEREPaysLIKE'%l';
Rechercher les noms et prénoms des acteurs dont le pays d’origine comporte un a.
Réponse
SELECTNom,PrenomFROMCelebritesWHEREPaysLIKE'%a%';
Exercice d’application : base Animaux
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Rechercher toutes les informations sur les animaux dont le nom commence par la lettre p.
Rechercher toutes les informations sur les animaux dont le nom se termine par la lettre e et qui sont En danger.
Rechercher toutes les informations sur les animaux dont le nom comporte la lettre a et qui sont Vulnérable. Le résultat doit être trié par nom (ascendant).
Afficher le nom de tous les animaux et leur état de préservation.
Afficher le nom de tous les animaux vulnérables par ordre décroissant de la vitesse de déplacement.
Afficher le nom et la durée de vie moyenne des animaux dont le nom comporte un e. L’affichage doit être effectué par durée de vie moyenne croissante.
Afficher les nom, durée de vie moyenne et vitesse de déplacement des animaux dont le nom comporte un o, par vitesse de déplacement décroissante.
Modification des entrées d’une base de données
Info
On reprend, dans cette partie, l’étude de la relation Celebrites.
À retenir
L’ordre UPDATE permet de modifier un enregistrement dans une table. La clause WHERE est utilisée pour sélectionner l’enregistrement.
Faire en sorte que l’age de l’actrice Margot Robbie soit égal à 29 ans.
Réponse
UPDATECelebritesSETAge=29WHERENom="Robbie";
Vérifier que la modification a bien été effectuée.
Modifier le fichier contenant la base de données de façon à ce que la modification, uniquement effectuée en mémoire vive pour l’instant, soit enregistrée de façon permanente.
Le vrai nom de Tom Cruise est Thomas Cruise Mapother IV. Modifier l’entrée dans la base de données.
Réponse
L’ordre DELETE permet de supprimer un enregistrement d’une table. Si aucune clause WHERE n’est utilisée, tous les enregistrements de la table sont supprimés.
Supprimer l’acteur Tom Holland de la table Celebrites.
Réponse
DELETEFROMCelebritesWHERENom="Holland";
Exercice d’application : base Superhereos and Villains
Écrire toutes les commandes correspondant au requêtes ci-dessous pour la base de donnée se trouvant à
cette adresse
Écrire une requête qui affiche tous les enregistrements de la table « Superheroes and Villains ».
Écrire une requête qui affiche la structure de la table « Superheroes and Villains ».
Écrire une requête qui affiche les noms des superheroes femmes.
Écrire une requête qui affiche les noms et types (gentil ou méchant) des films X-Men ou Guardians of the Galaxy.
Écrire une requête qui affiche tous les noms des personnages par ordre alphabétique.
Écrire une requête qui affiche les types des personnages et leurs noms par ordre alphabétique croissant pour les types mais ordre alphabétique décroissant pour les noms.
Écrire une requête qui affiche les noms des personnages commençant par la lettre M.
Écrire une requête qui affiche les noms des personnages se terminant par la lettre N.
Écrire une requête qui affiche les noms des personnages contenant la lettre I.
Écrire une requête qui modifie le nom du personnage Groot. Le nouveau nom est Baby Groot. Afficher le résultat de cette requête.
Écrire une requête qui supprime l’enregistrement dont le nom est Queen of Hearts. Afficher la table pour vérifier le résultat de la requête.
Exercice d’application à partir de données réelles et conséquentes
La base de donnée contient tous les indicateurs des lycées français présentés sur le site de l’éducation nationale et dont les données sont en accès “libre” sur
data.gouv.fr
. La notice descriptive est fournie.
Écrire 10 requêtes qui vous semblerons utiliser au mieux cette base de données.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Le langage SQL : Le langage de manipulation de données (LMD), Compléments
Notion de clé d’une relation et dépendance fonctionnelle
Lorsqu’on utilise une base de données, il est nécessaire d’accéder à un
enregistrement par le contenu d’un ou de plusieurs champs. On nomme
clé d’une relation un champ, ou un ensemble de champs, qui permet
d’identifier de façon unique un enregistrement. Une relation peut
comprendre plusieurs clés possibles ; ce sont les clés candidates.
À retenir
On appelle clé primaire d’une relation la clé
minimale parmi toutes les clés candidates de la relation. Une clé
primaire doit toujours contenir une valeur et celle-ci doit être unique
pour chacun des enregistrements de la relation
Pour désigner une clé (primaire), il faut donc prendre en compte le «
sens » des données contenues dans la relation. Si aucun champ ne peut
constituer une clé, il est nécessaire d’introduire un champ formel, tel
qu’un identifiant numérique.
À retenir
Une dépendance fonctionnelle existe entre deux
ensembles de champs si les valeurs contenues dans l’un des ensembles de
champs permettent de déterminer les valeurs contenues dans l’autre
ensemble.
Les dépendances fonctionnelles expriment la relation de hiérarchie qui
existe entre les champs.
Si l’on examine les données de la relation, on remarque :
qu’il ne peut y avoir de dépendance fonctionnelle entre les
ensembles (Ville, Etablissement) et (Nom, Age). En effet, le couple
(Laurence, 34) correspond aux deux couples (Paris, Université de
Jussieu) et (Bordeaux, Université Victor Segalen).
À un couple (Ville, Etablissement) ne correspond donc pas un unique
couple (Nom, Age).
que si l’on suppose qu’un établissement n’est situé que dans une
seule ville, il existe une dépendance fonctionnelle entre le champ «
Etablissement » et le champ « Ville ».
À une valeur du champ « Etablissement » correspond une et une seule
valeur du champ « Ville ». Cette valeur n’est cependant pas unique.
La valeur du champ « Numero_carte » est unique pour chacun des
enregistrements. Ses valeurs sont identifiantes pour tous les champs
de la relation. Chaque champ dépend fonctionnellement de ce champ.
Ses valeurs ne sont jamais vides, c’est une clé candidate !
Comme c’est aussi la seule clé de la relation, ce champ constitue la
clé primaire.
Tous les champs qui ne font pas partie d’une clé candidate d’une
relation possèdent des dépendances fonctionnelles avec cette clé.
À retenir
On indique la clé primaire d’un schéma relationnel en soulignant le
champ, dans le schéma relationnel : Relation lecteur(Numero_carte, Nom, Age, Ville,
Etablissement)
Jointure de deux relations
Qu’est-ce qu’une jointure ?
À retenir
La jointure est l’opération fondamentale de l’algèbre relationnelle
qui permet d’exprimer le sens du lien entre les relations, dans le monde
réel. Conformément au programme, on ne présente ici que l’opération de
jointure symétrique.
À retenir
Une jointure permet d’associer plusieurs
relations dans une même requête. Le résultat de cette requête est une
relation de degré supérieur aux degrés de chacune des relations de
départ. L’opération de jointure est symétrique et associative.
La liaison entre les relations s’effectue par le contenu commun d’un
champ (champs de jointure).
Info
Il est bien évidemment possible d’associer une jointure à une
projection et une sélection. Ces associations doivent être prises en
compte lors de la détermination du degré et de la cardinalité de
la relation finale.
Même si l’on ne dispose pas du modèle conceptuel associé, on constate
que l’on peut relier les deux relations par le champ Numero_Etablissement. Les
informations concernant l’établissement de la relation Lecteur_bis sont
stockées dans la relation Etablissement dont la clé est le champ Num_Etablissement. Pour
obtenir la liste des lecteurs ainsi que les informations concernant leur
établissement, on effectue une jointure entre ces relations sur le champ
Numero_Etablissement.
Schéma de la base de données prenant en compte la jointure : Dans la
relation l’attribut est une clé étrangère.
Numero_carte
Nom
Num_Etablissement
Num_Etablissement
Ville
Nom_Etablissement
      1             Henri               1                       1               Paris      Université Jussieu
      2           Stanislas             2                       2               Lyon            CHU Bron
      3           Henriette             1                       1               Paris      Université Jussieu
Résultat de la jointure des relations Lecteur_bis et Etablissement.
Le champ Num_Etablissement figure deux fois dans la relation résultat de la jointure
car la première occurrence provient de la relation Lecteur_bis alors que la
seconde provient de la relation Etablissement.
Afin de ne conserver qu’une occurrence des champs de jointure, on
peut réaliser une projection :
Numero_carte
Nom
Num_Etablissement
Ville
Nom_Etablissement
      1             Henri               1               Paris      Université Jussieu
      2           Stanislas             2               Lyon            CHU Bron
      3           Henriette             1               Paris      Université Jussieu
Résultat de la jointure des relations Lecteur_bis et Etablissement après projection.
Cette opération, jointure+projection, est parfois
appelée jointure naturelle.
Les champs de jointure ne doivent pas nécessairement être nommés à
l’identique.
Comment effectuer une jointure en langage SQL ?
Il existe deux façons de réaliser une opération de jointure en SQL :
la première est basée sur l’idée qu’une opération de jointure
peut être considérée comme une sélection sur le produit
cartésien des deux relations :
On remarque qu’un champ est défini de façon unique grâce à la concaténation du nom de la relation et de celui du champ. Si les champs portent des noms différents, il n’est pas nécessaire de préciser de quelle relation ils sont issus.
Fonctions de calculs
Une règle, dans le domaine des bases de données, est que tout ce qui
peut se calculer ne doit pas être stocké dans la base. On évite ainsi
la perte de place et l’incohérence qui peut découler du stockage
d’informations redondantes.
Le langage SQL ne possède pas d’instruction d’itération ; il possède
cependant des fonctions simples de traitement des données d’une
colonne (les calculs plus complexes doivent être effectués à l’aide
d’un langage de programmation comme Python).
Fonction
Opération
COUNT
Comptage du nombre d’enregistrements de la table
MAX
Maximum des éléments d’une colonne
MIN
Minimum des éléments d’une colonne
AVG
Moyenne des éléments d’une colonne
SUM
Somme des éléments d’une colonne
Exemples
Détermination de l’age moyen des lecteurs
SELECTAVG(Age)ASAge_MoyenFROMlecteur;
Comptage du nombre de lecteurs
SELECTCOUNT(*)ASNombre_LecteursFROMlecteur;
Dans le cas de la fonction , il n’est pas nécessaire de préciser le champ puisque cette fonction s’applique à la relation toute entière.
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
Gestion d'une salle de cinéma
L’objectif de cette séance est de mettre en œuvre tous les concepts du chapitre.
La base de donnée accessible à
cette adresse
simule de façon simplifiée la gestion d’un cinéma.
Étudier la structure de chacune des relations de la base et établir son schéma relationnel.
En particulier, faire apparaître les clés primaires et les clés étrangères.
Réponse
Quelles sont les tables de la base ?
.tables
Quelle est la structure de chacune de ces relations ?
On souhaite maintenant ajouter l’attribut tarif à la relation projection. Exécuter la commande suivante :
ALTERTABLEprojectionADDtariffloat;
Vérifier que la structure de la relation projection a bien été modifiée.
On fait la supposition que le tarif des films dépend du film, de la salle, de la séance et de la date de projection. Le tarif exprime le tarif de base.
Mettre à jour la table projection en fixant un tarif de base à 5 € pour la salle nord, 8 € pour la salle centrale, 6.5 € pour la salle sud.
Réponse
Mettre à jour la table projection en ajoutant 1 € au prix des films dont les séances sont à 14h50 et 2 € au prix des films dont les séances sont à 19h30.
Réponse
A crime has taken place and the detective needs your help. The detective gave you the crime scene report, but you somehow lost it. You vaguely remember that the crime was a murder that occurred sometime on Jan.15, 2018 and that it took place in SQL City. All the clues to this mystery are buried in a huge database, and you need to use SQL to navigate through this vast network of information. Your first step to solving the mystery is to retrieve the corresponding crime scene report from the police department’s database. Take a look at the SQL reference to learn how to do this! From there, you can use your SQL skills to find the murderer.
If you’re new to SQL, you may want to start at our
walkthrough
. It won’t teach you everything about SQL, but it should teach you all that you need to solve the mystery.
Entity Relationship Diagram of the database
Checking the Solution
Write the following queries in your SQL environment to check whether you’ve found the right murderer:
INSERTINTOsolutionVALUES(1,"Insert the name of the person you found here");SELECTvalueFROMsolution;
Physique, Chimie et Informatique > Terminales Spé. NSI > Bases de données
La base de données correspond à la modélisation d’emprunt de livres dans un CDI :
Chaque élève d’un lycée peut emprunter des livres au CDI, les données concernants ces livres et les emprunts en cours sont stockés dans une base de données.
Les auteurs ainsi que les éditeurs figurent également dans cette base.
Travail préalable
Déterminer la structure de la base de données et indiquer son schéma relationnel.
Requêtes simples
Donner le code SQL de chacune des requêtes suivantes.
Afficher tous les noms des auteurs.
Afficher le titre de tous les livres.
Afficher les noms des classes du lycée sans doublon.
Afficher les titres des livres et les annees d’édition classés selon les années.
Quels sont les livres dont le titre contient le mot Astérix ?
Expressions et fonctions
Donner le code SQL de chacune des requêtes suivantes.
Afficher les noms et prénoms des élèves de la classe 1-G1.
Afficher les titres des livres publiés après 2000.
Afficher les isbn des livres dont la date retour est déjà passée (au 25 octobre 2020).
Combien d’auteurs sont présents dans la base de données ?
Quelle est l’annee d’édition du ou des livre(s) le(s) plus ancien(s) ?
Requêtes imbriquées
Donner le code SQL de chacune des requêtes suivantes.
Afficher les titres des livres empruntés.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre avec une date retour dépassée (au 25 octobre 2020).
Quels sont les editeurs à avoir édité un livre contenant Astérix dans le titre ?
Quel est le titre du ou des livre(s) le(s) plus ancien(s) ?
Jointures
Donner le code SQL de chacune des requêtes suivantes en utilisant la clause JOIN.
Afficher les titres des livres empruntés.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre.
Afficher, sans doublon, le nom et prénom des élèves qui ont emprunté au moins un livre avec une date retour dépassée (au 25 octobre 2020).
Qui est l’auteur du livre 1984 ?
Afficher les titres des livres écrit par Pierre Boulle.
Combien de livres ont été écrit par Isaac Asimov ?
Afficher les noms des editeurs ayant édité un écrit par Barjavel.